Codage des informations logistiques
Qu’est-ce que le codage des informations logistiques ?
Le codage des informations logistiques consiste à attribuer et à utiliser des identifiants structurés, des codes de classification et des valeurs de données convenues pour représenter des informations sur les marchandises, les emplacements, les unités logistiques, les expéditions et les activités logistiques. Dans l’entreposage, le transport, le commerce électronique et le commerce international, il permet aux personnes et aux systèmes d’information de faire référence aux mêmes objets et d’interpréter les informations opérationnelles de manière cohérente.
Ce terme doit être compris comme une description générale d’une pratique de gestion des données, et non comme le nom d’une norme de codage universelle unique. Une application donnée peut utiliser des codes d’entrepôt internes, des identifiants normalisés au niveau international, des numéros de suivi propres à un transporteur, des codes de classification douanière, ou plusieurs de ces éléments à la fois. Leur signification et leurs règles dépendent du système qui les régit.
Ici, le codage signifie représenter des informations au moyen de symboles et de valeurs définis. Il ne signifie pas principalement écrire des logiciels, chiffrer des enregistrements ou imprimer des codes-barres, même si les logiciels et la technologie des codes-barres peuvent soutenir ce processus.
Ce que représentent les codes logistiques
Une opération logistique doit distinguer plusieurs éléments : la nature d’un produit, l’unité physique manipulée, son emplacement, le document commercial ou de transport auquel elle est rattachée, ainsi que ce qui lui est arrivé. Ces questions sont liées, mais elles n’utilisent pas nécessairement le même identifiant.
Le tableau suivant regroupe les codes selon leur objectif. Il s’agit de regroupements explicatifs et non d’une classification formelle des normes de codage des informations logistiques.
| Objectif | Ce que représente le code | Exemple | Limite importante |
|---|---|---|---|
| Identification du produit | Un produit ou un article commercial | Une unité de gestion des stocks interne ou un Global Trade Item Number de GS1 | Un identifiant de produit ne distingue pas nécessairement les unités physiques individuelles. |
| Identification de l’unité logistique | Une unité constituée pour le transport ou le stockage | Un Serial Shipping Container Code de GS1 attribué à une palette | L’identifiant ne constitue pas en lui-même une liste du contenu de l’unité. |
| Identification de l’emplacement | Un emplacement commercial ou un autre emplacement défini | Un Global Location Number de GS1 ou un code interne d’emplacement d’entrepôt | Les différents systèmes d’emplacements fonctionnent à des niveaux de détail différents. |
| Référence d’expédition ou de colis | Un mouvement de transport, un dossier d’expédition ou un colis dans un système donné | Un numéro de suivi émis par un transporteur | Sa portée et sa relation avec les autres dossiers dépendent de l’émetteur. |
| Classification des marchandises | Une catégorie de marchandises pour un objectif défini | Un code de classification du Système harmonisé | Un code de classification n’est pas un identifiant unique de produit ou de colis. |
| État opérationnel | Une condition définie ou une catégorie d’événement | Une valeur interne documentée pour la réception ou l’expédition | Des valeurs identiques en apparence peuvent avoir des significations différentes selon les systèmes. |
Identifiants, classifications et supports de données
Les identifiants distinguent les dossiers ou les objets
Un identifiant répond à une question telle que : « De quel article, emplacement ou unité logistique s’agit-il ? » Son unicité doit être comprise dans le cadre attribué. Un code produit interne peut être unique uniquement dans le catalogue d’un détaillant, tandis qu’un système d’identification normalisé possède ses propres règles d’attribution destinées à permettre son utilisation entre organisations.
Les clés d’identification GS1 illustrent cette distinction. Le Global Trade Item Number, ou GTIN, identifie les articles commerciaux ; le Serial Shipping Container Code, ou SSCC, identifie les unités logistiques ; et le Global Location Number, ou GLN, identifie les parties et les emplacements. Ces clés ne sont pas interchangeables simplement parce qu’elles peuvent toutes apparaître dans des dossiers logistiques.
Les codes de classification décrivent des catégories
Un code de classification répond à la question : « À quelle catégorie cet élément appartient-il ? » Le Système harmonisé de l’Organisation mondiale des douanes, ou SH, fournit une nomenclature internationale pour classer les marchandises échangées. Ses sous-positions internationales utilisent des codes à six chiffres, tandis que les nomenclatures tarifaires nationales ou régionales peuvent ajouter d’autres subdivisions.
Plusieurs produits peuvent appartenir à la même catégorie du SH. Par conséquent, un code SH ne peut pas remplacer un identifiant de produit, un numéro de série ou un numéro de suivi. La sélection d’une classification douanière nécessite également des informations sur les marchandises ; le seul format d’un code valide ne suffit pas à établir que la classification est correcte.
Les supports de données encodent les informations pour leur capture
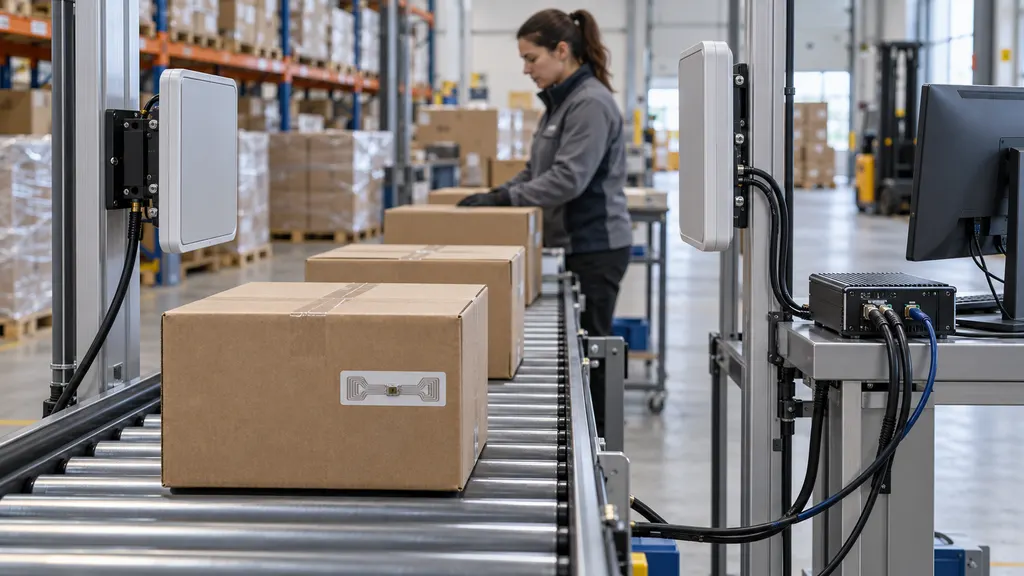
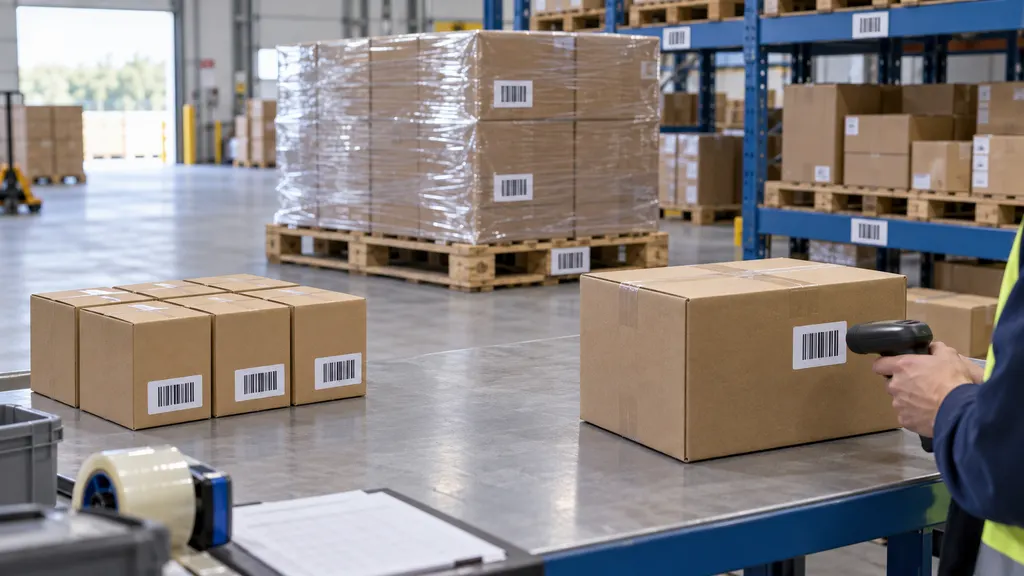
Un code-barres ou une étiquette d’identification par radiofréquence est un moyen de transporter des données, et non la même chose que l’identifiant qu’il contient. Un code-barres peut encoder un identifiant et, lorsque la norme applicable l’autorise, des données supplémentaires telles qu’une référence de lot ou une date d’expiration. La lecture de ce code-barres capture les valeurs encodées ; un système connecté peut ensuite récupérer les dossiers associés.
Cette distinction explique pourquoi le scan d’une étiquette ne révèle pas nécessairement tous les détails d’une expédition. Le contenu, la propriété, les instructions de manutention et l’historique des événements peuvent être stockés dans des bases de données liées à l’identifiant plutôt qu’intégrés à l’étiquette.
Fonctionnement du codage des informations logistiques
- Définir l’objet ou le champ d’information. Déterminer si le code identifie un produit, une unité individuelle, une unité logistique, un emplacement, un document ou une catégorie d’événement. Des définitions ambiguës peuvent entraîner l’utilisation d’un même code à des fins incompatibles.
- Choisir le système de référence. Déterminer si le processus commercial nécessite une norme externe reconnue, l’identifiant d’un partenaire commercial ou un code interne. Une référence interne d’emplacement d’entrepôt peut suffire localement, tandis qu’une collaboration externe peut nécessiter un système d’identification partagé.
- Préciser les règles d’attribution et de validation. Documenter les caractères autorisés, la longueur du champ, l’autorité d’attribution, les exigences d’unicité et les éventuelles règles de chiffres de contrôle. Les règles doivent provenir du système sélectionné et non d’un format universel supposé.
- Relier le code à un dossier. Enregistrer la relation entre l’identifiant et les informations pertinentes, telles que les attributs du produit, le contenu de la palette, les détails de l’emplacement ou les références d’expédition.
- Capturer et échanger les informations. Le personnel ou l’équipement automatisé peut lire une étiquette, saisir une référence ou recevoir un message d’un autre système. L’application réceptrice doit comprendre à la fois la valeur et le type d’identifiant.
- Gérer les relations et les changements. Enregistrer l’emballage, le déballage, le déplacement, la correction et les autres événements pertinents sans perdre la distinction entre les identifiants ni écraser silencieusement des relations importantes.
Les Electronic Product Code Information Services de GS1, ou EPCIS, fournissent une norme pour créer et partager des données d’événements de visibilité entre applications et organisations. Cela illustre une limite importante : identifier un objet et enregistrer ce qui lui est arrivé sont des fonctions distinctes mais liées. Un code seul ne constitue pas un historique complet de suivi.
Utilisation dans le commerce électronique et la logistique transfrontalière
Dans un flux de travail de commerce électronique donné à titre d’exemple, un détaillant peut utiliser un SKU interne pour gérer les stocks et un GTIN pour identifier un article commercial dans des dossiers produits partagés. Lorsque les marchandises sont emballées sur une palette, un SSCC peut identifier cette unité logistique. Le système de l’entrepôt peut alors associer la palette à son contenu et au dossier d’expédition concerné.
Lorsqu’une commande est expédiée, le transporteur peut attribuer un numéro de suivi. Le détaillant doit conserver la relation entre la commande, les articles expédiés et la référence du transporteur. Ces relations ne doivent pas être supposées être univoques : une commande peut être répartie entre plusieurs colis, et une unité logistique regroupée peut contenir des marchandises associées à plusieurs commandes.
Pour un transport transfrontalier, des systèmes de codage supplémentaires peuvent servir des objectifs distincts. Un code SH classe les marchandises à des fins douanières, tandis que UN/LOCODE identifie les emplacements utilisés dans le commerce et le transport. UN/LOCODE est géré par la Commission économique des Nations unies pour l’Europe et ne doit pas être confondu avec un code d’emplacement d’entrepôt ou une adresse de livraison complète.
Les retours introduisent une autre relation. Une référence d’autorisation de retour, un numéro de commande original et un numéro de suivi du retour peuvent faire référence à des dossiers différents. Les définir séparément permet à une entreprise de relier le mouvement de retour à la vente initiale sans considérer l’arrivée d’un colis comme la preuve qu’un remboursement a été effectué.
Qualité des données et interopérabilité
L’utilisation de codes ne rend pas automatiquement les systèmes interopérables. Deux applications peuvent échanger la même chaîne de caractères tout en l’interprétant différemment. Un échange fiable nécessite un accord sur le type d’identifiant, l’émetteur, la portée et les définitions des données associées.
- Préserver le format prévu. Traiter les identifiants comme des chaînes lorsque cela est nécessaire. La conversion par un tableur ou le stockage numérique peuvent supprimer les zéros initiaux et modifier la valeur originale.
- Enregistrer le type d’identifiant. Conserver les identifiants de produits, les numéros de suivi, les codes d’emplacement et les codes de classification dans des champs clairement définis plutôt que dans un champ « code » indifférencié.
- Vérifier l’unicité dans la portée appropriée. Une valeur unique dans les dossiers d’une entreprise peut entrer en conflit avec une valeur attribuée ailleurs.
- Séparer les contrôles de format des contrôles métier. Une valeur peut respecter les exigences de longueur ou de chiffre de contrôle tout en étant attribuée au mauvais produit, à la mauvaise expédition ou au mauvais emplacement.
- Documenter les correspondances. Lorsqu’un état interne est traduit dans l’état d’un partenaire, identifier les significations qui correspondent et les endroits où la traduction perd des détails.
- Contrôler les modifications des données de référence. Conserver les versions, définitions et historiques des modifications applicables aux listes de codes afin que les transactions historiques restent interprétables.
- Vérifier les relations entre le physique et le numérique. Une étiquette lisible n’est utile que si elle est attachée à l’objet prévu et liée à un dossier exact.
Ces contrôles traitent différents modes de défaillance. Une étiquette endommagée est un problème de capture ; un identifiant en double est un problème d’attribution ; et une association incorrecte entre une palette et son contenu est un problème de relation. Traiter les trois comme de simples « erreurs de code-barres » masque leurs causes.
Malentendus courants
Il n’existe pas de code unique adapté à tous les objectifs logistiques. L’identification des produits, le suivi des expéditions, l’identification des emplacements et la classification douanière répondent à des questions différentes. Regrouper leurs dossiers est utile, mais remplacer l’un par l’autre peut supprimer une signification essentielle.
Un code ne décrit pas nécessairement son objet. Certains systèmes contiennent des composants structurés, mais de nombreux identifiants servent principalement de clés de recherche. Sans documentation, les utilisateurs ne doivent pas déduire l’origine, la destination, la propriété ou le contenu d’un produit à partir d’un code inconnu.
Le codage ne garantit ni la visibilité ni la sécurité. Un identifiant peut relier des dossiers, mais la visibilité dépend également de la capture des événements et de l’échange autorisé des données. De même, représenter des informations dans un code-barres ne les chiffre pas et ne prouve pas que l’étiquette est authentique.
FAQ
Le codage des informations logistiques est-il identique à l’étiquetage par code-barres ?
Non. Le codage définit les valeurs et leur signification. L’étiquetage par code-barres est une manière de placer ces valeurs sur un objet afin de permettre leur lecture automatique. Les mêmes informations peuvent également être échangées électroniquement.
Quelle est la différence entre un SKU, un GTIN et un SSCC ?
Un SKU est une référence interne de stock. Un GTIN identifie un article commercial selon les règles de GS1. Un SSCC identifie une unité logistique, telle qu’une palette constituée pour le transport ou le stockage.
Un code SH peut-il être utilisé pour suivre une expédition ?
Non. Un code SH classe les marchandises au lieu d’identifier une expédition particulière. Le suivi d’une expédition nécessite une référence d’expédition ou de colis pertinente ainsi que les informations d’événements associées.
Chaque code logistique doit-il être unique à l’échelle mondiale ?
Non. La portée requise dépend de son objectif et du système qui le régit. Un code interne peut suffire dans un système, mais son échange externe nécessite un accord clair sur son émetteur et sa signification.
Sources
- GS1 : clés d’identification — Étaye les objectifs distincts du GTIN, du SSCC et du GLN.
- GS1 : codes-barres — Étaye la distinction entre les identifiants, les données supplémentaires et les supports de données lisibles par machine.
- GS1 : EPCIS — Étaye l’explication de l’échange normalisé de données d’événements de visibilité.
- Organisation mondiale des douanes : Qu’est-ce que le Système harmonisé ? — Étaye l’objectif et la structure internationale de la classification SH.
- UNECE : liste des codes UN/LOCODE par pays et territoire — Étaye l’utilisation de UN/LOCODE pour les emplacements commerciaux et de transport.