Escalabilidade da API de rastreamento: como lidar com o volume da alta temporada, limites de taxa e registro em massa
Para escalar uma API de rastreamento durante a alta temporada, coloque o registro de remessas atrás de uma fila durável, aplique os limites do provedor a todos os workers, use lotes apenas dentro dos limites documentados e processe as atualizações de rastreamento de forma assíncrona. Trate o volume de registros, o tráfego de novas tentativas e o processamento de webhooks como problemas de capacidade separados. Adicionar mais workers sem controlar as solicitações de saída pode aumentar o throttling em vez de reduzir o acúmulo.
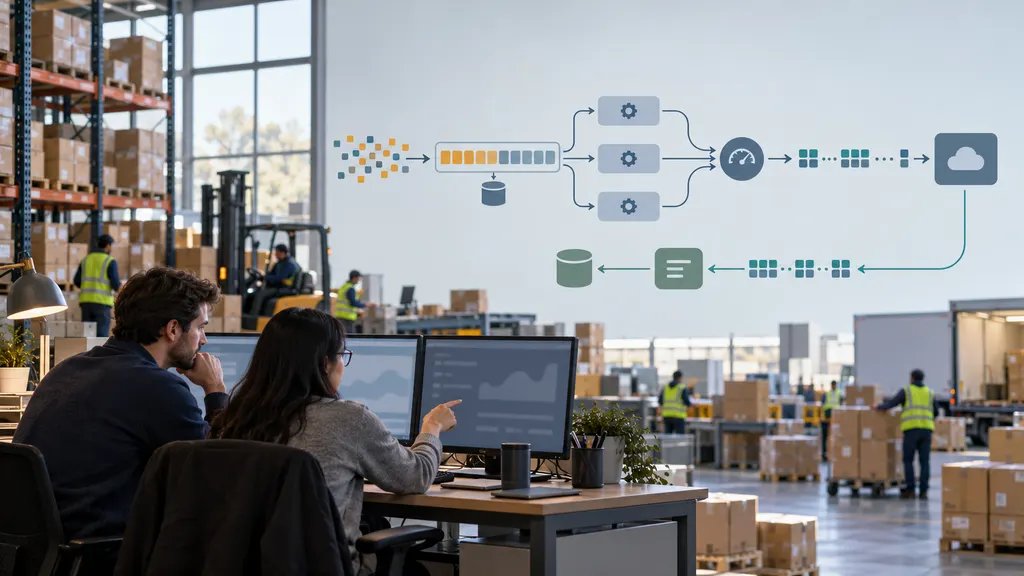
Para equipes de engenharia que conectam um sistema de gerenciamento de pedidos, uma plataforma de armazém ou um backend de comércio eletrônico a um serviço de rastreamento, o objetivo não é simplesmente enviar mais solicitações. É registrar as remessas dentro de uma janela de tempo definida, preservar as atualizações durante picos de tráfego e se recuperar de falhas sem criar trabalho duplicado.
Dimensione a carga em torno de remessas, solicitações e atualizações
O volume diário de remessas não é suficiente para dimensionar uma integração. Um armazém pode liberar a maioria dos seus números de rastreamento em uma janela curta de expedição, enquanto as atualizações de status chegam ao longo do dia. Modele essas cargas separadamente.
- Chegadas de registros: Novos registros de remessas que entram no sistema por segundo ou minuto, incluindo importações e picos de liberação do armazém.
- Tráfego de saída da API: Solicitações de registro, consultas, correções, chamadas de reconciliação e novas tentativas.
- Tráfego de atualizações de entrada: Entregas e reentregas de webhooks, quando o provedor as oferecer.
- Trabalho downstream: Gravações no banco de dados, notificações aos clientes, eventos analíticos e alterações de status dos pedidos acionadas por cada atualização.
Defina um objetivo interno de registro, como o tempo máximo aceitável entre o recebimento de um número de rastreamento e a confirmação do seu registro. Mantenha isso separado da atualidade do rastreamento: um registro bem-sucedido não significa que uma leitura da transportadora já esteja disponível.
Calcule a capacidade efetiva de registro
Para um endpoint de registro limitado por solicitações, uma relação útil para o planejamento é:
Capacidade de registro = solicitações permitidas por segundo × média de registros por solicitação × fração de registros bem-sucedidos
Esta é uma estimativa de planejamento, não uma garantia do provedor. Ela pressupõe que os limites de solicitações sejam a restrição determinante. Cotas baseadas em registros, tamanho do payload, latência e limites compartilhados da conta podem impor um teto menor.
Apenas para fins ilustrativos, suponha que uma integração possa fazer duas solicitações de registro por segundo e envie, em média, 30 registros em cada solicitação. Sua capacidade nominal é de 60 registros por segundo antes de falhas e outras restrições. Se os registros recebidos tiverem média de 80 por segundo durante um pico sustentado, a fila crescerá aproximadamente 20 registros por segundo. Esses números são hipotéticos, não representam limites da 17TRACK.
Calcule também a capacidade de recuperação. Se novas chegadas continuarem à taxa λ e a capacidade efetiva de processamento for μ, um acúmulo existente de B registros levará aproximadamente B / (μ − λ) segundos para ser eliminado quando μ > λ. Se a capacidade de processamento não exceder as chegadas, o acúmulo não será eliminado nessas condições.
Confirme o que o provedor realmente limita
Um limite de taxa e uma franquia de uso resolvem problemas diferentes. Um limite de taxa controla a rapidez com que solicitações ou registros podem ser enviados. Uma franquia de uso pode controlar quanto de atividade de rastreamento uma conta pode consumir durante um período de cobrança ou de concessão. Permanecer abaixo de um deles não comprova conformidade com o outro.
Antes de definir a quantidade de workers, confirme os pontos a seguir na documentação do provedor e nos termos da sua conta:
- Se os limites se aplicam por conta, chave de API, endpoint, endereço IP ou outro escopo.
- Se a unidade contabilizada é uma solicitação, um registro de rastreamento ou outra operação.
- Se os endpoints compartilham um limite ou possuem franquias independentes.
- O número máximo de registros e o tamanho máximo do payload permitidos em uma solicitação.
- Como envios duplicados, registros inválidos e novas tentativas afetam o uso.
- Se as respostas expõem informações de throttling ou orientações para novas tentativas.
- Como o esgotamento da cota difere do throttling temporário.
Para uma integração com a 17TRACK, use a página oficial da Tracking API e a documentação da API como pontos de partida para essa configuração. Confirme o comportamento aplicável do endpoint e os limites da conta antes da implantação. As capacidades exemplificadas neste guia são ilustrações de arquitetura, não declarações sobre concessões, tamanhos de lote ou garantias de serviço da 17TRACK.
Coloque uma fila durável entre o processamento de pedidos e o registro
Não faça o checkout ou a conclusão do trabalho do armazém esperar que um provedor de rastreamento aceite um registro. Persista a remessa localmente, registre a tarefa de registro de forma durável e deixe os workers em segundo plano cuidarem do envio.
Um fluxo prático é:
- Salve a remessa e sua intenção de registro. Use um outbox transacional ou um design equivalente para evitar salvar o pedido e perder a tarefa em segundo plano.
- Valide e normalize as entradas. Preserve os números de rastreamento como strings, incluindo zeros à esquerda. Aplique a normalização específica da transportadora somente quando for justificada.
- Verifique se já existe um registro. Use uma identidade estável apropriada ao provedor e ao seu modelo de dados.
- Coloque os registros elegíveis na fila. Armazene a contagem de tentativas, o próximo horário elegível para nova tentativa e contexto suficiente para diagnóstico.
- Envie por meio de um limitador compartilhado. Adquira capacidade imediatamente antes da solicitação de saída.
- Persista os resultados por registro. Separe sucesso confirmado, falha que permite nova tentativa, rejeição permanente e resultados ambíguos.
Uma fila absorve um pico; ela não cria capacidade no provedor. Se o registro elegível mais antigo continuar envelhecendo, investigue a diferença entre a taxa de chegada e a capacidade de processamento em vez de simplesmente aumentar a quantidade de workers.
Coordene os limites entre os workers
Workers independentes não devem presumir que cada um pode consumir toda a franquia da conta. Use um limitador de taxa coordenado ou um dispatcher que distribua um orçamento compartilhado de solicitações. Inclua nesse orçamento importações agendadas, scripts operacionais e tarefas de reconciliação.
Taxa e concorrência são controles diferentes. O limitador controla a frequência com que as solicitações começam; um limite de concorrência controla quantas permanecem em andamento. Ambos são úteis quando a latência do provedor aumenta. Aumentar a concorrência pode ajudar uma carga limitada por latência, mas não pode ignorar um limite de taxa de saída.
Use registros em lote sem perder o controle por registro
Quando um endpoint permite vários registros por solicitação, o uso de lotes pode reduzir a sobrecarga de solicitações. Isso não reduz necessariamente o uso baseado em registros, e o maior lote permitido nem sempre é a melhor escolha operacional.
Crie lotes usando dois gatilhos: uma quantidade máxima de registros e um tempo máximo de espera. Envie quando qualquer um deles for atingido. Isso permite que períodos movimentados preencham os lotes com eficiência sem obrigar o tráfego de baixo volume a esperar indefinidamente.
- Respeite os limites do payload, além da quantidade de registros. Metadados opcionais podem fazer com que lotes do mesmo tamanho sejam muito diferentes em bytes.
- Mantenha um manifesto interno do lote. Registre quais identidades locais de remessas foram enviadas e associe corretamente cada resultado retornado.
- Inspecione os resultados no nível da aplicação. Uma resposta HTTP de sucesso, por si só, não prova que todos os registros foram aceitos.
- Repita apenas os registros que precisam de nova tentativa. Reenviar registros bem-sucedidos cria tráfego desnecessário e pode ter consequências de uso.
- Encaminhe falhas permanentes de validação para correção. Um payload inválido e inalterado não deve circular pela fila de novas tentativas.
Um timeout é especialmente importante: o provedor pode ter aceitado a solicitação mesmo que o cliente não tenha recebido a resposta. Marque esse resultado como ambíguo. Resolva-o por meio de um mecanismo de idempotência compatível, de uma regra documentada para registros duplicados ou de uma consulta de reconciliação, quando disponível. Não presuma que uma gravação que sofreu timeout falhou.
Separe o tráfego em tempo real das importações históricas
Um backfill não deve consumir toda a capacidade necessária para remessas recém-despachadas. Use filas separadas com agendamento ponderado ou reservas explícitas de capacidade. Permita que as importações usem a capacidade disponível, preservando uma alocação mínima para registros em tempo real. Aplique envelhecimento ou outra regra de justiça para que registros de menor prioridade sejam processados eventualmente.
Faça novas tentativas controladas, atrasadas e limitadas
HTTP 429 significa “Too Many Requests”. A RFC 6585 especifica que uma resposta 429 pode incluir um cabeçalho Retry-After. A RFC 9110 define o valor desse cabeçalho como uma data HTTP ou um atraso em segundos. Um cliente deve analisar os dois formatos, em vez de presumir que sempre será retornado um número inteiro.
Quando um atraso válido para nova tentativa for fornecido, não tente novamente antes de ele expirar. Quando não houver orientação, use exponential backoff limitado com jitter: aumente progressivamente o intervalo entre as tentativas e adicione aleatoriedade para que os workers não tentem novamente todos ao mesmo tempo. As novas tentativas devem passar pelo mesmo limitador de saída usado pelas primeiras tentativas.
Classifique as falhas antes de tentar novamente:
- Throttling: Atrase o trabalho afetado e reduza a pressão de envio dentro do escopo de limite relevante.
- Falhas transitórias de rede ou servidor: Tente novamente dentro de uma política limitada, considerando resultados ambíguos de gravações.
- Falhas de autenticação ou autorização: Emita um alerta e pause o trabalho afetado até que as credenciais ou permissões sejam corrigidas.
- Falhas de validação: Corrija ou isole o registro, em vez de reenviá-lo inalterado.
- Franquia esgotada: Siga a solução documentada para a conta, em vez de tratar isso como um breve pico de tráfego.
Defina tanto um limite de tentativas quanto uma idade máxima para novas tentativas. Mova os itens esgotados para uma fila de mensagens mortas com motivo, responsável e procedimento de reprocessamento. Caso contrário, falhas antigas podem consumir silenciosamente a capacidade destinada a novas remessas.
Escale a entrada de webhooks de forma independente
Quando o provedor oferece webhooks adequados, eles podem reduzir a consulta repetida de status. Eles também criam uma carga de entrada separada, que deve permanecer disponível durante picos de atualizações.
Mantenha o endpoint receptor focado: valide a solicitação usando o mecanismo documentado pelo provedor, armazene o evento de forma durável e retorne a confirmação exigida. Processe alterações de pedidos, análises e mensagens aos clientes de forma assíncrona. Não confirme o recebimento antes da aceitação durável se isso puder causar a perda do evento.
Projete os consumidores para tolerar entregas duplicadas, a menos que o contrato do provedor estabeleça explicitamente o contrário. Prefira um identificador de evento estável e documentado para deduplicação. Se ele não existir, projete e teste cuidadosamente uma identidade composta: usar apenas um rótulo de status pode juntar eventos distintos em um só.
Proteja-se também contra atualizações fora de ordem. Armazene o histórico de eventos separado do estado atual derivado da remessa. Aplique os carimbos de data e hora dos eventos e as regras de transição documentadas, quando disponíveis; não presuma que a ordem de chegada seja a ordem dos eventos ou que os status das remessas formem uma sequência universalmente crescente.
Mantenha a reconciliação direcionada e limitada por taxa. Ela pode investigar suspeitas de falhas de entrega ou registros ambíguos, mas consultar agressivamente todas as remessas pode recriar a carga de saída que os webhooks deveriam evitar.
Teste a recuperação, não apenas o throughput máximo
Execute testes de carga nos seus próprios componentes usando um simulador do provedor. Coordene os testes que enviam tráfego significativo para um provedor ativo e permaneça dentro dos limites autorizados. Um teste bem-sucedido deve demonstrar que o sistema retorna ao normal após uma interrupção, não apenas que aceita um grande pico.
- Reproduza um pico semelhante ao de um armazém seguido por tráfego normal contínuo.
- Injete respostas de throttling, latência elevada e falhas temporárias do servidor.
- Simule rejeição parcial de lotes e um timeout após a aceitação no lado do servidor.
- Entregue eventos de webhook duplicados e fora de ordem.
- Interrompa o acesso ao banco de dados e verifique se os eventos não aceitos não são confirmados incorretamente.
- Execute um backfill junto com registros em tempo real e verifique a justiça.
- Reprocesse itens da fila de mensagens mortas sem ignorar os controles de taxa.
Monitore a idade do registro elegível mais antigo, a latência de aceitação, a taxa de sucesso por registro, a frequência de throttling, o volume de novas tentativas, o atraso no processamento de webhooks e o crescimento da fila de mensagens mortas. A profundidade da fila, sozinha, é insuficiente: uma fila grande pode ser esvaziada rapidamente, enquanto uma fila pequena pode conter algumas remessas críticas para o negócio que falham repetidamente.
Antes da alta temporada, atribua a responsabilidade operacional. A engenharia deve ser responsável pelos controles de envio e pelas ferramentas de recuperação; o responsável pela integração deve confirmar as concessões do provedor; as operações devem definir quais remessas recebem prioridade. Documente quando pausar importações, solicitar capacidade adicional ou investigar atualizações ausentes. O design mais sólido é aquele que permanece previsível quando o tráfego excede sua capacidade imediata de processamento.
FAQ
Adicionar chaves de API aumentará o throughput?
Não necessariamente. Várias chaves podem compartilhar uma franquia no nível da conta. Confirme com o provedor o escopo do limite e a abordagem de escalabilidade permitida. Não use rotação de chaves para contornar restrições.
Toda inscrição deve usar o maior lote possível?
Não. Lotes maiores podem melhorar a eficiência das solicitações, mas esperar para preenchê-los aumenta a latência em volumes baixos. Use um limite de tamanho documentado junto com um temporizador de envio e ajuste com base na latência de aceitação e no comportamento das falhas medidos.
Como evitar registros duplicados após um timeout?
Use uma identidade durável da remessa local e o comportamento documentado do provedor para idempotência ou tratamento de duplicatas. Se o resultado continuar incerto, faça a reconciliação quando houver suporte antes de repetir o envio. A deduplicação local, por si só, não pode provar se uma solicitação remota foi bem-sucedida.
Um registro bem-sucedido significa que as informações de rastreamento estão atualizadas?
Não. A aceitação do registro, a disponibilidade do evento da transportadora, o processamento do provedor e o processamento das suas próprias atualizações são etapas separadas. Meça-as separadamente para que uma leitura atrasada da transportadora não seja confundida com um acúmulo de registros.
Quando uma equipe deve solicitar mais capacidade ao provedor?
Solicite-a quando as chegadas previstas e o tempo de recuperação necessário excederem a capacidade utilizável verificada, depois de eliminar novas tentativas evitáveis, envios duplicados e lotes ineficientes. Uma franquia maior não corrigirá um consumidor bloqueado ou um gargalo no banco de dados; portanto, identifique primeiro a restrição determinante.
Fontes
- 17TRACK Tracking API — ponto de entrada oficial para a oferta da API.
- Documentação da API da 17TRACK — referência para verificar requisitos de integração, comportamento dos endpoints e restrições de solicitações aplicáveis.
- RFC 6585, Seção 4: 429 Too Many Requests — semântica de throttling HTTP e orientação opcional sobre Retry-After.
- RFC 9110, Seção 10.2.3: Retry-After — formatos de data HTTP e segundos de atraso.
- RFC 9110, Seção 9.2.2: Métodos idempotentes — considerações sobre novas tentativas quando o resultado de uma solicitação é incerto.