Scalabilità dell’API di tracking: come gestire i volumi dell’alta stagione, i limiti di frequenza e la registrazione in blocco
Per scalare un'API di tracking durante l'alta stagione, inserisci la registrazione delle spedizioni dietro una coda durevole, applica i limiti del provider a tutti i worker, usa i batch solo entro i limiti documentati ed elabora gli aggiornamenti di tracking in modo asincrono. Considera il throughput della registrazione, il traffico dei tentativi e l'elaborazione dei webhook come problemi di capacità separati. Aggiungere altri worker senza controllare le richieste in uscita può aumentare il throttling invece di smaltire l'arretrato.
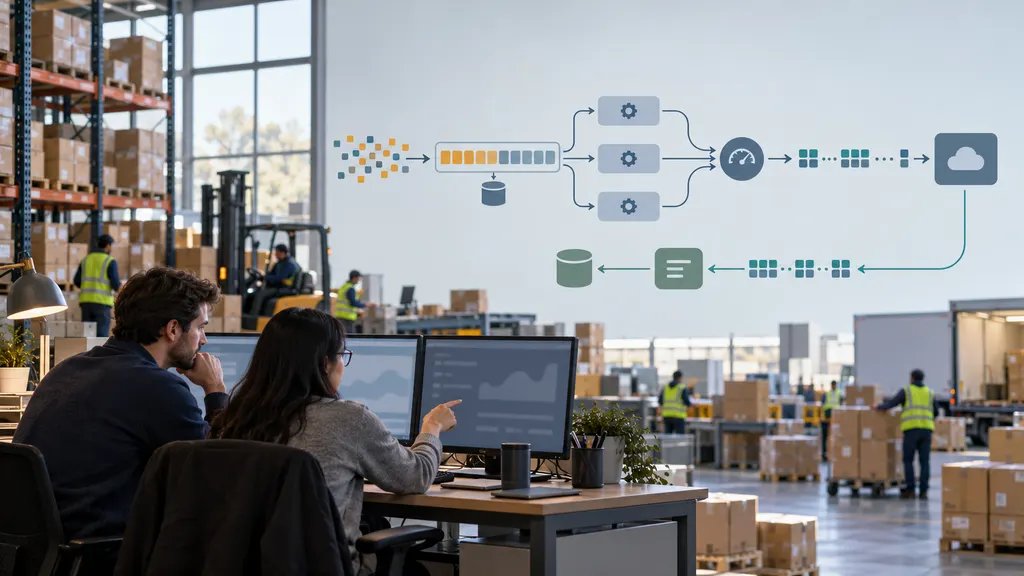
Per i team di ingegneria che collegano un sistema di gestione degli ordini, una piattaforma di magazzino o un backend ecommerce a un servizio di tracking, l'obiettivo non è semplicemente inviare più richieste. È registrare le spedizioni entro una finestra temporale definita, preservare gli aggiornamenti durante i picchi di traffico e recuperare dagli errori senza creare attività duplicate.
Dimensiona il carico in base a spedizioni, richieste e aggiornamenti
Il volume giornaliero delle spedizioni non è sufficiente per dimensionare un'integrazione. Un magazzino può rilasciare la maggior parte dei numeri di tracking in una breve finestra di spedizione, mentre gli aggiornamenti di stato arrivano durante tutta la giornata. Modella separatamente questi carichi di lavoro.
- Arrivi delle registrazioni: Nuovi record di spedizione che entrano nel sistema al secondo o al minuto, incluse le importazioni e i picchi dovuti al rilascio da parte del magazzino.
- Traffico API in uscita: Richieste di registrazione, ricerche, correzioni, chiamate di riconciliazione e tentativi.
- Traffico degli aggiornamenti in entrata: Consegne e riconsegne dei webhook, quando supportate dal provider.
- Attività downstream: Scritture nel database, notifiche ai clienti, eventi di analytics e modifiche allo stato degli ordini attivate da ciascun aggiornamento.
Definisci un obiettivo interno per la registrazione, ad esempio il tempo massimo accettabile tra la ricezione di un numero di tracking e la conferma della sua registrazione. Mantienilo separato dalla freschezza del tracking: una registrazione completata con successo non significa che una scansione del corriere sia già disponibile.
Calcola la capacità effettiva di registrazione
Per un endpoint di registrazione limitato in base alle richieste, una relazione utile per la pianificazione è:
Capacità di registrazione = richieste consentite al secondo × record medi per richiesta × frazione di record completati con successo
Questa è una stima di pianificazione, non una garanzia del provider. Presuppone che il limite delle richieste sia il vincolo determinante. Quote basate sui record, dimensione del payload, latenza e limiti condivisi dell'account possono imporre un tetto inferiore.
Solo a titolo illustrativo, supponiamo che un'integrazione possa effettuare due richieste di registrazione al secondo e invii in media 30 record per richiesta. La sua capacità nominale è di 60 record al secondo prima di considerare errori e altri vincoli. Se le registrazioni in entrata hanno una media di 80 record al secondo durante un picco prolungato, la coda cresce di circa 20 record al secondo. Questi valori sono ipotetici e non rappresentano i limiti di 17TRACK.
Calcola anche la capacità di recupero. Se i nuovi arrivi continuano alla velocità λ e la capacità di elaborazione effettiva è μ, un arretrato esistente di B record richiede circa B / (μ − λ) secondi per essere smaltito quando μ > λ. Se la capacità di elaborazione non supera gli arrivi, l'arretrato non si svuoterà in tali condizioni.
Conferma cosa limita effettivamente il provider
Un rate limit e una quota di utilizzo risolvono problemi diversi. Un rate limit controlla la velocità con cui è possibile inviare richieste o record. Una quota di utilizzo può controllare la quantità di attività di tracking che un account può consumare durante un periodo di fatturazione o di validità. Rimanere al di sotto di una non dimostra la conformità all'altra.
Prima di impostare il numero di worker, verifica quanto segue nella documentazione del provider e nei termini del tuo account:
- Se i limiti si applicano per account, chiave API, endpoint, indirizzo IP o altro ambito.
- Se l'unità conteggiata è una richiesta, un record di tracking o un'altra operazione.
- Se gli endpoint condividono un limite o dispongono di quote indipendenti.
- Il numero massimo di record e la dimensione massima del payload consentiti in una richiesta.
- In che modo gli invii duplicati, i record non validi e i tentativi influiscono sull'utilizzo.
- Se le risposte espongono informazioni sul throttling o indicazioni sui tentativi.
- In che modo l'esaurimento della quota differisce dal throttling temporaneo.
Per un'integrazione 17TRACK, utilizza la pagina ufficiale Tracking API e la documentazione API come punti di partenza per questa configurazione. Conferma il comportamento dell'endpoint applicabile e i limiti dell'account prima del deployment. Le capacità esemplificate in questa guida sono illustrazioni architetturali e non dichiarazioni relative alle autorizzazioni, alle dimensioni dei batch o alle garanzie di servizio di 17TRACK.
Inserisci una coda durevole tra l'elaborazione degli ordini e la registrazione
Non fare in modo che il checkout o il completamento delle attività di magazzino attendano che un provider di tracking accetti una registrazione. Salva localmente la spedizione, registra in modo durevole l'attività di registrazione e lascia che i worker in background gestiscano l'invio.
Un flusso pratico è:
- Salva la spedizione e l'intenzione di registrarla. Utilizza un transactional outbox o un design equivalente per evitare di salvare l'ordine perdendo l'attività in background.
- Convalida e normalizza gli input. Conserva i numeri di tracking come stringhe, inclusi gli zeri iniziali. Applica la normalizzazione specifica del corriere solo quando è giustificata.
- Verifica l'esistenza di una registrazione. Utilizza un'identità stabile appropriata al provider e al tuo modello dati.
- Inserisci in coda i record idonei. Memorizza il numero di tentativi, il momento del prossimo tentativo possibile e un contesto sufficiente per la diagnosi.
- Invia tramite un limiter condiviso. Acquisisci la capacità immediatamente prima della richiesta in uscita.
- Salva gli esiti a livello di record. Separa il successo confermato, l'errore ritentabile, il rifiuto permanente e gli esiti ambigui.
Una coda assorbe un picco; non crea capacità presso il provider. Se il record idoneo più vecchio continua a invecchiare, analizza il divario tra velocità di arrivo e capacità di elaborazione invece di aumentare semplicemente il numero di worker.
Coordina i limiti tra i worker
I worker indipendenti non devono presumere singolarmente di poter consumare l'intera quota dell'account. Utilizza un rate limiter coordinato o un dispatcher che assegni un budget condiviso di richieste. Includi in tale budget le importazioni pianificate, gli script operativi e i job di riconciliazione.
La frequenza e la concorrenza sono controlli diversi. Il limiter controlla con quale frequenza iniziano le richieste; un limite di concorrenza controlla quante richieste rimangono in corso. Entrambi sono utili quando la latenza del provider aumenta. Aumentare la concorrenza può aiutare un carico di lavoro vincolato dalla latenza, ma non può aggirare un rate limit in uscita.
Utilizza la registrazione in batch senza perdere il controllo a livello di record
Quando un endpoint supporta più record per richiesta, il batching può ridurre l'overhead delle richieste. Non riduce necessariamente l'utilizzo basato sui record e il batch più grande consentito non è sempre la scelta operativa migliore.
Costruisci i batch utilizzando due trigger: un numero massimo di record e un tempo massimo di attesa. Invia il batch quando viene raggiunto uno dei due. In questo modo i periodi di attività intensa riempiono efficientemente i batch senza costringere il traffico a basso volume ad attendere indefinitamente.
- Rispetta i limiti del payload oltre al numero di record. I metadati opzionali possono rendere molto diverse, in termini di byte, batch delle stesse dimensioni.
- Mantieni un manifest interno del batch. Registra quali identità locali delle spedizioni sono state inviate e associa correttamente ciascun risultato restituito.
- Esamina i risultati a livello applicativo. Una risposta HTTP di successo, da sola, non dimostra che ogni record sia stato accettato.
- Ripeti il tentativo solo per i record che ne hanno bisogno. Ripetere l'invio dei record completati con successo crea traffico inutile e può avere conseguenze sull'utilizzo.
- Indirizza gli errori permanenti di convalida alla correzione. Un payload non valido e invariato non deve circolare nella coda dei tentativi.
Un timeout è particolarmente importante: il provider potrebbe aver accettato la richiesta anche se il client non ha ricevuto la risposta. Contrassegna tale esito come ambiguo. Risolvilo tramite un meccanismo di idempotenza supportato, una regola documentata per la registrazione duplicata o una ricerca di riconciliazione, se disponibile. Non presumere che una scrittura soggetta a timeout sia fallita.
Separa il traffico in tempo reale dalle importazioni storiche
Un backfill non deve consumare tutta la capacità necessaria per le spedizioni appena affidate al corriere. Utilizza code separate con una pianificazione ponderata o riserve di capacità esplicite. Consenti alle importazioni di utilizzare la capacità disponibile, mantenendo al contempo un'allocazione minima per le registrazioni in tempo reale. Applica l'invecchiamento o un'altra regola di equità affinché i record a priorità inferiore vengano elaborati prima o poi.
Rendi i tentativi controllati, ritardati e limitati
HTTP 429 significa “Troppe richieste”. RFC 6585 specifica che una risposta 429 può includere un'intestazione Retry-After. RFC 9110 definisce il valore di tale intestazione come una data HTTP o un ritardo espresso in secondi. Un client dovrebbe analizzare entrambi i formati invece di presumere che venga sempre restituito un intero.
Quando viene fornito un ritardo valido per il tentativo, non effettuare il tentativo prima della sua scadenza. Quando le indicazioni sui tentativi sono assenti, utilizza un exponential backoff con jitter e limite massimo: aumenta progressivamente il ritardo tra i tentativi e aggiungi casualità affinché i worker non riprovino tutti insieme. I tentativi devono passare attraverso lo stesso limiter in uscita utilizzato dai primi tentativi.
Classifica gli errori prima di effettuare un nuovo tentativo:
- Throttling: Ritarda l'attività interessata e riduci la pressione di invio nell'ambito del limite pertinente.
- Errori transitori di rete o del server: Ripeti il tentativo secondo una policy limitata, tenendo conto degli esiti ambigui delle scritture.
- Errori di autenticazione o autorizzazione: Invia un avviso e sospendi l'attività interessata finché le credenziali o i permessi non vengono corretti.
- Errori di convalida: Correggi o isola il record invece di reinviarlo invariato.
- Quota esaurita: Segui il rimedio documentato per l'account invece di trattarla come un breve picco di traffico.
Imposta sia un limite di tentativi sia un'età massima dei tentativi. Sposta gli elementi esauriti in una dead-letter queue con motivo, responsabile e procedura di replay. In caso contrario, i vecchi errori possono consumare silenziosamente la capacità destinata alle nuove spedizioni.
Scala in modo indipendente la ricezione dei webhook
Quando il provider offre webhook adeguati, questi possono ridurre le interrogazioni ripetute dello stato. Creano però anche un carico di lavoro separato in entrata, che deve rimanere disponibile durante i picchi di aggiornamenti.
Mantieni l'endpoint di ricezione focalizzato: convalida la richiesta utilizzando il meccanismo documentato dal provider, salva durevolmente l'evento e restituisci l'acknowledgment richiesto. Elabora in modo asincrono le modifiche agli ordini, gli analytics e i messaggi ai clienti. Non confermare la ricezione prima dell'accettazione durevole se ciò rischia di causare la perdita dell'evento.
Progetta i consumer affinché tollerino le consegne duplicate, salvo che il contratto del provider stabilisca esplicitamente il contrario. Preferisci un identificatore stabile dell'evento documentato per la deduplicazione. Se non esiste, progetta e testa attentamente un'identità composta: utilizzare solo un'etichetta di stato potrebbe accorpare eventi distinti in uno solo.
Proteggiti anche dagli aggiornamenti fuori ordine. Conserva la cronologia degli eventi separatamente dallo stato corrente derivato della spedizione. Applica, quando disponibili, i timestamp degli eventi e le regole di transizione documentate; non presumere che l'ordine di arrivo sia l'ordine degli eventi o che gli stati delle spedizioni formino una sequenza universalmente crescente.
Mantieni la riconciliazione mirata e limitata in termini di frequenza. Può analizzare sospette lacune nelle consegne o registrazioni ambigue, ma interrogare aggressivamente ogni spedizione può ricreare il carico in uscita che i webhook intendevano evitare.
Testa il recupero, non solo il throughput massimo
Esegui test di carico sui tuoi componenti utilizzando un simulatore del provider. Coordina i test che inviano traffico significativo a un provider reale e rimani entro i limiti autorizzati. Un test riuscito dovrebbe dimostrare che il sistema torna alla normalità dopo un'interruzione, non soltanto che accetta un picco elevato.
- Riproduci un picco simile a quello di un magazzino seguito dal normale traffico continuo.
- Inietta risposte di throttling, latenza elevata ed errori temporanei del server.
- Simula il rifiuto parziale di un batch e un timeout successivo all'accettazione lato server.
- Consegna eventi webhook duplicati e fuori ordine.
- Interrompi l'accesso al database e verifica che gli eventi non accettati non vengano confermati erroneamente.
- Esegui un backfill insieme alle registrazioni in tempo reale e verifica l'equità.
- Riproduci gli elementi della dead-letter senza aggirare i controlli di frequenza.
Monitora l'età della registrazione idonea più vecchia, la latenza di accettazione, il tasso di successo a livello di record, la frequenza del throttling, il volume dei tentativi, il ritardo nell'elaborazione dei webhook e la crescita della dead-letter. La sola profondità della coda non è sufficiente: una coda grande può svuotarsi rapidamente, mentre una coda piccola può contenere alcune spedizioni critiche per l'attività che falliscono ripetutamente.
Prima dell'alta stagione, assegna la responsabilità operativa. Il team di ingegneria dovrebbe gestire i controlli di dispatch e gli strumenti di recupero; il responsabile dell'integrazione dovrebbe confermare le autorizzazioni del provider; il team operativo dovrebbe definire quali spedizioni hanno la priorità. Documenta quando sospendere le importazioni, richiedere capacità aggiuntiva o analizzare gli aggiornamenti mancanti. Il design più solido è quello che rimane prevedibile quando il traffico supera la capacità di elaborazione immediata.
FAQ
L'aggiunta di chiavi API aumenterà il throughput?
Non necessariamente. Più chiavi possono condividere una quota a livello di account. Conferma con il provider l'ambito del limite e l'approccio di scaling consentito. Non utilizzare la rotazione delle chiavi per aggirare le restrizioni.
Ogni registrazione dovrebbe utilizzare il batch più grande possibile?
No. I batch più grandi possono migliorare l'efficienza delle richieste, ma attendere di riempirli aumenta la latenza a basso volume. Utilizza un limite massimo documentato insieme a un timer di flush, quindi ottimizza in base alla latenza di accettazione misurata e al comportamento degli errori.
Come si possono prevenire le registrazioni duplicate dopo un timeout?
Utilizza un'identità durevole locale della spedizione e il comportamento documentato del provider in materia di idempotenza o gestione dei duplicati. Se l'esito rimane incerto, effettua una riconciliazione, quando supportata, prima di ripetere l'invio. La deduplicazione locale da sola non può dimostrare se una richiesta remota abbia avuto successo.
Una registrazione completata con successo significa che le informazioni di tracking sono aggiornate?
No. L'accettazione della registrazione, la disponibilità dell'evento del corriere, l'elaborazione del provider e l'elaborazione dei tuoi aggiornamenti sono fasi separate. Misurale separatamente affinché una scansione ritardata del corriere non venga scambiata per un arretrato di registrazioni.
Quando dovrebbe un team richiedere maggiore capacità al provider?
Richiedila quando gli arrivi previsti e il tempo di recupero necessario superano la capacità utilizzabile verificata dopo aver eliminato i tentativi evitabili, gli invii duplicati e il batching inefficiente. Una quota maggiore non risolverà un consumer bloccato o un collo di bottiglia nel database, quindi individua prima il vincolo determinante.
Fonti
- 17TRACK Tracking API — punto di accesso ufficiale all'offerta API.
- Documentazione API di 17TRACK — riferimento per verificare i requisiti di integrazione, il comportamento degli endpoint e i vincoli applicabili alle richieste.
- RFC 6585, Sezione 4: 429 Too Many Requests — semantica del throttling HTTP e indicazioni opzionali su Retry-After.
- RFC 9110, Sezione 10.2.3: Retry-After — formati HTTP-date e delay-seconds.
- RFC 9110, Sezione 9.2.2: Metodi idempotenti — considerazioni sui tentativi quando l'esito di una richiesta è incerto.