Tracking APIのスケーラビリティ:繁忙期の大量処理、レート制限、バルク登録への対処方法
ピークシーズンに対応するためトラッキングAPIをスケールするには、出荷登録を耐久性のあるキューの背後に置き、すべてのワーカーにわたってプロバイダーの制限を適用し、文書化された制限内でのみバッチ処理を行い、トラッキング更新を非同期で処理します。登録スループット、再試行トラフィック、Webhook処理は、それぞれ別個のキャパシティ問題として扱ってください。送信リクエストを制御せずにワーカーを増やすと、バックログを解消するどころか、スロットリングが増加する可能性があります。
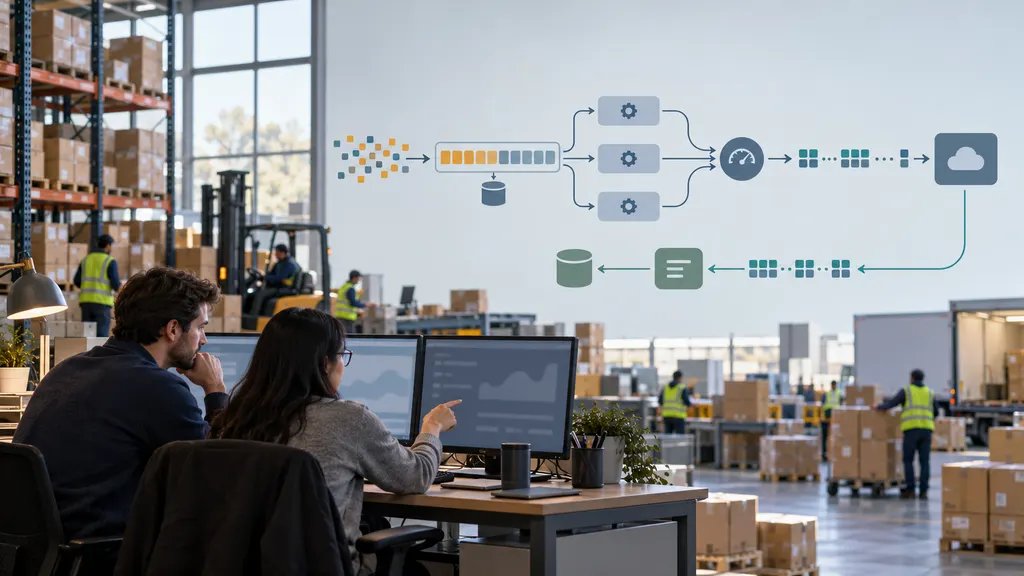
注文管理システム、倉庫プラットフォーム、またはECバックエンドをトラッキングサービスに接続するエンジニアリングチームにとって、目標は単にリクエスト数を増やすことではありません。定められた時間枠内に出荷を登録し、トラフィック急増時にも更新を保持し、重複作業を発生させずに障害から復旧することが目標です。
出荷、リクエスト、更新を基準にワークロードの規模を見積もる
連携の規模を見積もるには、1日の出荷量だけでは不十分です。倉庫では、トラッキング番号の大半が短い発送時間帯に発行される一方、ステータス更新は1日を通して到着する場合があります。これらのワークロードは個別にモデル化してください。
- 登録到着数: インポートや倉庫からの一括発送による急増を含め、1秒または1分あたりにシステムへ入ってくる新しい出荷レコード数。
- 送信APIトラフィック: 登録リクエスト、照会、訂正、照合呼び出し、再試行。
- 受信更新トラフィック: プロバイダーが対応している場合のWebhook配信および再配信。
- 下流処理: 各更新によって発生するデータベース書き込み、顧客通知、分析イベント、注文ステータスの変更。
たとえば、トラッキング番号を受け取ってから登録を確認するまでの最大許容時間など、社内の登録目標を設定します。これをトラッキングの鮮度とは分けて管理してください。登録が正常に完了したからといって、運送業者のスキャン情報がすでに利用可能とは限りません。
実効登録キャパシティを計算する
リクエスト数に制限のある登録エンドポイントでは、次の関係が計画に役立ちます。
登録キャパシティ = 許可された1秒あたりのリクエスト数 × 1リクエストあたりの平均レコード数 × 成功レコード比率
これは計画上の推定値であり、プロバイダーによる保証ではありません。リクエスト制限がボトルネックであることを前提としています。レコードベースのクォータ、ペイロードサイズ、レイテンシー、共有アカウント制限によって、上限がさらに低くなる場合があります。
例として、ある連携で1秒あたり2件の登録リクエストが許可され、各リクエストで平均30件のレコードを送信するとします。障害やその他の制約を考慮しない名目上のキャパシティは、1秒あたり60レコードです。継続的な急増時に登録の到着数が平均80レコード/秒になると、キューは約20レコード/秒のペースで増加します。これらの数値は仮定上のものであり、17TRACKの制限を示すものではありません。
復旧キャパシティも計算してください。新規到着率がλ、実効処理キャパシティがμ、既存のバックログがBレコードの場合、μ > λであれば、バックログの解消にはおよそB / (μ − λ)秒かかります。処理キャパシティが到着数を上回らない場合、その条件下ではバックログは解消されません。
プロバイダーが実際に制限している内容を確認する
レート制限と利用許容量は、異なる問題を解決します。レート制限は、リクエストまたはレコードを送信できる速さを制御します。利用許容量は、請求期間または契約上の利用期間にアカウントが消費できるトラッキングアクティビティの量を制御する場合があります。一方を下回っているからといって、もう一方への準拠が確立されるわけではありません。
ワーカー数を設定する前に、プロバイダーのドキュメントとアカウント条件に照らして、次の事項を確認してください。
- 制限がアカウント、APIキー、エンドポイント、IPアドレス、その他の範囲のどれに適用されるか。
- カウント単位がリクエスト、トラッキングレコード、その他の操作のどれであるか。
- エンドポイントが制限を共有するのか、個別の許容量を持つのか。
- 1リクエストで許可される最大レコード数とペイロードサイズ。
- 重複送信、無効なレコード、再試行が利用量に与える影響。
- レスポンスにスロットリング情報または再試行の指示が含まれるか。
- クォータ超過と一時的なスロットリングの違い。
17TRACKとの連携では、設定の出発点として公式Tracking APIページとAPIドキュメントを使用してください。デプロイ前に、該当するエンドポイントの動作とアカウント制限を確認してください。このガイドのキャパシティ例はアーキテクチャの説明を目的としたものであり、17TRACKの利用資格、バッチサイズ、サービス保証に関する記述ではありません。
注文処理と登録の間に耐久性のあるキューを配置する
チェックアウトや倉庫処理の完了を、トラッキングプロバイダーが登録を受け付けるまで待たせないでください。出荷情報をローカルに保存し、登録タスクを永続的に記録して、バックグラウンドワーカーに送信を処理させます。
実用的なフローは次のとおりです。
- 出荷情報と登録意図を保存する。 注文を保存したのにバックグラウンドタスクが失われる事態を避けるため、トランザクショナルアウトボックスまたは同等の設計を使用します。
- 入力を検証して正規化する。 先頭のゼロを含め、トラッキング番号を文字列として保持します。運送業者固有の正規化は、正当な理由がある場合にのみ適用します。
- 既存の登録を確認する。 プロバイダーとデータモデルに適した安定した識別子を使用します。
- 対象レコードをキューに入れる。 試行回数、次回再試行可能時刻、診断に必要な十分なコンテキストを保存します。
- 共有リミッターを通じて送信する。送信リクエストの直前にキャパシティを取得します。
- レコード単位の結果を永続化する。 確認済みの成功、再試行可能な失敗、恒久的な拒否、結果不明を分けて管理します。
キューは急増を吸収しますが、プロバイダーのキャパシティを生み出すものではありません。対象となる最古のレコードが継続的に古くなっている場合は、単純にワーカー数を増やすのではなく、到着率と処理キャパシティの差を調査してください。
ワーカー間で制限を調整する
独立したワーカーが、それぞれアカウントの許容量をすべて消費できると想定してはいけません。調整されたレートリミッター、または共有リクエスト予算を割り当てるディスパッチャーを使用します。スケジュールされたインポート、運用スクリプト、照合ジョブもこの予算に含めてください。
レートと同時実行数は異なる制御です。リミッターはリクエストの開始頻度を制御し、同時実行数の上限は実行中のリクエスト数を制御します。プロバイダーのレイテンシーが上昇した場合、どちらも有用です。同時実行数を増やすことでレイテンシーがボトルネックのワークロードは改善できますが、送信レート制限を超えることはできません。
レコード単位の制御を失わずに一括登録を使用する
エンドポイントが1リクエストあたり複数レコードに対応している場合、バッチ処理によってリクエストのオーバーヘッドを削減できます。ただし、レコードベースの利用量が減るとは限らず、許可される最大バッチが常に運用上最適とは限りません。
バッチは、最大レコード数と最大待機時間という2つのトリガーで作成します。どちらかに達した時点で送信します。これにより、繁忙期にはバッチを効率的に満たし、低トラフィック時には無期限に待たせずに済みます。
- レコード数だけでなくペイロード制限も守る。 オプションのメタデータにより、同じレコード数のバッチでもバイト数が大きく異なる場合があります。
- 内部バッチマニフェストを保持する。 送信したローカル出荷識別子を記録し、返された各結果を正しく関連付けます。
- アプリケーションレベルの結果を確認する。 HTTP成功レスポンスだけでは、すべてのレコードが受け付けられたことを証明できません。
- 再試行が必要なレコードのみ再試行する。 成功したレコードを再送すると不要なトラフィックが発生し、利用量に影響する可能性があります。
- 恒久的な検証失敗を修正処理へ送る。 変更されていない無効なペイロードを再試行キューに流し続けてはいけません。
タイムアウトには特に注意が必要です。クライアントがレスポンスを受信できなくても、プロバイダーがリクエストを受け付けている可能性があります。その結果は不明として扱います。サポートされている冪等性メカニズム、文書化された重複登録ルール、または利用可能な場合は照合用の照会によって解決してください。タイムアウトした書き込みが失敗したと決めつけないでください。
リアルタイムトラフィックと履歴インポートを分離する
バックフィルによって、新たに発送された出荷に必要なキャパシティをすべて消費してはいけません。重み付きスケジューリングまたは明示的なキャパシティ予約を用いて、別々のキューを使用します。リアルタイム登録に最低限の割り当てを確保しながら、余剰キャパシティをインポートに使用させます。優先度の低いレコードも最終的に処理されるよう、エージングまたは別の公平性ルールを適用します。
再試行を制御し、遅延させ、上限を設ける
HTTP 429は「リクエストが多すぎます」を意味します。RFC 6585では、429レスポンスにRetry-Afterヘッダーを含められると規定しています。RFC 9110では、このヘッダーの値をHTTP日付または秒単位の遅延のいずれかと定義しています。クライアントは常に整数が返されると想定せず、どちらの形式も解析する必要があります。
有効な再試行遅延が指定されている場合、その期限が切れる前に再試行してはいけません。再試行の指示がない場合は、ジッター付きの上限付き指数バックオフを使用します。試行間の遅延を段階的に増やし、ランダム性を加えて、すべてのワーカーが同時に再試行しないようにします。再試行も初回試行と同じ送信リミッターを通過させる必要があります。
再試行する前に失敗を分類します。
- スロットリング: 影響を受けた処理を遅延させ、該当する制限範囲内でディスパッチの負荷を下げます。
- 一時的なネットワークまたはサーバー障害: 曖昧な書き込み結果を考慮した、上限付きのポリシー内で再試行します。
- 認証または認可の失敗: 通知を行い、認証情報または権限が修正されるまで影響を受けた処理を停止します。
- 検証失敗: 変更せずに再送するのではなく、レコードを修正または分離します。
- 利用許容量の枯渇: 短時間のトラフィック急増として扱わず、文書化されたアカウント上の対処に従います。
試行回数の上限と再試行可能期間の上限を設定します。上限に達したアイテムは、理由、担当者、再実行手順を付けてデッドレターキューへ移します。そうしないと、古い失敗が新しい出荷のためのキャパシティを気づかないうちに消費する可能性があります。
Webhookの受信を独立してスケールする
プロバイダーが適切なWebhookを提供している場合、ステータスの繰り返しポーリングを削減できます。一方で、更新の急増時にも利用可能であり続けなければならない、別個の受信ワークロードも発生します。
受信エンドポイントの役割を絞ります。プロバイダーが文書化した方法でリクエストを検証し、イベントを永続的に保存して、必要な確認応答を返します。注文変更、分析、顧客メッセージは非同期で処理します。イベントを失うリスクがある場合、永続的に受け入れる前に受信確認を返してはいけません。
プロバイダーの契約で明示的に別の定めがない限り、重複配信を許容できるようコンシューマーを設計します。重複排除には、文書化された安定したイベント識別子を優先してください。そのような識別子がない場合は、複合識別子を慎重に設計してテストします。ステータスラベルだけを使用すると、異なるイベントが1つにまとめられる可能性があります。
また、順序が前後する更新にも対策します。イベント履歴を、導出された現在の出荷状態とは別に保存します。利用可能な場合は、文書化されたイベントのタイムスタンプと遷移ルールを適用します。到着順がイベント順である、または出荷ステータスが常に一方向に進む系列であると想定してはいけません。
照合は対象を絞り、レート制限を適用します。配信が欠落している疑いのあるケースや登録結果が不明なケースを調査するために使用できますが、すべての出荷を積極的にポーリングすると、Webhookによって回避するはずだった送信負荷が再び発生します。
最大スループットだけでなく復旧もテストする
プロバイダーシミュレーターを使用して、自社コンポーネントに対する負荷テストを実施します。実際のプロバイダーに大規模なトラフィックを送るテストは調整し、承認された制限内に収めてください。成功するテストとは、大量の急増を受け入れられることだけでなく、障害後にシステムが通常状態へ戻ることを示すものです。
- 倉庫で発生するような急増と、その後も継続する通常トラフィックを再現する。
- スロットリングレスポンス、上昇したレイテンシー、一時的なサーバー障害を注入する。
- バッチの一部拒否と、サーバー側で受け付けられた後のタイムアウトをシミュレートする。
- 重複したWebhookイベントと順序が前後するWebhookイベントを配信する。
- データベースアクセスを中断し、受け付けられていないイベントが誤って確認されないことを検証する。
- リアルタイム登録と並行してバックフィルを実行し、公平性を確認する。
- レート制御を回避せずにデッドレター項目を再実行する。
対象となる最古の登録の経過時間、受け入れレイテンシー、レコード単位の成功率、スロットリング頻度、再試行量、Webhook処理の遅延、デッドレターの増加を監視します。キューの深さだけでは不十分です。大きなキューがすぐに解消される場合もあれば、小さなキューに、何度も失敗するビジネス上重要な出荷がいくつか含まれている場合もあります。
ピークシーズンの前に、運用上の責任者を割り当てます。エンジニアリングはディスパッチ制御と復旧ツールを担当し、連携担当者はプロバイダーの利用資格を確認し、運用チームはどの出荷を優先するかを定義します。インポートを停止するタイミング、追加キャパシティを要求するタイミング、更新の欠落を調査するタイミングを文書化します。最も優れた設計とは、トラフィックが直ちに処理できるキャパシティを超えた場合にも予測可能性を維持できる設計です。
FAQ
APIキーを追加するとスループットは向上しますか?
必ずしも向上するとは限りません。複数のキーがアカウントレベルの利用許容量を共有している場合があります。制限の範囲と、許可されるスケーリング方法をプロバイダーに確認してください。制限を回避するためにキーをローテーションしてはいけません。
すべての登録で可能な限り大きなバッチを使用すべきですか?
いいえ。大きなバッチはリクエスト効率を改善できますが、低ボリューム時にバッチが満たされるまで待つとレイテンシーが増加します。文書化されたサイズ上限とフラッシュタイマーを使用し、測定した受け入れレイテンシーと失敗の挙動に基づいて調整してください。
タイムアウト後の重複登録を防ぐにはどうすればよいですか?
永続的なローカル出荷識別子と、プロバイダーが文書化している冪等性または重複処理の動作を使用します。結果が不明なままの場合は、再実行する前に、対応していれば照合してください。ローカルの重複排除だけでは、リモートリクエストが成功したかどうかを証明できません。
登録が成功すれば、トラッキング情報は最新ですか?
いいえ。登録の受け入れ、運送業者イベントの利用可能性、プロバイダーの処理、自社の更新処理は別々の段階です。遅延した運送業者のスキャンを登録バックログと誤認しないよう、それぞれを個別に測定してください。
チームはいつプロバイダーに追加キャパシティを要求すべきですか?
回避可能な再試行、重複送信、非効率なバッチ処理を取り除いた後、予測される到着数と必要な復旧時間が、検証済みの実用キャパシティを超える場合に要求します。許容量を増やしても、停止したコンシューマーやデータベースのボトルネックは解決しません。まず制約となっている箇所を特定してください。
Sources
- 17TRACK Tracking API — API提供の公式エントリーポイント。
- 17TRACK API documentation — 連携要件、エンドポイントの動作、適用されるリクエスト制約を確認するためのリファレンス。
- RFC 6585, Section 4: 429 Too Many Requests — HTTPスロットリングのセマンティクスと任意のRetry-After指示。
- RFC 9110, Section 10.2.3: Retry-After — HTTP日付および秒単位の遅延形式。
- RFC 9110, Section 9.2.2: Idempotent Methods — リクエスト結果が不明な場合の再試行に関する考慮事項。