Skalierbarkeit der Tracking API: So bewältigen Sie das Volumen in der Hochsaison, Ratenlimits und Massenregistrierungen
Um eine Tracking-API für die Hochsaison zu skalieren, stellen Sie die Sendungsregistrierung hinter eine ausfallsichere Warteschlange, setzen Sie Anbieterlimits über alle Worker hinweg durch, bündeln Sie Anfragen nur innerhalb der dokumentierten Grenzen und verarbeiten Sie Tracking-Aktualisierungen asynchron. Behandeln Sie den Registrierungsdurchsatz, den Wiederholungsverkehr und die Webhook-Verarbeitung als getrennte Kapazitätsprobleme. Das Hinzufügen weiterer Worker kann die Drosselung erhöhen, anstatt Ihren Rückstand abzubauen, wenn ausgehende Anfragen nicht kontrolliert werden.
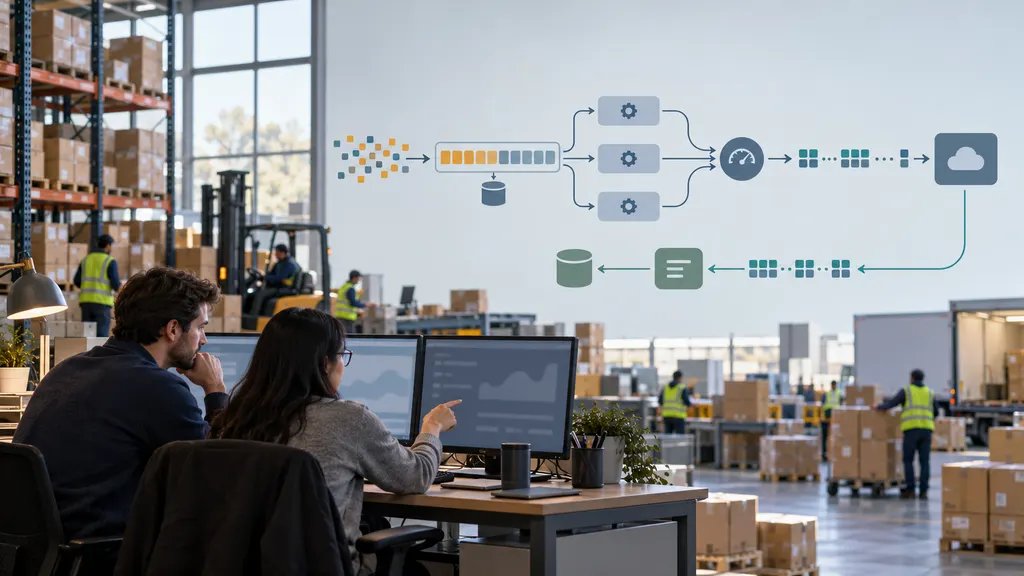
Für Entwicklungsteams, die ein Auftragsverwaltungssystem, eine Lagerplattform oder ein E-Commerce-Backend mit einem Tracking-Dienst verbinden, besteht das Ziel nicht einfach darin, mehr Anfragen zu senden. Sendungen sollen innerhalb eines festgelegten Zeitfensters registriert, Aktualisierungen während Verkehrsspitzen erhalten und Fehler behoben werden, ohne doppelte Arbeit zu erzeugen.
Bemessen Sie die Arbeitslast anhand von Sendungen, Anfragen und Aktualisierungen
Das tägliche Sendungsvolumen reicht zur Dimensionierung einer Integration nicht aus. Ein Lager kann den Großteil seiner Trackingnummern in einem kurzen Versandfenster freigeben, während Statusaktualisierungen über den ganzen Tag verteilt eintreffen. Modellieren Sie diese Arbeitslasten getrennt.
- Registrierungseingänge: Neue Sendungsdatensätze, die pro Sekunde oder Minute in Ihr System gelangen, einschließlich Importen und gebündelter Freigaben aus dem Lager.
- Ausgehender API-Verkehr: Registrierungsanfragen, Abfragen, Korrekturen, Abstimmungsaufrufe und Wiederholungen.
- Eingehender Aktualisierungsverkehr: Webhook-Zustellungen und erneute Zustellungen, sofern der Anbieter diese unterstützt.
- Nachgelagerte Arbeit: Datenbankschreibvorgänge, Kundenbenachrichtigungen, Analyseereignisse und durch jede Aktualisierung ausgelöste Änderungen des Bestellstatus.
Legen Sie ein internes Registrierungsziel fest, beispielsweise die maximal akzeptable Zeit zwischen dem Empfang einer Trackingnummer und der Bestätigung ihrer Registrierung. Halten Sie dieses Ziel getrennt von der Aktualität des Trackings: Eine erfolgreiche Registrierung bedeutet nicht, dass bereits ein Scan des Versanddienstleisters verfügbar ist.
Berechnen Sie die effektive Registrierungskapazität
Für einen registrierungsbezogenen Endpunkt mit Anfragebegrenzung ist folgende Planungsbeziehung hilfreich:
Registrierungskapazität = zulässige Anfragen pro Sekunde × durchschnittliche Datensätze pro Anfrage × Anteil erfolgreicher Datensätze
Dies ist eine Planungsschätzung und keine Garantie des Anbieters. Sie setzt voraus, dass Anfragegrenzen die maßgebliche Einschränkung darstellen. Kontingente auf Datensatzebene, Nutzlastgröße, Latenz und gemeinsam genutzte Kontolimits können eine niedrigere Obergrenze verursachen.
Nehmen wir zur Veranschaulichung an, dass eine Integration zwei Registrierungsanfragen pro Sekunde senden darf und durchschnittlich 30 Datensätze pro Anfrage übermittelt. Ihre nominelle Kapazität beträgt vor Fehlern und anderen Einschränkungen 60 Datensätze pro Sekunde. Wenn eingehende Registrierungen während einer anhaltenden Spitze durchschnittlich 80 Datensätze pro Sekunde erreichen, wächst die Warteschlange um etwa 20 Datensätze pro Sekunde. Diese Zahlen sind hypothetisch und stellen keine 17TRACK-Limits dar.
Berechnen Sie außerdem die Wiederherstellungskapazität. Wenn neue Eingänge weiterhin mit der Rate λ eintreffen und die effektive Verarbeitungskapazität μ beträgt, benötigt ein bestehender Rückstand von B Datensätzen ungefähr B / (μ − λ) Sekunden, um abgebaut zu werden, sofern μ > λ gilt. Übersteigt die Verarbeitungskapazität die Eingänge nicht, wird der Rückstand unter diesen Bedingungen nicht abgebaut.
Bestätigen Sie, was der Anbieter tatsächlich begrenzt
Ein Ratenlimit und ein Nutzungskontingent lösen unterschiedliche Probleme. Ein Ratenlimit steuert, wie schnell Anfragen oder Datensätze übermittelt werden können. Ein Nutzungskontingent kann steuern, wie viel Tracking-Aktivität ein Konto während eines Abrechnungs- oder Berechtigungszeitraums verbrauchen darf. Die Einhaltung des einen bedeutet nicht, dass auch das andere eingehalten wird.
Bevor Sie die Anzahl der Worker festlegen, bestätigen Sie anhand der Dokumentation des Anbieters und Ihrer Kontobedingungen Folgendes:
- Ob Limits pro Konto, API-Schlüssel, Endpunkt, IP-Adresse oder auf einer anderen Ebene gelten.
- Ob die gezählte Einheit eine Anfrage, ein Trackingdatensatz oder eine andere Operation ist.
- Ob Endpunkte ein Limit gemeinsam nutzen oder über unabhängige Kontingente verfügen.
- Die maximal zulässige Datensatzanzahl und Nutzlastgröße in einer Anfrage.
- Wie sich doppelte Übermittlungen, ungültige Datensätze und Wiederholungen auf die Nutzung auswirken.
- Ob Antworten Informationen zur Drosselung oder Hinweise zu Wiederholungen enthalten.
- Wie sich die Erschöpfung eines Kontingents von einer vorübergehenden Drosselung unterscheidet.
Verwenden Sie für eine 17TRACK-Integration die offizielle Tracking-API-Seite und die API-Dokumentation als Ausgangspunkte für diese Konfiguration. Bestätigen Sie vor der Bereitstellung das Verhalten des jeweils geltenden Endpunkts und die Kontolimits. Die in diesem Leitfaden genannten Beispielkapazitäten dienen der Veranschaulichung der Architektur und sind keine Aussagen zu 17TRACK-Berechtigungen, Batchgrößen oder Dienstgarantien.
Setzen Sie eine ausfallsichere Warteschlange zwischen Auftragsverarbeitung und Registrierung
Lassen Sie den Checkout oder den Abschluss eines Lagerprozesses nicht darauf warten, dass ein Trackinganbieter eine Registrierung akzeptiert. Speichern Sie die Sendung lokal, zeichnen Sie die Registrierungsaufgabe dauerhaft auf und lassen Sie Hintergrund-Worker die Übermittlung übernehmen.
Ein praktischer Ablauf ist:
- Speichern Sie die Sendung und ihre Registrierungsabsicht. Verwenden Sie eine transaktionale Outbox oder ein gleichwertiges Design, damit die Bestellung nicht gespeichert wird, während die Hintergrundaufgabe verloren geht.
- Validieren und normalisieren Sie die Eingaben. Bewahren Sie Trackingnummern als Zeichenfolgen auf, einschließlich führender Nullen. Wenden Sie eine carrierspezifische Normalisierung nur an, wenn sie gerechtfertigt ist.
- Prüfen Sie, ob bereits eine Registrierung existiert. Verwenden Sie eine stabile Identität, die zum Anbieter und zu Ihrem Datenmodell passt.
- Stellen Sie geeignete Datensätze in die Warteschlange. Speichern Sie die Anzahl der Versuche, den nächsten zulässigen Wiederholungszeitpunkt und ausreichend Kontext für die Diagnose.
- Übermitteln Sie über einen gemeinsamen Limiter. Reservieren Sie Kapazität unmittelbar vor der ausgehenden Anfrage.
- Speichern Sie Ergebnisse auf Datensatzebene. Trennen Sie bestätigte Erfolge, wiederholbare Fehler, dauerhafte Ablehnungen und unklare Ergebnisse.
Eine Warteschlange absorbiert eine Spitze, erzeugt jedoch keine Kapazität beim Anbieter. Wenn der älteste zulässige Datensatz immer älter wird, untersuchen Sie die Lücke zwischen Eingangsrate und Verarbeitungskapazität, anstatt einfach die Anzahl der Worker zu erhöhen.
Koordinieren Sie Limits über alle Worker hinweg
Unabhängige Worker dürfen nicht jeweils davon ausgehen, dass sie das gesamte Kontingent des Kontos verbrauchen können. Verwenden Sie einen koordinierten Ratenbegrenzer oder einen Dispatcher, der ein gemeinsames Anfragebudget verteilt. Beziehen Sie geplante Importe, Betriebsskripte und Abstimmungsaufgaben in dieses Budget ein.
Rate und Parallelität sind unterschiedliche Steuerungen. Der Limiter steuert, wie oft Anfragen gestartet werden; eine Parallelitätsgrenze steuert, wie viele Anfragen gleichzeitig aktiv bleiben. Beide sind nützlich, wenn die Latenz des Anbieters steigt. Eine Erhöhung der Parallelität kann bei einer latenzgebundenen Arbeitslast helfen, eine Begrenzung ausgehender Anfragen jedoch nicht außer Kraft setzen.
Nutzen Sie Sammelregistrierungen, ohne die Kontrolle auf Datensatzebene zu verlieren
Wenn ein Endpunkt mehrere Datensätze pro Anfrage unterstützt, kann die Bündelung den Anfrageaufwand reduzieren. Sie reduziert nicht zwangsläufig die Nutzung auf Datensatzbasis, und der größtmögliche zulässige Batch ist nicht immer die beste betriebliche Wahl.
Erstellen Sie Batches anhand zweier Auslöser: einer maximalen Datensatzanzahl und einer maximalen Wartezeit. Übermitteln Sie den Batch, sobald eine der beiden Grenzen erreicht ist. So können stark ausgelastete Zeiträume Batches effizient füllen, ohne dass bei geringem Volumen unbegrenzt gewartet werden muss.
- Beachten Sie neben der Datensatzanzahl auch die Nutzlastgrenzen. Optionale Metadaten können dafür sorgen, dass gleich große Batches sich in ihrer Bytegröße stark unterscheiden.
- Führen Sie ein internes Batch-Manifest. Zeichnen Sie auf, welche lokalen Sendungsidentitäten übermittelt wurden, und ordnen Sie jedes zurückgegebene Ergebnis korrekt zu.
- Prüfen Sie Ergebnisse auf Anwendungsebene. Eine erfolgreiche HTTP-Antwort beweist für sich allein nicht, dass jeder Datensatz akzeptiert wurde.
- Wiederholen Sie nur Datensätze, bei denen eine Wiederholung erforderlich ist. Das erneute Senden erfolgreicher Datensätze erzeugt unnötigen Verkehr und kann Auswirkungen auf die Nutzung haben.
- Leiten Sie dauerhafte Validierungsfehler zur Korrektur weiter. Eine unveränderte ungültige Nutzlast sollte nicht durch die Wiederholungswarteschlange zirkulieren.
Ein Timeout ist besonders wichtig: Der Anbieter kann die Anfrage akzeptiert haben, obwohl Ihr Client keine Antwort erhalten hat. Markieren Sie dieses Ergebnis als unklar. Klären Sie es über einen unterstützten Idempotenzmechanismus, eine dokumentierte Regel für doppelte Registrierungen oder, sofern verfügbar, eine Abstimmungsabfrage. Gehen Sie nicht davon aus, dass ein Schreiben bei einem Timeout fehlgeschlagen ist.
Trennen Sie Live-Verkehr von historischen Importen
Ein Backfill sollte nicht die gesamte Kapazität verbrauchen, die für neu versendete Sendungen benötigt wird. Verwenden Sie getrennte Warteschlangen mit gewichteter Planung oder expliziten Kapazitätsreservierungen. Ermöglichen Sie Importen die Nutzung freier Kapazität, während Sie eine Mindestzuteilung für Live-Registrierungen bewahren. Wenden Sie Alterung oder eine andere Fairnessregel an, damit Datensätze mit niedrigerer Priorität letztendlich verarbeitet werden.
Gestalten Sie Wiederholungen kontrolliert, verzögert und begrenzt
HTTP 429 bedeutet „Too Many Requests“. RFC 6585 legt fest, dass eine 429-Antwort einen Retry-After-Header enthalten kann. RFC 9110 definiert den Wert dieses Headers entweder als HTTP-Datum oder als Verzögerung in Sekunden. Ein Client sollte beide Formen parsen, statt anzunehmen, dass immer eine Ganzzahl zurückgegeben wird.
Wenn eine gültige Wiederholungsverzögerung angegeben wird, starten Sie keine Wiederholung, bevor sie abgelaufen ist. Fehlen Hinweise zur Wiederholung, verwenden Sie exponentielles Backoff mit einer Obergrenze und Jitter: Erhöhen Sie die Verzögerung zwischen den Versuchen schrittweise und fügen Sie Zufälligkeit hinzu, damit nicht alle Worker gleichzeitig wiederholen. Wiederholungen müssen denselben Limiter für ausgehende Anfragen passieren wie Erstversuche.
Klassifizieren Sie Fehler vor einer Wiederholung:
- Drosselung: Verzögern Sie die betroffene Arbeit und reduzieren Sie den Versanddruck innerhalb des relevanten Geltungsbereichs des Limits.
- Vorübergehende Netzwerk- oder Serverfehler: Wiederholen Sie die Anfrage innerhalb einer begrenzten Richtlinie und berücksichtigen Sie dabei unklare Ergebnisse von Schreibvorgängen.
- Authentifizierungs- oder Autorisierungsfehler: Lösen Sie einen Alarm aus und pausieren Sie die betroffene Arbeit, bis Anmeldedaten oder Berechtigungen korrigiert wurden.
- Validierungsfehler: Korrigieren oder isolieren Sie den Datensatz, statt ihn unverändert erneut zu senden.
- Erschöpftes Kontingent: Befolgen Sie die dokumentierte Maßnahme für das Konto, statt dies als kurze Verkehrsspitze zu behandeln.
Legen Sie sowohl eine Versuchslimit als auch ein maximales Wiederholungsalter fest. Verschieben Sie ausgeschöpfte Elemente mit einem Grund, einer Zuständigkeit und einem Verfahren zur erneuten Verarbeitung in eine Dead-Letter-Warteschlange. Andernfalls können alte Fehler unbemerkt die für neue Sendungen vorgesehene Kapazität verbrauchen.
Skalieren Sie die Webhook-Aufnahme unabhängig
Wenn der Anbieter geeignete Webhooks anbietet, können diese wiederholte Statusabfragen reduzieren. Sie erzeugen jedoch eine separate eingehende Arbeitslast, die auch während Aktualisierungsspitzen verfügbar bleiben muss.
Halten Sie den Empfangsendpunkt fokussiert: Validieren Sie die Anfrage mit dem dokumentierten Mechanismus des Anbieters, speichern Sie das Ereignis dauerhaft und geben Sie die erforderliche Bestätigung zurück. Verarbeiten Sie Bestelländerungen, Analysen und Kundennachrichten asynchron. Bestätigen Sie den Empfang nicht, bevor die dauerhafte Annahme erfolgt ist, wenn dadurch das Risiko eines Ereignisverlusts bestünde.
Gestalten Sie Verbraucher so, dass sie doppelte Zustellungen tolerieren, sofern der Anbietervertrag nicht ausdrücklich etwas anderes festlegt. Bevorzugen Sie zur Deduplizierung eine dokumentierte stabile Ereigniskennung. Falls keine vorhanden ist, entwerfen und testen Sie eine zusammengesetzte Identität sorgfältig: Die alleinige Verwendung einer Statusbezeichnung könnte unterschiedliche Ereignisse zu einem einzigen zusammenfassen.
Schützen Sie sich außerdem vor Aktualisierungen in falscher Reihenfolge. Speichern Sie den Ereignisverlauf getrennt vom abgeleiteten aktuellen Sendungsstatus. Wenden Sie, sofern verfügbar, dokumentierte Ereigniszeitstempel und Übergangsregeln an. Gehen Sie nicht davon aus, dass die Eingangsreihenfolge der Ereignisreihenfolge entspricht oder dass Sendungsstatus universell eine aufsteigende Sequenz bilden.
Halten Sie Abstimmungen gezielt und ratenbegrenzt. Sie können vermutete Lücken bei Zustellungen oder unklare Registrierungen untersuchen, aber das aggressive Abfragen jeder Sendung kann die ausgehende Last wiederherstellen, die durch Webhooks eigentlich vermieden werden sollte.
Testen Sie die Wiederherstellung, nicht nur den maximalen Durchsatz
Führen Sie Lasttests gegen Ihre eigenen Komponenten mit einem Anbietersimulator durch. Stimmen Sie Tests ab, die erheblichen Verkehr an einen Live-Anbieter senden, und halten Sie sich an die autorisierten Limits. Ein erfolgreicher Test sollte zeigen, dass das System nach einer Störung zum Normalbetrieb zurückkehrt, nicht nur, dass es eine große Spitze akzeptiert.
- Spielen Sie eine lagerähnliche Spitze mit anschließendem weiterlaufendem Normalverkehr ab.
- Fügen Sie Drosselungsantworten, erhöhte Latenz und vorübergehende Serverfehler ein.
- Simulieren Sie eine teilweise Ablehnung eines Batches und einen Timeout nach serverseitiger Annahme.
- Stellen Sie doppelte und ungeordnete Webhook-Ereignisse zu.
- Unterbrechen Sie den Datenbankzugriff und überprüfen Sie, dass nicht angenommene Ereignisse nicht fälschlich bestätigt werden.
- Führen Sie einen Backfill parallel zu Live-Registrierungen aus und prüfen Sie die Fairness.
- Spielen Sie Elemente aus der Dead-Letter-Warteschlange erneut ab, ohne Ratenkontrollen zu umgehen.
Überwachen Sie das Alter der ältesten zulässigen Registrierung, die Annahmelatenz, die Erfolgsquote auf Datensatzebene, die Häufigkeit von Drosselungen, das Wiederholungsvolumen, den Rückstand bei der Webhook-Verarbeitung und das Wachstum der Dead-Letter-Warteschlange. Die Warteschlangentiefe allein reicht nicht aus: Eine große Warteschlange kann schnell abgebaut werden, während eine kleine Warteschlange einige wenige wiederholt fehlschlagende, geschäftskritische Sendungen enthalten kann.
Bestimmen Sie vor der Hochsaison die betriebliche Zuständigkeit. Die Entwicklung sollte für Versandkontrollen und Wiederherstellungswerkzeuge zuständig sein; der Integrationsverantwortliche sollte die Berechtigungen beim Anbieter bestätigen; der Betrieb sollte festlegen, welche Sendungen Priorität erhalten. Dokumentieren Sie, wann Importe pausiert, zusätzliche Kapazität angefordert oder fehlende Aktualisierungen untersucht werden sollen. Das stärkste Design ist eines, das vorhersehbar bleibt, wenn der Verkehr die unmittelbare Verarbeitungskapazität überschreitet.
FAQ
Erhöht das Hinzufügen von API-Schlüsseln den Durchsatz?
Nicht unbedingt. Mehrere Schlüssel können ein Kontingent auf Kontoebene gemeinsam nutzen. Bestätigen Sie den Geltungsbereich des Limits und den zulässigen Skalierungsansatz mit dem Anbieter. Verwenden Sie keine Schlüsselrotation, um Einschränkungen zu umgehen.
Sollte jede Registrierung den größtmöglichen Batch verwenden?
Nein. Größere Batches können die Effizienz von Anfragen verbessern, aber das Warten auf ihre vollständige Füllung erhöht bei geringem Volumen die Latenz. Verwenden Sie eine dokumentierte Größenobergrenze zusammen mit einem Flush-Timer und optimieren Sie anschließend anhand der gemessenen Annahmelatenz und des Fehlerverhaltens.
Wie lassen sich doppelte Registrierungen nach einem Timeout verhindern?
Verwenden Sie eine dauerhafte lokale Sendungsidentität sowie das dokumentierte Verhalten des Anbieters hinsichtlich Idempotenz oder Duplikatbehandlung. Bleibt das Ergebnis unklar, stimmen Sie es, sofern unterstützt, vor einer erneuten Übermittlung ab. Eine lokale Deduplizierung allein kann nicht beweisen, ob eine entfernte Anfrage erfolgreich war.
Bedeutet eine erfolgreiche Registrierung, dass die Trackinginformationen aktuell sind?
Nein. Die Annahme der Registrierung, die Verfügbarkeit eines Ereignisses beim Versanddienstleister, die Verarbeitung durch den Anbieter und Ihre eigene Verarbeitung der Aktualisierung sind getrennte Phasen. Messen Sie sie separat, damit ein verspäteter Scan des Versanddienstleisters nicht mit einem Registrierungsrückstand verwechselt wird.
Wann sollte ein Team mehr Kapazität beim Anbieter anfordern?
Fordern Sie sie an, wenn die prognostizierten Eingänge und die erforderliche Wiederherstellungszeit die verifizierte nutzbare Kapazität überschreiten, nachdem vermeidbare Wiederholungen, doppelte Übermittlungen und ineffiziente Batches entfernt wurden. Ein größeres Kontingent behebt keinen blockierten Verbraucher oder einen Datenbankengpass. Ermitteln Sie daher zuerst die maßgebliche Einschränkung.
Quellen
- 17TRACK Tracking API — offizieller Einstiegspunkt für das API-Angebot.
- 17TRACK API documentation — Referenz zur Prüfung von Integrationsanforderungen, Endpunktverhalten und geltenden Anfragebeschränkungen.
- RFC 6585, Section 4: 429 Too Many Requests — HTTP-Drosselungssemantik und optionale Hinweise zu Retry-After.
- RFC 9110, Section 10.2.3: Retry-After — Formate für HTTP-Datum und Verzögerungssekunden.
- RFC 9110, Section 9.2.2: Idempotent Methods — Überlegungen zu Wiederholungen, wenn das Ergebnis einer Anfrage ungewiss ist.