Scalabilité de l’API de suivi : comment gérer le volume en période de pointe, les limites de débit et les inscriptions en masse
Pour faire évoluer une API de suivi pendant les périodes de pointe, placez l’enregistrement des expéditions derrière une file d’attente durable, appliquez les limites du fournisseur à l’ensemble des workers, n’effectuez des traitements par lots que dans les limites documentées et traitez les mises à jour de suivi de manière asynchrone. Considérez le débit d’enregistrement, le trafic de nouvelle tentative et le traitement des webhooks comme des problèmes de capacité distincts. Ajouter davantage de workers sans contrôler les requêtes sortantes peut accroître la limitation de débit au lieu de résorber votre retard.
Pour les équipes d’ingénierie qui connectent un système de gestion des commandes, une plateforme d’entrepôt ou un back-end e-commerce à un service de suivi, l’objectif n’est pas simplement d’envoyer davantage de requêtes. Il s’agit d’enregistrer les expéditions dans un délai défini, de préserver les mises à jour pendant les pics de trafic et de récupérer après les défaillances sans créer de travail en double.
Dimensionner la charge autour des expéditions, des requêtes et des mises à jour
Le volume quotidien d’expéditions ne suffit pas à dimensionner une intégration. Un entrepôt peut libérer la plupart de ses numéros de suivi sur une courte période d’expédition, tandis que les mises à jour de statut arrivent tout au long de la journée. Modélisez ces charges séparément.
- Arrivées d’enregistrements : nouveaux enregistrements d’expédition entrant dans votre système par seconde ou par minute, y compris les importations et les vagues de libération de l’entrepôt.
- Trafic API sortant : requêtes d’enregistrement, recherches, corrections, appels de rapprochement et nouvelles tentatives.
- Trafic de mises à jour entrantes : livraisons et nouvelles livraisons de webhooks, lorsque le fournisseur les prend en charge.
- Travail en aval : écritures en base de données, notifications clients, événements analytiques et changements de statut des commandes déclenchés par chaque mise à jour.
Définissez un objectif interne d’enregistrement, par exemple le délai maximal acceptable entre la réception d’un numéro de suivi et la confirmation de son enregistrement. Maintenez-le distinct de la fraîcheur du suivi : un enregistrement réussi ne signifie pas qu’un scan du transporteur est déjà disponible.
Calculer la capacité effective d’enregistrement
Pour un endpoint d’enregistrement limité par le nombre de requêtes, la relation suivante est utile pour la planification :
Capacité d’enregistrement = requêtes autorisées par seconde × nombre moyen d’enregistrements par requête × fraction d’enregistrements réussis
Il s’agit d’une estimation de planification, et non d’une garantie du fournisseur. Elle suppose que les limites de requêtes constituent la contrainte déterminante. Les quotas fondés sur les enregistrements, la taille des charges utiles, la latence et les limites partagées du compte peuvent imposer un plafond inférieur.
À titre d’illustration uniquement, supposons qu’une intégration soit autorisée à effectuer deux requêtes d’enregistrement par seconde et envoie en moyenne 30 enregistrements par requête. Sa capacité nominale est de 60 enregistrements par seconde avant les échecs et autres contraintes. Si les enregistrements entrants atteignent en moyenne 80 enregistrements par seconde pendant une vague soutenue, la file d’attente augmente d’environ 20 enregistrements par seconde. Ces chiffres sont hypothétiques et ne correspondent pas aux limites de 17TRACK.
Calculez également la capacité de récupération. Si les nouvelles arrivées continuent au taux λ et que la capacité effective de traitement est μ, un retard existant de B enregistrements nécessite environ B / (μ − λ) secondes pour être résorbé lorsque μ > λ. Si la capacité de traitement ne dépasse pas les arrivées, le retard ne sera pas résorbé dans ces conditions.
Confirmer ce que le fournisseur limite réellement
Une limite de débit et une allocation d’utilisation répondent à des problèmes différents. Une limite de débit contrôle la vitesse à laquelle les requêtes ou les enregistrements peuvent être soumis. Une allocation d’utilisation peut contrôler la quantité d’activité de suivi qu’un compte peut consommer pendant une période de facturation ou de droits. Rester en dessous de l’une ne garantit pas le respect de l’autre.
Avant de définir le nombre de workers, vérifiez les points suivants dans la documentation du fournisseur et les conditions de votre compte :
- Si les limites s’appliquent au compte, à la clé API, à l’endpoint, à l’adresse IP ou à une autre portée.
- Si l’unité comptabilisée est une requête, un enregistrement de suivi ou une autre opération.
- Si les endpoints partagent une limite ou disposent d’allocations indépendantes.
- Le nombre maximal d’enregistrements et la taille maximale de la charge utile autorisés dans une requête.
- L’incidence des soumissions en double, des enregistrements invalides et des nouvelles tentatives sur l’utilisation.
- Si les réponses exposent des informations de limitation ou des indications de nouvelle tentative.
- La différence entre l’épuisement du quota et une limitation temporaire.
Pour une intégration 17TRACK, utilisez la page officielle de l’API de suivi et la documentation de l’API comme points de départ pour cette configuration. Confirmez le comportement de l’endpoint concerné et les limites du compte avant le déploiement. Les capacités présentées dans ce guide sont des illustrations d’architecture et ne constituent pas des affirmations concernant les droits 17TRACK, les tailles de lots ou les garanties de service.
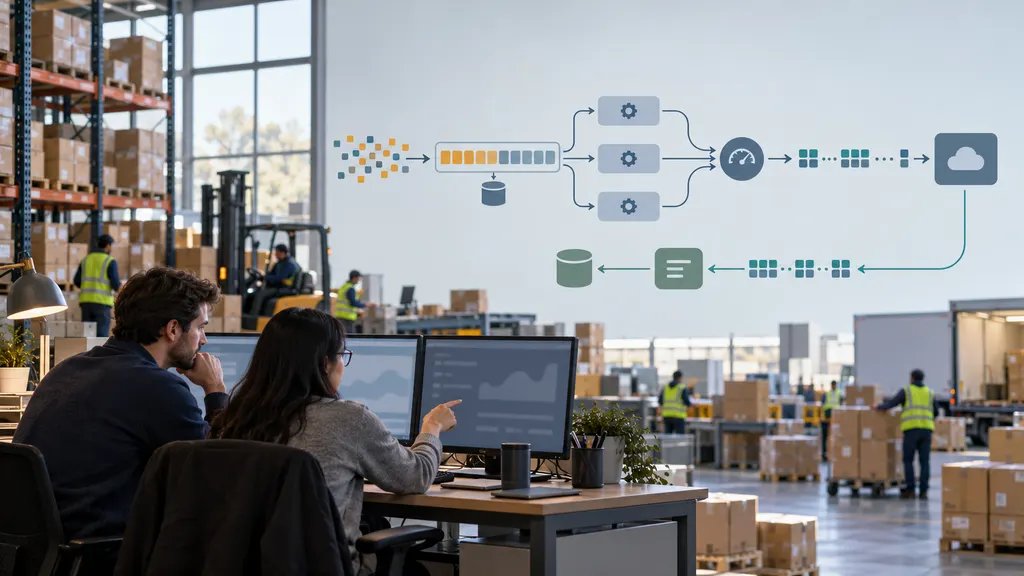
Placer une file d’attente durable entre le traitement des commandes et l’enregistrement
Ne faites pas attendre la finalisation du paiement ou de l’entrepôt qu’un fournisseur de suivi accepte un enregistrement. Enregistrez l’expédition localement, consignez durablement la tâche d’enregistrement et laissez les workers d’arrière-plan gérer la soumission.
Un flux pratique est le suivant :
- Enregistrer l’expédition et l’intention d’enregistrement. Utilisez un outbox transactionnel ou une conception équivalente pour éviter d’enregistrer la commande tout en perdant la tâche d’arrière-plan.
- Valider et normaliser les entrées. Conservez les numéros de suivi sous forme de chaînes, y compris les zéros initiaux. N’appliquez une normalisation propre au transporteur que lorsqu’elle est justifiée.
- Vérifier l’existence d’un enregistrement. Utilisez une identité stable adaptée au fournisseur et à votre modèle de données.
- Mettre en file les enregistrements éligibles. Stockez le nombre de tentatives, l’heure de la prochaine nouvelle tentative autorisée et suffisamment de contexte pour le diagnostic.
- Soumettre via un limiteur partagé. Réservez la capacité immédiatement avant la requête sortante.
- Conserver les résultats au niveau de l’enregistrement. Séparez les succès confirmés, les échecs pouvant faire l’objet d’une nouvelle tentative, les rejets définitifs et les résultats ambigus.
Une file d’attente absorbe une vague ; elle ne crée pas de capacité chez le fournisseur. Si le plus ancien enregistrement éligible continue de vieillir, recherchez l’écart entre le taux d’arrivée et la capacité de traitement au lieu d’augmenter simplement le nombre de workers.
Coordonner les limites entre les workers
Les workers indépendants ne doivent pas supposer chacun qu’ils peuvent consommer la totalité de l’allocation du compte. Utilisez un limiteur de débit coordonné ou un répartiteur qui alloue un budget de requêtes partagé. Incluez les importations planifiées, les scripts opérationnels et les tâches de rapprochement dans ce budget.
Le débit et la concurrence sont deux contrôles différents. Le limiteur contrôle la fréquence de démarrage des requêtes ; une limite de concurrence contrôle le nombre de requêtes simultanément en cours. Les deux sont utiles lorsque la latence du fournisseur augmente. Accroître la concurrence peut aider une charge limitée par la latence, mais cela ne peut pas contourner une limite de débit sortant.
Utiliser l’enregistrement groupé sans perdre le contrôle au niveau de l’enregistrement
Lorsqu’un endpoint prend en charge plusieurs enregistrements par requête, le traitement par lots peut réduire la surcharge des requêtes. Il ne réduit pas nécessairement l’utilisation fondée sur les enregistrements, et le plus grand lot autorisé n’est pas toujours le meilleur choix opérationnel.
Construisez les lots à l’aide de deux déclencheurs : un nombre maximal d’enregistrements et un délai d’attente maximal. Soumettez le lot dès que l’un des deux seuils est atteint. Les périodes de forte activité peuvent ainsi remplir efficacement les lots sans contraindre les faibles volumes à attendre indéfiniment.
- Respecter les limites de charge utile ainsi que le nombre d’enregistrements. Les métadonnées facultatives peuvent rendre très différents en octets des lots de même taille.
- Conserver un manifeste interne des lots. Notez les identités locales des expéditions soumises et associez correctement chaque résultat renvoyé.
- Examiner les résultats au niveau applicatif. Une réponse HTTP réussie ne prouve pas à elle seule que chaque enregistrement a été accepté.
- Ne relancer que les enregistrements qui doivent l’être. Rejouer les enregistrements réussis génère un trafic inutile et peut avoir des conséquences sur l’utilisation.
- Orienter les échecs permanents de validation vers la correction. Une charge utile invalide inchangée ne doit pas circuler dans la file de nouvelles tentatives.
Un délai d’expiration est particulièrement important : le fournisseur peut avoir accepté la requête même si votre client n’a pas reçu la réponse. Marquez ce résultat comme ambigu. Résolvez-le au moyen d’un mécanisme d’idempotence pris en charge, d’une règle documentée d’enregistrement en double ou d’une recherche de rapprochement lorsqu’elle est disponible. Ne supposez pas qu’une écriture ayant expiré a échoué.
Séparer le trafic en direct des importations historiques
Un remplissage historique ne doit pas consommer toute la capacité nécessaire aux expéditions nouvellement envoyées. Utilisez des files d’attente distinctes avec une planification pondérée ou des réservations explicites de capacité. Autorisez les importations à utiliser la capacité disponible tout en préservant une allocation minimale pour les enregistrements en direct. Appliquez un vieillissement ou une autre règle d’équité afin que les enregistrements moins prioritaires soient finalement traités.
Rendre les nouvelles tentatives contrôlées, différées et limitées
HTTP 429 signifie « Too Many Requests ». La RFC 6585 précise qu’une réponse 429 peut inclure un en-tête Retry-After. La RFC 9110 définit la valeur de cet en-tête comme une date HTTP ou un délai en secondes. Un client doit analyser les deux formats plutôt que de supposer qu’un entier est toujours renvoyé.
Lorsqu’un délai de nouvelle tentative valide est fourni, ne relancez pas la requête avant son expiration. Lorsque les indications de nouvelle tentative sont absentes, utilisez un backoff exponentiel plafonné avec jitter : augmentez progressivement le délai entre les tentatives et ajoutez une part d’aléatoire afin que les workers ne relancent pas tous ensemble. Les nouvelles tentatives doivent passer par le même limiteur sortant que les premières tentatives.
Classez les échecs avant d’effectuer une nouvelle tentative :
- Limitation de débit : Différez le travail concerné et réduisez la pression d’envoi dans la portée de limite appropriée.
- Échecs réseau ou serveur temporaires : Effectuez une nouvelle tentative dans le cadre d’une politique limitée, en tenant compte des résultats d’écriture ambigus.
- Échecs d’authentification ou d’autorisation : Déclenchez une alerte et suspendez le travail concerné jusqu’à la correction des identifiants ou des autorisations.
- Échecs de validation : Corrigez ou isolez l’enregistrement au lieu de le renvoyer tel quel.
- Allocation épuisée : Suivez le correctif de compte documenté au lieu de considérer la situation comme un bref pic de trafic.
Définissez à la fois une limite de tentatives et un âge maximal pour les nouvelles tentatives. Déplacez les éléments épuisés vers une file de lettres mortes avec une raison, un responsable et une procédure de rejeu. Sinon, les anciens échecs peuvent consommer silencieusement la capacité destinée aux nouvelles expéditions.
Faire évoluer l’ingestion des webhooks indépendamment
Lorsque le fournisseur propose des webhooks adaptés, ceux-ci peuvent réduire les interrogations répétées de statut. Ils créent également une charge entrante distincte qui doit rester disponible pendant les vagues de mises à jour.
Gardez l’endpoint de réception ciblé : validez la requête à l’aide du mécanisme documenté par le fournisseur, stockez durablement l’événement et renvoyez l’accusé de réception requis. Traitez de manière asynchrone les changements de commande, les analyses et les messages clients. N’accusez pas réception avant l’acceptation durable si cela risque de faire perdre l’événement.
Concevez les consommateurs pour tolérer les livraisons en double, sauf si le contrat du fournisseur établit explicitement le contraire. Préférez un identifiant d’événement stable et documenté pour la déduplication. S’il n’en existe aucun, concevez et testez soigneusement une identité composite : utiliser uniquement un libellé de statut pourrait fusionner des événements distincts.
Protégez-vous également contre les mises à jour reçues dans le désordre. Stockez l’historique des événements séparément de l’état courant dérivé de l’expédition. Appliquez les horodatages d’événements et les règles de transition documentés lorsqu’ils sont disponibles ; ne supposez pas que l’ordre d’arrivée est l’ordre des événements ni que les statuts d’expédition forment une séquence universellement croissante.
Maintenez le rapprochement ciblé et limité par le débit. Il peut examiner les écarts de livraison présumés ou les enregistrements ambigus, mais interroger agressivement chaque expédition peut recréer la charge sortante que les webhooks étaient censés éviter.
Tester la récupération, pas seulement le débit maximal
Effectuez des tests de charge sur vos propres composants à l’aide d’un simulateur de fournisseur. Coordonnez les tests qui envoient un trafic important vers un fournisseur réel et restez dans les limites autorisées. Un test réussi doit démontrer que le système revient à la normale après une perturbation, et pas seulement qu’il accepte une grande vague.
- Rejouer une vague de type entrepôt suivie d’un trafic normal continu.
- Injecter des réponses de limitation, une latence élevée et des défaillances temporaires du serveur.
- Simuler le rejet partiel d’un lot et un délai d’expiration après l’acceptation côté serveur.
- Livrer des événements webhook en double et dans le désordre.
- Interrompre l’accès à la base de données et vérifier que les événements non acceptés ne sont pas accusés à tort.
- Exécuter un remplissage historique en parallèle des enregistrements en direct et vérifier l’équité.
- Rejouer les éléments de la file de lettres mortes sans contourner les contrôles de débit.
Surveillez l’âge du plus ancien enregistrement éligible, la latence d’acceptation, le taux de réussite au niveau des enregistrements, la fréquence des limitations, le volume de nouvelles tentatives, le retard de traitement des webhooks et la croissance de la file de lettres mortes. La profondeur de la file seule est insuffisante : une file importante peut se vider rapidement, tandis qu’une petite file peut contenir quelques expéditions critiques qui échouent de façon répétée.
Avant la haute saison, attribuez les responsabilités opérationnelles. L’ingénierie doit gérer les contrôles d’envoi et les outils de récupération ; le responsable de l’intégration doit confirmer les droits auprès du fournisseur ; les opérations doivent définir les expéditions prioritaires. Documentez les situations dans lesquelles il faut suspendre les importations, demander une capacité supplémentaire ou examiner les mises à jour manquantes. La meilleure conception est celle qui reste prévisible lorsque le trafic dépasse sa capacité immédiate de traitement.
FAQ
L’ajout de clés API augmentera-t-il le débit ?
Pas nécessairement. Plusieurs clés peuvent partager une allocation au niveau du compte. Confirmez la portée de la limite et l’approche de mise à l’échelle autorisée auprès du fournisseur. N’utilisez pas la rotation des clés pour contourner les restrictions.
Chaque enregistrement doit-il utiliser le plus grand lot possible ?
Non. Les lots plus importants peuvent améliorer l’efficacité des requêtes, mais attendre de les remplir augmente la latence lorsque le volume est faible. Utilisez une limite de taille documentée ainsi qu’un minuteur de vidage, puis ajustez-les à partir de la latence d’acceptation et du comportement en cas d’échec mesurés.
Comment éviter les enregistrements en double après un délai d’expiration ?
Utilisez une identité d’expédition locale durable et le comportement documenté du fournisseur en matière d’idempotence ou de gestion des doublons. Si le résultat reste incertain, effectuez un rapprochement lorsque cela est pris en charge avant de rejouer la requête. La déduplication locale seule ne peut pas prouver qu’une requête distante a réussi.
Un enregistrement réussi signifie-t-il que les informations de suivi sont à jour ?
Non. L’acceptation de l’enregistrement, la disponibilité de l’événement du transporteur, le traitement par le fournisseur et votre propre traitement des mises à jour sont des étapes distinctes. Mesurez-les séparément afin de ne pas confondre un scan retardé du transporteur avec un retard d’enregistrement.
Quand une équipe doit-elle demander davantage de capacité au fournisseur ?
Demandez-la lorsque les arrivées prévues et le délai de récupération requis dépassent la capacité utilisable vérifiée après suppression des nouvelles tentatives évitables, des soumissions en double et des traitements par lots inefficaces. Une allocation plus importante ne résoudra pas un consommateur bloqué ou un goulot d’étranglement de base de données ; identifiez donc d’abord la contrainte déterminante.
Sources
- API de suivi 17TRACK — point d’entrée officiel de l’offre API.
- Documentation de l’API 17TRACK — référence pour vérifier les exigences d’intégration, le comportement des endpoints et les contraintes de requêtes applicables.
- RFC 6585, section 4 : 429 Too Many Requests — sémantique de la limitation HTTP et indications facultatives concernant Retry-After.
- RFC 9110, section 10.2.3 : Retry-After — formats date HTTP et délai en secondes.
- RFC 9110, section 9.2.2 : méthodes idempotentes — considérations relatives aux nouvelles tentatives lorsque le résultat d’une requête est incertain.