Guia de Confiabilidade da API de Rastreamento: Como Monitorar o Tempo de Atividade, a Atualidade dos Dados e as Atualizações Perdidas após o Go-Live
Após a entrada em produção, monitore a confiabilidade da API de rastreamento em três camadas distintas: se as solicitações são bem-sucedidas, se as informações da remessa chegam dentro de um atraso aceitável e se as atualizações chegam aos seus próprios sistemas sem lacunas. Uma resposta bem-sucedida da API não prova que os dados de rastreamento estão atualizados ou que uma notificação ao cliente foi entregue. Dê a cada camada suas próprias métricas, alertas e procedimento de recuperação.
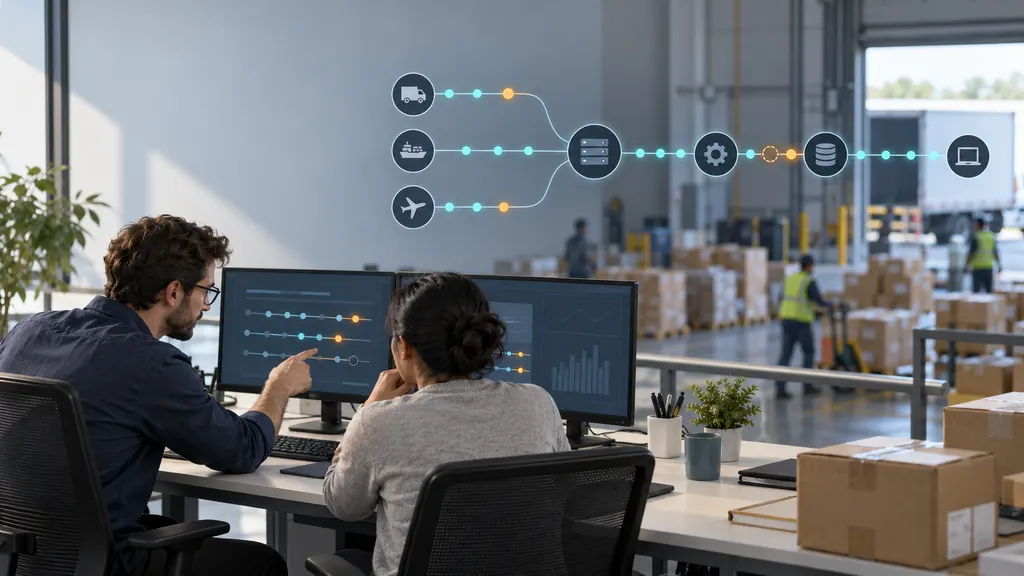
Este guia é destinado a engenheiros e equipes de operações responsáveis por uma integração ativa de rastreamento de remessas. O objetivo é detectar a perda de visibilidade antes que ela se torne um problema para o suporte e, em seguida, identificar se a falha está no feed da transportadora, no provedor de rastreamento, no seu receptor de webhook ou no processamento posterior.
Defina o que significa uma atualização de rastreamento confiável
Comece pelo caminho completo da entrega: registro da remessa, recuperação pelo provedor, resposta da API ou entrega do webhook, processamento interno, persistência no banco de dados e exibição voltada ao cliente. Se você enviar notificações, trate isso como outra etapa, em vez de presumir que uma atualização salva chegou ao comprador.
Para cada etapa, registre seu responsável e as evidências que comprovam o sucesso. Um provedor aceitar um número de rastreamento prova que o registro foi aceito, não que uma transportadora publicou um evento. Um webhook receber uma resposta HTTP bem-sucedida prova que seu endpoint o confirmou, não necessariamente que seu worker gravou a atualização.
As orientações de SRE do Google descrevem latência, tráfego, erros e saturação como os quatro sinais dourados do monitoramento. Esses sinais são úteis para sua infraestrutura de integração, mas o rastreamento de remessas também exige verificações de atualização e completude, pois um endpoint aparentemente saudável pode fornecer informações inalteradas ou incompletas.
| Camada | Pergunta a responder | Evidências a coletar |
|---|---|---|
| Disponibilidade da API | A integração consegue concluir uma operação válida? | Resultado do transporte, resultado da aplicação, latência, taxa de timeout |
| Atualização dos dados | Quanto as informações estão atrasadas? | Horário do evento, horário da observação, horário do recebimento, horário da persistência |
| Completude das atualizações | Todas as atualizações esperadas e recuperáveis chegaram ao destino? | Diferenças de reconciliação, registros de processamento, lacunas não resolvidas |
| Visibilidade para o cliente | O status exibido corresponde ao estado armazenado da remessa? | Verificações do caminho de leitura, idade do cache, resultados do processamento de notificações |
Instrumente a integração antes de configurar alertas
Mantenha um registro operacional que conecte uma remessa à sua tentativa de registro, às atualizações recebidas, às tentativas de processamento e ao estado resultante. Use um identificador interno da remessa para correlação; mantenha números de rastreamento e dados dos clientes fora de logs amplamente acessíveis sempre que possível.
O registro mínimo útil inclui:
- ID interno da remessa, identificador da transportadora quando conhecido, conta da integração e ambiente.
- ID da solicitação ou de correlação, tipo de operação, horário da tentativa, categoria do resultado e duração.
- ID do evento do provedor quando fornecido, além do carimbo de data e hora original do evento e das informações de fuso horário.
- Horário de recebimento do webhook, horário do armazenamento durável, horário de conclusão do processamento e horário de disponibilidade para exibição, quando mensurável.
- Versão do esquema do payload quando disponível, resultado da análise, resultado da deduplicação e motivo da falha.
Preserve o payload original sob controles adequados de acesso e retenção quando ele for necessário para investigação ou reprocessamento. Não registre cabeçalhos de autorização nem segredos. Use dimensões limitadas, como transportadora e categoria do resultado, para métricas; números de rastreamento individuais pertencem a registros pesquisáveis, não a rótulos de métricas de alta cardinalidade.
Mantenha o horário do evento separado do horário da observação. O modelo de dados de logs do OpenTelemetry faz essa distinção explicitamente por meio de Timestamp e ObservedTimestamp. Aplicar a mesma distinção aos registros de rastreamento ajuda a evitar que um evento da transportadora relatado tardiamente seja confundido com uma gravação lenta no banco de dados.
Monitore a disponibilidade do ponto de vista da sua aplicação
Use tanto o tráfego real de produção quanto uma verificação sintética de baixo volume. O tráfego de produção revela o impacto real para os clientes. Uma verificação sintética pode detectar falhas quando o tráfego de produção está baixo, desde que use uma operação documentada e não destrutiva e respeite os limites de uso do provedor.
Um indicador útil de sucesso das solicitações é:
Operações elegíveis bem-sucedidas / Todas as operações elegíveis tentadas
Defina “bem-sucedida” usando tanto o status HTTP quanto o resultado documentado no nível da aplicação. Algumas interfaces podem retornar uma resposta HTTP bem-sucedida enquanto informam uma operação malsucedida no corpo. Para operações em lote, meça os resultados no nível dos itens, além dos resultados no nível da solicitação.
Mantenha duas visões das falhas. A visão de impacto para o cliente inclui tudo que impede sua aplicação de concluir sua tarefa. A visão de diagnóstico separa erros do provedor, falhas de rede, problemas de autenticação, entradas inválidas e respostas de cota ou limite de taxa. Uma credencial expirada pode não ser uma indisponibilidade do provedor, mas ainda assim é uma indisponibilidade para sua integração.
- Latência: acompanhe p50, p95 e p99 quando o volume de tráfego permitir percentis significativos. Meça os timeouts separadamente para que falhas rápidas não façam a latência parecer saudável.
- Tráfego: compare o volume de solicitações e callbacks com os registros de remessas e a população de remessas ativas.
- Erros: separe falhas de transporte, falhas da aplicação, erros de análise e falhas de persistência posterior.
- Saturação: monitore pools de conexões, capacidade dos workers, profundidade da fila, item mais antigo na fila e orçamento de solicitações disponível.
Não apresente essas medições como a disponibilidade contratual do provedor, a menos que elas usem as definições exatas do contrato. A disponibilidade observada da sua integração e o acordo de nível de serviço de um fornecedor respondem a perguntas diferentes.
Meça a atualização sem confundir silêncio com falha
Uma remessa que não se movimentou não está automaticamente desatualizada. Trânsito internacional, transferências, fins de semana e práticas de digitalização das transportadoras podem produzir lacunas legítimas. O problema de monitoramento é distinguir “nada novo aconteceu” de “há novas informações, mas nosso sistema ainda não as recebeu”.
Use relógios separados para atrasos separados
- Idade do evento mais recente: horário atual menos o horário do evento mais recente da transportadora. Isso descreve a visibilidade da remessa, não necessariamente o desempenho da integração.
- Atraso no recebimento: seu horário de recebimento menos o horário do evento. Isso inclui atrasos de relatório e recuperação upstream quando os carimbos intermediários de data e hora não estão disponíveis.
- Atraso no processamento interno: horário de conclusão do processamento durável menos o horário de recebimento. Isso isola o trabalho dentro do seu sistema.
- Atraso na exibição: horário de disponibilidade para o cliente menos o horário de conclusão do processamento. Isso pode revelar problemas de cache ou do modelo de leitura.
- Idade da verificação: horário atual menos a última verificação bem-sucedida de informações mais recentes. Isso mede a atividade de verificação, não prova que o feed da transportadora está atualizado.
Calcule o atraso de ingestão específico do provedor somente se o carimbo de data e hora necessário existir e seu significado estiver documentado. Sem isso, o atraso no recebimento não pode ser atribuído de forma justa a uma única parte.
Normalize os carimbos de data e hora para um fuso horário consistente, preservando sua representação original. Sinalize informações de fuso horário ausentes, eventos com data futura e inconsistências de relógio. Não converta silenciosamente um atraso negativo em zero; investigue-o ou classifique-o como um problema de qualidade do carimbo de data e hora.
Compare remessas semelhantes
Crie visões de atualização por transportadora, serviço ou rota quando conhecidos, status da remessa e tempo desde o registro. Separe remessas recém-registradas aguardando seu primeiro evento das remessas já em trânsito. Exclua remessas entregues das verificações de movimentação ativa de acordo com suas regras operacionais, mantendo qualquer monitoramento pós-entrega exigido pelo seu fluxo de trabalho.
Defina os limites iniciais com base nos requisitos comerciais e no comportamento observado, não em um intervalo universal de atualização inventado. Um limite adequado para uma entrega local pode gerar ruído em uma transferência internacional. Por outro lado, uma média ampla da rede pode ocultar um problema que afeta uma única transportadora.
Identifique a cobertura em cada painel de atualização. Se os carimbos de data e hora dos eventos estiverem ausentes para parte da população, mostre essa população separadamente, em vez de fazer com que as remessas restantes pareçam representativas de todo o tráfego.
Encontre atualizações perdidas por meio da reconciliação
O volume de webhooks, por si só, não pode estabelecer a completude. Um tráfego reduzido pode ser normal, e uma resposta bem-sucedida do webhook pode ocultar uma falha no processamento posterior. A reconciliação compara o que uma fonte de referência expõe atualmente com o que seu sistema realmente armazenou ou processou.
- Defina a população elegível. Inclua remessas registradas e monitoradas ativamente. Acompanhe registros rejeitados e monitoramento pausado separadamente para que não desapareçam dos relatórios operacionais.
- Selecione uma referência. Quando a API documentada permitir, recupere os detalhes atuais do rastreamento independentemente da ingestão do webhook. As páginas de rastreamento das transportadoras podem ajudar a investigar casos individuais, mas não devem se tornar uma dependência automatizada de scraping sem autorização.
- Aplique um período de tolerância. Permita atrasos normais de entrega e processamento antes de classificar uma diferença como uma possível lacuna.
- Compare elementos equivalentes. Faça a correspondência usando identificadores de eventos compatíveis ou uma regra de normalização documentada para carimbos de data e hora, status, locais e descrições.
- Recupere com segurança. Reprocesse mensagens retidas ou busque atualizações permitidas pelo caminho normal de processamento idempotente.
- Confirme o destino. Verifique se o banco de dados e a visualização voltada ao cliente foram corrigidos, não apenas se um job de recuperação foi executado.
Um indicador interno pode ser expresso como:
Remessas elegíveis reconciliadas com diferenças não resolvidas / Todas as remessas elegíveis reconciliadas
Chame isso de taxa de lacunas de reconciliação não resolvidas, não de taxa universal de eventos perdidos. Se a referência expuser apenas o estado mais recente, ela não poderá provar que todos os eventos históricos chegaram. Mesmo um status final correspondente pode ocultar a perda de um marco intermediário.
Comece com uma amostra estratificada entre transportadoras, idades das remessas e status. Amplie a cobertura dos segmentos afetados durante um incidente, sujeito aos limites documentados. Informe tanto o número verificado quanto o número com diferenças para que uma amostra pequena não seja confundida com cobertura completa.
Torne a ingestão de webhooks recuperável
Projete o receptor para validar as solicitações recebidas e capturar de forma durável as mensagens aceitas antes de confirmá-las, de acordo com o contrato de entrega documentado pelo provedor. Mantenha a lógica comercial mais lenta em um worker separado sempre que possível.
Verifique as regras reais da integração em vez de presumi-las: autenticação ou validação de assinatura, requisitos de confirmação, timeout da solicitação, condições de nova tentativa, duração das novas tentativas, ordenação e disponibilidade de reprocessamento. Esses detalhes determinam qual recuperação sua aplicação deve fornecer.
- Inclua duplicatas no projeto: use um ID de evento documentado quando disponível. Caso contrário, crie uma chave de deduplicação cuidadosamente delimitada e teste-a com eventos semelhantes legítimos.
- Lide com a entrega fora de ordem: preserve o histórico de eventos e use regras explícitas de transição, em vez de substituir cegamente o estado da remessa pela última mensagem recebida.
- Isole as falhas: retenha mensagens não processáveis com seus detalhes de erro e forneça um processo controlado de reenvio.
- Separe a recuperação do estado dos efeitos colaterais: reprocessar um evento não deve reenviar automaticamente um e-mail antigo de entrega nem repetir outra ação voltada ao cliente.
Se sua integração usa 17TRACK, use a documentação oficial da Tracking API como referência de implementação e verifique os requisitos aplicáveis à sua integração. A página do produto Tracking API fornece contexto sobre o produto, mas os limites de monitoramento e as premissas de recuperação devem vir do comportamento documentado, do seu contrato de serviço e das medições de produção, não das descrições do produto.
Transforme painéis em alertas acionáveis
Cada alerta deve identificar a população afetada, a provável etapa da falha, o impacto comercial e o primeiro passo da investigação. Um alerta global de “o rastreamento está desatualizado” raramente fornece informações suficientes para agir.
| Padrão do sinal | Primeira investigação | Responsável principal |
|---|---|---|
| As solicitações falham em várias transportadoras | Verifique credenciais, rede, limites e respostas do provedor | Equipe de integração ou plantão da plataforma |
| Os callbacks chegam, mas a idade do processamento aumenta | Inspecione workers, integridade do banco de dados e mensagens isoladas | Engenharia de aplicações |
| Uma transportadora apresenta lacunas incomuns de atualização | Compare grupos e amostre registros de rastreamento de referência | Operações de rastreamento com engenharia |
| O estado armazenado está atualizado, mas a exibição está antiga | Inspecione caches, modelos de leitura e recuperação no frontend | Equipe da aplicação voltada ao cliente |
Use violações sustentadas e tamanhos mínimos de amostra para reduzir o ruído. Para objetivos de disponibilidade e processamento, um orçamento de erros pode ajudar a distinguir uma anomalia breve de uma falha que consome uma parcela inaceitável dos erros permitidos. Mantenha os objetivos de atualização dos dados da transportadora separados dos objetivos diretamente controlados pela sua equipe de engenharia.
Use um manual de recuperação que comprove a conclusão
Quando um incidente começar, estabeleça o último ponto conhecido como saudável e preserve os registros relevantes. Determine se novos registros, mensagens recebidas, processamento ou atualizações de exibição foram afetados. Em seguida, estime a população de remessas em risco, em vez de informar apenas a quantidade de solicitações.
Restaure a etapa com falha, reprocesse ou busque novamente dentro dos limites documentados e execute a reconciliação da população afetada. Encerre o incidente somente depois que a idade do backlog voltar ao normal, as lacunas não resolvidas forem contabilizadas e o estado voltado ao cliente for verificado. Registre separadamente todas as atualizações históricas que não puderem ser recuperadas.
Teste esse processo com falhas controladas: receptor indisponível, payload malformado, indisponibilidade do worker, evento duplicado, evento fora de ordem e credencial expirada. Um teste é aprovado quando a equipe detecta o problema, identifica seu responsável, recupera os dados e evita efeitos colaterais duplicados, não simplesmente quando o endpoint volta a ser acessível.
FAQ
Uma API pode retornar respostas bem-sucedidas enquanto as informações de rastreamento estão desatualizadas?
Sim. O sucesso da solicitação estabelece que uma operação foi concluída de acordo com as regras da interface. Ele não estabelece que uma transportadora publicou uma nova leitura ou que todos os sistemas posteriores processaram o resultado. Monitore a atualização e o processamento de ponta a ponta separadamente.
Com que frequência devemos reconciliar as remessas?
Escolha uma periodicidade com base no atraso de detecção aceitável, no volume de remessas ativas, no orçamento de solicitações e nos limites documentados. Use verificações mais frequentes para segmentos operacionalmente sensíveis e uma varredura programada mais ampla para obter cobertura. Não existe um único intervalo adequado para todas as transportadoras e fluxos de trabalho.
A ausência de atividade do webhook significa que a integração está quebrada?
Não. Pode não haver novos eventos. Compare a atividade dos callbacks com a população de remessas ativas, os padrões recentes, a integridade do receptor e uma verificação de recuperação independente quando houver suporte. Gere alertas com base em evidências corroborativas, não apenas no silêncio.
Devemos fazer polling continuamente como backup?
Não por padrão. O polling não controlado pode consumir a capacidade de solicitações sem melhorar a visibilidade. Use reconciliação limitada e recuperação específica do incidente dentro dos limites documentados. Confirme como o polling e a entrega de webhooks interagem para o seu provedor.
O que devemos enviar ao escalar um possível problema do provedor?
Inclua os tipos de operação afetados, intervalos de tempo em UTC, IDs de solicitação sanitizados, códigos de resposta, referências representativas de remessas por meio de um canal seguro aprovado e o comportamento esperado em comparação com o observado. Explique quais etapas internas você verificou. Não inclua credenciais nem dados desnecessários dos clientes.
Fontes
- Google SRE: Monitoring Distributed Systems — os quatro sinais dourados e os princípios de monitoramento.
- OpenTelemetry: Logs Data Model — a distinção entre carimbos de data e hora de eventos e de observações.
- Documentação da Tracking API do 17TRACK — a referência de implementação para uma integração com o 17TRACK.
- 17TRACK Tracking API — contexto oficial do produto.