Skalowalność API śledzenia: jak obsługiwać wolumen w szczycie sezonu, limity liczby żądań i rejestrację zbiorczą
Aby skalować API śledzenia w szczycie sezonu, umieść rejestrację przesyłek za trwałą kolejką, egzekwuj limity dostawcy wśród wszystkich procesów roboczych, stosuj grupowanie wyłącznie w ramach udokumentowanych limitów i przetwarzaj aktualizacje śledzenia asynchronicznie. Traktuj przepustowość rejestracji, ruch ponowień oraz przetwarzanie webhooków jako oddzielne problemy z zakresu wydajności. Dodanie większej liczby procesów roboczych bez kontrolowania żądań wychodzących może zwiększyć ograniczanie przepustowości zamiast opróżnić zaległości.
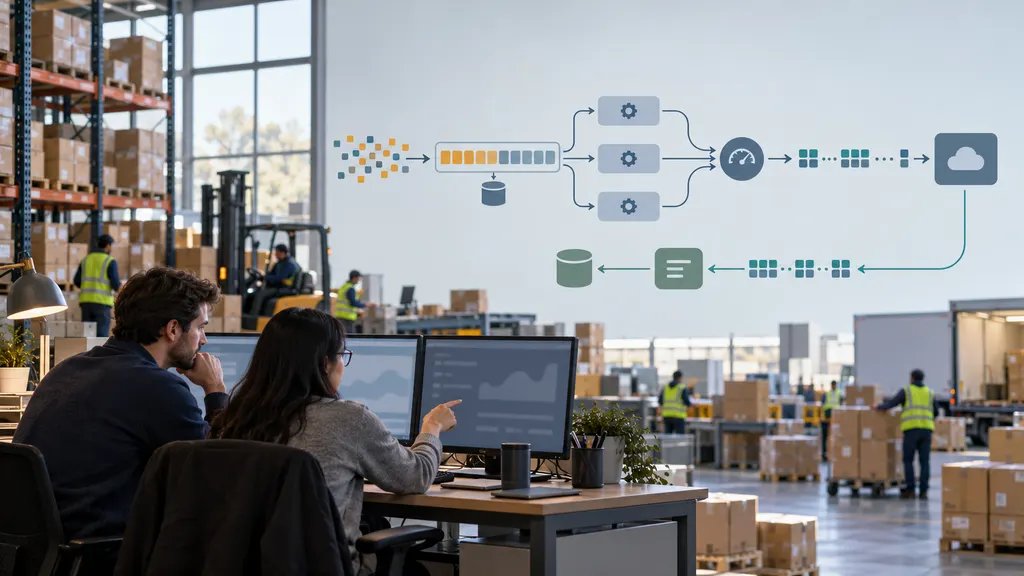
W przypadku zespołów inżynieryjnych łączących system zarządzania zamówieniami, platformę magazynową lub zaplecze sklepu internetowego z usługą śledzenia celem nie jest po prostu wysyłanie większej liczby żądań. Chodzi o rejestrowanie przesyłek w określonym przedziale czasu, zachowanie aktualizacji podczas skoków ruchu oraz odzyskiwanie sprawności po awariach bez tworzenia zduplikowanej pracy.
Dopasuj obciążenie do przesyłek, żądań i aktualizacji
Dzienny wolumen przesyłek nie wystarcza do określenia rozmiaru integracji. Magazyn może zwolnić większość numerów śledzenia w krótkim oknie wysyłkowym, podczas gdy aktualizacje statusu napływają przez cały dzień. Modeluj te obciążenia oddzielnie.
- Napływ rejestracji: Nowe rekordy przesyłek wprowadzane do systemu na sekundę lub minutę, w tym importy i skoki związane ze zwalnianiem przesyłek przez magazyn.
- Ruch wychodzący API: Żądania rejestracji, wyszukiwania, korekty, wywołania uzgadniające i ponowienia.
- Ruch przychodzących aktualizacji: Dostarczenia webhooków i ich ponowne dostarczenia, jeśli dostawca je obsługuje.
- Praca downstream: Zapisy w bazie danych, powiadomienia klientów, zdarzenia analityczne i zmiany statusu zamówień wywoływane przez każdą aktualizację.
Ustal wewnętrzny cel rejestracji, na przykład maksymalny akceptowalny czas między otrzymaniem numeru śledzenia a potwierdzeniem jego rejestracji. Oddziel go od aktualności śledzenia: pomyślna rejestracja nie oznacza, że skan przewoźnika jest już dostępny.
Oblicz efektywną przepustowość rejestracji
W przypadku punktu końcowego rejestracji ograniczonego liczbą żądań przydatna zależność planistyczna wygląda następująco:
Przepustowość rejestracji = dozwolona liczba żądań na sekundę × średnia liczba rekordów na żądanie × udział pomyślnych rekordów
Jest to szacunek planistyczny, a nie gwarancja dostawcy. Zakłada, że limity żądań stanowią ograniczenie wiążące. Limity oparte na rekordach, rozmiar ładunku, opóźnienia i współdzielone limity konta mogą narzucać niższy pułap.
Wyłącznie dla celów ilustracyjnych załóżmy, że integracja może wykonywać dwa żądania rejestracji na sekundę i wysyła średnio 30 rekordów w każdym żądaniu. Jej nominalna przepustowość wynosi 60 rekordów na sekundę przed uwzględnieniem awarii i innych ograniczeń. Jeśli podczas utrzymującego się skoku napływających rejestracji jest średnio 80 rekordów na sekundę, kolejka rośnie o około 20 rekordów na sekundę. Są to wartości hipotetyczne, a nie limity 17TRACK.
Oblicz również przepustowość odzyskiwania. Jeśli nowe rekordy napływają z szybkością λ, a efektywna przepustowość przetwarzania wynosi μ, istniejąca zaległość B rekordów zostanie opróżniona w przybliżeniu w czasie B / (μ − λ) sekund, gdy μ > λ. Jeśli przepustowość przetwarzania nie przewyższa napływu, zaległość nie zostanie opróżniona w tych warunkach.
Potwierdź, co faktycznie ogranicza dostawca
Limit szybkości i limit wykorzystania rozwiązują różne problemy. Limit szybkości kontroluje, jak szybko można przesyłać żądania lub rekordy. Limit wykorzystania może kontrolować ilość aktywności związanej ze śledzeniem, którą konto może zużyć w okresie rozliczeniowym lub okresie obowiązywania uprawnień. Pozostawanie poniżej jednego limitu nie oznacza zgodności z drugim.
Przed ustaleniem liczby procesów roboczych potwierdź poniższe informacje w dokumentacji dostawcy i warunkach konta:
- Czy limity dotyczą konta, klucza API, punktu końcowego, adresu IP lub innego zakresu.
- Czy zliczaną jednostką jest żądanie, rekord śledzenia czy inna operacja.
- Czy punkty końcowe współdzielą limit, czy mają niezależne przydziały.
- Maksymalna liczba rekordów i rozmiar ładunku dozwolone w jednym żądaniu.
- Jak zduplikowane przesłania, nieprawidłowe rekordy i ponowienia wpływają na wykorzystanie.
- Czy odpowiedzi ujawniają informacje o ograniczaniu przepustowości lub wskazówki dotyczące ponawiania.
- Czym wyczerpanie limitu różni się od tymczasowego ograniczania przepustowości.
W przypadku integracji z 17TRACK użyj oficjalnej strony Tracking API oraz dokumentacji API jako punktów wyjścia do tej konfiguracji. Przed wdrożeniem potwierdź zachowanie odpowiedniego punktu końcowego i limity konta. Przykładowe przepustowości w tym poradniku są ilustracjami architektury, a nie stwierdzeniami dotyczącymi uprawnień 17TRACK, rozmiarów partii ani gwarancji usługi.
Umieść trwałą kolejkę między przetwarzaniem zamówień a rejestracją
Nie zmuszaj procesu realizacji zakupu ani zakończenia operacji magazynowych do oczekiwania, aż dostawca śledzenia zaakceptuje rejestrację. Zapisz przesyłkę lokalnie, trwale zarejestruj zadanie rejestracji i pozwól procesom roboczym w tle obsługiwać wysyłanie.
Praktyczny przepływ wygląda następująco:
- Zapisz przesyłkę i zamiar jej rejestracji. Użyj transakcyjnego outboxa lub równoważnego rozwiązania, aby uniknąć zapisania zamówienia przy jednoczesnej utracie zadania w tle.
- Zweryfikuj i ujednolić dane wejściowe. Zachowaj numery śledzenia jako ciągi znaków, w tym początkowe zera. Stosuj normalizację zależną od przewoźnika tylko wtedy, gdy jest uzasadniona.
- Sprawdź, czy rejestracja już istnieje. Użyj stabilnej tożsamości odpowiedniej dla dostawcy i modelu danych.
- Umieść kwalifikujące się rekordy w kolejce. Zapisz liczbę prób, czas następnej kwalifikującej próby oraz wystarczający kontekst do diagnozy.
- Wysyłaj przez współdzielony limiter. Przydzielaj przepustowość bezpośrednio przed żądaniem wychodzącym.
- Trwale zapisuj wyniki na poziomie rekordu. Rozdziel potwierdzony sukces, błąd możliwy do ponowienia, trwałe odrzucenie i niejednoznaczne wyniki.
Kolejka pochłania skok ruchu; nie tworzy przepustowości dostawcy. Jeśli najstarszy kwalifikujący się rekord stale się starzeje, zbadaj różnicę między szybkością napływu a przepustowością przetwarzania, zamiast po prostu zwiększać liczbę procesów roboczych.
Koordynuj limity między procesami roboczymi
Niezależne procesy robocze nie mogą zakładać, że każdy z nich może wykorzystać pełny limit konta. Użyj skoordynowanego limitera szybkości lub dyspozytora przydzielającego współdzielony budżet żądań. Uwzględnij w tym budżecie zaplanowane importy, skrypty operacyjne i zadania uzgadniające.
Szybkość i współbieżność to różne mechanizmy kontroli. Limiter kontroluje, jak często rozpoczynają się żądania, a limit współbieżności kontroluje, ile z nich pozostaje w toku. Oba mechanizmy są przydatne, gdy rosną opóźnienia dostawcy. Zwiększenie współbieżności może pomóc w przypadku obciążenia ograniczonego opóźnieniami, ale nie może ominąć limitu szybkości żądań wychodzących.
Korzystaj z rejestracji zbiorczej bez utraty kontroli na poziomie rekordu
Jeśli punkt końcowy obsługuje wiele rekordów w jednym żądaniu, grupowanie może ograniczyć narzut związany z żądaniami. Nie musi jednak zmniejszać wykorzystania opartego na rekordach, a największa dozwolona partia nie zawsze jest najlepszym wyborem operacyjnym.
Twórz partie przy użyciu dwóch wyzwalaczy: maksymalnej liczby rekordów i maksymalnego czasu oczekiwania. Wysyłaj je po osiągnięciu któregokolwiek z nich. Dzięki temu okresy dużego ruchu efektywnie zapełniają partie, a ruch o małym wolumenie nie musi czekać bez końca.
- Przestrzegaj limitów ładunku, a także liczby rekordów. Opcjonalne metadane mogą sprawić, że partie o tej samej liczbie rekordów będą znacznie różnić się rozmiarem w bajtach.
- Prowadź wewnętrzny manifest partii. Zapisuj, które lokalne tożsamości przesyłek zostały wysłane, i prawidłowo przypisuj każdy zwrócony wynik.
- Sprawdzaj wyniki na poziomie aplikacji. Pomyślna odpowiedź HTTP sama w sobie nie dowodzi, że każdy rekord został zaakceptowany.
- Ponawiaj tylko te rekordy, które wymagają ponowienia. Ponowne odtwarzanie pomyślnych rekordów tworzy niepotrzebny ruch i może mieć konsekwencje związane z wykorzystaniem.
- Kieruj trwałe błędy walidacji do korekty. Niezmieniony nieprawidłowy ładunek nie powinien krążyć w kolejce ponowień.
Szczególnie ważna jest obsługa limitu czasu: dostawca mógł zaakceptować żądanie, mimo że klient nie otrzymał odpowiedzi. Oznacz taki wynik jako niejednoznaczny. Rozstrzygnij go za pomocą obsługi idempotencji, udokumentowanej reguły dotyczącej zduplikowanej rejestracji lub wyszukiwania uzgadniającego, jeśli jest dostępne. Nie zakładaj, że zapis, dla którego upłynął limit czasu, zakończył się niepowodzeniem.
Oddziel ruch bieżący od importów historycznych
Uzupełnianie danych nie powinno zużywać całej przepustowości potrzebnej dla nowo wysłanych przesyłek. Używaj oddzielnych kolejek z harmonogramowaniem ważonym lub jawnymi rezerwacjami przepustowości. Pozwól importom korzystać z wolnej przepustowości, zachowując minimalny przydział dla bieżących rejestracji. Stosuj regułę starzenia lub inną regułę sprawiedliwości, aby rekordy o niższym priorytecie zostały ostatecznie przetworzone.
Kontroluj ponowienia, opóźniaj je i ograniczaj
HTTP 429 oznacza „Too Many Requests”. RFC 6585 określa, że odpowiedź 429 może zawierać nagłówek Retry-After. RFC 9110 definiuje wartość tego nagłówka jako datę HTTP lub opóźnienie w sekundach. Klient powinien analizować obie formy, zamiast zakładać, że zawsze zwracana jest liczba całkowita.
Gdy dostarczono prawidłowe opóźnienie ponowienia, nie ponawiaj żądania przed jego upływem. Gdy brakuje wskazówek dotyczących ponawiania, użyj ograniczonego wykładniczego wycofywania z losowym składnikiem: stopniowo zwiększaj opóźnienie między próbami i dodaj losowość, aby procesy robocze nie ponawiały żądań jednocześnie. Ponowienia muszą przechodzić przez ten sam limiter żądań wychodzących co pierwsze próby.
Przed ponowieniem sklasyfikuj błędy:
- Ograniczanie przepustowości: Opóźnij dotkniętą pracę i zmniejsz presję wysyłania w ramach odpowiedniego zakresu limitu.
- Przejściowe awarie sieci lub serwera: Ponawiaj w ramach ograniczonej polityki, uwzględniając niejednoznaczne wyniki zapisów.
- Błędy uwierzytelniania lub autoryzacji: Wygeneruj alert i wstrzymaj dotkniętą pracę do czasu skorygowania danych uwierzytelniających lub uprawnień.
- Błędy walidacji: Popraw lub odizoluj rekord, zamiast wysyłać go ponownie bez zmian.
- Wyczerpany limit wykorzystania: Postępuj zgodnie z udokumentowanym rozwiązaniem dotyczącym konta, zamiast traktować ten stan jako krótkotrwały skok ruchu.
Ustal zarówno limit prób, jak i maksymalny wiek ponowienia. Przenoś wyczerpane elementy do kolejki niedostarczalnych wiadomości wraz z przyczyną, właścicielem i procedurą ponownego odtworzenia. W przeciwnym razie stare awarie mogą po cichu zużywać przepustowość przeznaczoną dla nowych przesyłek.
Skaluj odbiór webhooków niezależnie
Jeśli dostawca oferuje odpowiednie webhooki, mogą one ograniczyć powtarzane odpytywanie statusu. Tworzą jednak również oddzielne obciążenie przychodzące, które musi pozostać dostępne podczas skoków aktualizacji.
Utrzymuj punkt końcowy odbioru w wąskim zakresie: zweryfikuj żądanie za pomocą udokumentowanego mechanizmu dostawcy, trwale zapisz zdarzenie i zwróć wymagane potwierdzenie. Przetwarzaj zmiany zamówień, analitykę i wiadomości do klientów asynchronicznie. Nie potwierdzaj odbioru przed trwałym zaakceptowaniem zdarzenia, jeśli mogłoby to doprowadzić do jego utraty.
Projektuj konsumentów tak, aby tolerowali zduplikowane dostarczenia, chyba że umowa z dostawcą wyraźnie stanowi inaczej. Do deduplikacji preferuj udokumentowany stabilny identyfikator zdarzenia. Jeśli go nie ma, starannie zaprojektuj i przetestuj tożsamość złożoną: użycie wyłącznie etykiety statusu może połączyć różne zdarzenia w jedno.
Chroń się również przed aktualizacjami przychodzącymi poza kolejnością. Przechowuj historię zdarzeń oddzielnie od wyliczonego bieżącego stanu przesyłki. W miarę dostępności stosuj udokumentowane znaczniki czasu zdarzeń i reguły przejść; nie zakładaj, że kolejność nadejścia jest kolejnością zdarzeń ani że statusy przesyłki tworzą uniwersalnie rosnący ciąg.
Utrzymuj ukierunkowane i ograniczone szybkościowo uzgadnianie. Może ono badać podejrzewane luki w dostarczeniach lub niejednoznaczne rejestracje, ale agresywne odpytywanie każdej przesyłki może odtworzyć obciążenie wychodzące, którego webhooki miały pomóc uniknąć.
Testuj odzyskiwanie, a nie tylko maksymalną przepustowość
Przeprowadzaj testy obciążeniowe własnych komponentów za pomocą symulatora dostawcy. Koordynuj testy wysyłające znaczny ruch do działającego dostawcy i przestrzegaj autoryzowanych limitów. Pomyślny test powinien wykazać, że system wraca do normalnego działania po zakłóceniu, a nie tylko że przyjmuje duży skok ruchu.
- Odtwórz skok ruchu w stylu magazynowym, po którym następuje ciągły normalny ruch.
- Wstrzyknij odpowiedzi ograniczające przepustowość, podwyższone opóźnienia i tymczasowe awarie serwera.
- Symuluj częściowe odrzucenie partii i przekroczenie limitu czasu po zaakceptowaniu po stronie serwera.
- Dostarcz zduplikowane i uporządkowane poza kolejnością zdarzenia webhooków.
- Przerwij dostęp do bazy danych i sprawdź, czy niezaakceptowane zdarzenia nie są fałszywie potwierdzane.
- Uruchom uzupełnianie danych równolegle z bieżącymi rejestracjami i sprawdź sprawiedliwość.
- Odtwórz elementy z kolejki niedostarczalnych wiadomości bez omijania kontroli szybkości.
Monitoruj wiek najstarszej kwalifikującej się rejestracji, opóźnienie akceptacji, wskaźnik sukcesu na poziomie rekordu, częstotliwość ograniczania przepustowości, wolumen ponowień, opóźnienie przetwarzania webhooków i wzrost kolejki niedostarczalnych wiadomości. Sama głębokość kolejki jest niewystarczająca: duża kolejka może szybko się opróżnić, podczas gdy mała kolejka może zawierać kilka wielokrotnie kończących się niepowodzeniem, krytycznych biznesowo przesyłek.
Przed szczytem sezonu przypisz odpowiedzialność operacyjną. Zespół inżynieryjny powinien odpowiadać za kontrolę wysyłania i narzędzia odzyskiwania; właściciel integracji powinien potwierdzić uprawnienia u dostawcy; dział operacyjny powinien określić, które przesyłki mają priorytet. Udokumentuj, kiedy wstrzymać importy, poprosić o dodatkową przepustowość lub zbadać brakujące aktualizacje. Najlepszy projekt to taki, który pozostaje przewidywalny, gdy ruch przekracza jego bieżącą przepustowość przetwarzania.
FAQ
Czy dodanie kluczy API zwiększy przepustowość?
Niekoniecznie. Wiele kluczy może współdzielić limit konta. Potwierdź zakres limitu i dozwolone podejście do skalowania u dostawcy. Nie używaj rotacji kluczy do omijania ograniczeń.
Czy każda rejestracja powinna korzystać z największej możliwej partii?
Nie. Większe partie mogą poprawić efektywność żądań, ale oczekiwanie na ich zapełnienie zwiększa opóźnienie przy małym wolumenie. Użyj udokumentowanego limitu rozmiaru wraz z zegarem opróżniania, a następnie dostosuj ustawienia na podstawie zmierzonego opóźnienia akceptacji i zachowania podczas awarii.
Jak zapobiegać zduplikowanym rejestracjom po przekroczeniu limitu czasu?
Użyj trwałej lokalnej tożsamości przesyłki oraz udokumentowanego mechanizmu idempotencji lub obsługi duplikatów przez dostawcę. Jeśli wynik pozostaje niepewny, przed ponownym odtworzeniem uzgodnij go tam, gdzie jest to obsługiwane. Sama lokalna deduplikacja nie może dowieść, czy zdalne żądanie zakończyło się powodzeniem.
Czy pomyślna rejestracja oznacza, że informacje o śledzeniu są aktualne?
Nie. Akceptacja rejestracji, dostępność zdarzenia przewoźnika, przetwarzanie przez dostawcę i własne przetwarzanie aktualizacji to oddzielne etapy. Mierz je osobno, aby opóźniony skan przewoźnika nie został pomylony z zaległością rejestracji.
Kiedy zespół powinien poprosić o większą przepustowość dostawcy?
Poproś o nią, gdy prognozowany napływ i wymagany czas odzyskiwania przekraczają zweryfikowaną użyteczną przepustowość po usunięciu możliwych do uniknięcia ponowień, zduplikowanych przesłań i nieefektywnego grupowania. Większy limit nie naprawi zablokowanego konsumenta ani wąskiego gardła w bazie danych, dlatego najpierw zidentyfikuj ograniczenie wiążące.
Źródła
- 17TRACK Tracking API — oficjalny punkt wejścia do oferty API.
- Dokumentacja API 17TRACK — źródło informacji o wymaganiach integracji, zachowaniu punktów końcowych i obowiązujących ograniczeniach żądań.
- RFC 6585, sekcja 4: 429 Too Many Requests — semantyka ograniczania HTTP i opcjonalne wskazówki Retry-After.
- RFC 9110, sekcja 10.2.3: Retry-After — formaty daty HTTP i opóźnienia w sekundach.
- RFC 9110, sekcja 9.2.2: Metody idempotentne — kwestie ponawiania, gdy wynik żądania jest niepewny.