ความสามารถในการปรับขนาดของ Tracking API: วิธีรับมือกับปริมาณการใช้งานในช่วงพีก ขีดจำกัดอัตราการเรียกใช้ และการลงทะเบียนจำนวนมาก
เพื่อปรับขนาด Tracking API ให้รองรับช่วงพีคซีซัน ให้นำการลงทะเบียนพัสดุไปไว้หลังคิวที่มีความทนทาน บังคับใช้ข้อจำกัดของผู้ให้บริการกับ worker ทั้งหมด ทำ batching เฉพาะภายในขีดจำกัดที่ระบุไว้ในเอกสาร และประมวลผลการอัปเดตการติดตามแบบอะซิงโครนัส ให้ถือว่าปริมาณงานการลงทะเบียน ปริมาณทราฟฟิกจากการ retry และการประมวลผล webhook เป็นปัญหาด้านความจุที่แยกจากกัน การเพิ่ม worker โดยไม่ควบคุมคำขอขาออกอาจทำให้เกิดการจำกัดอัตรามากขึ้น แทนที่จะช่วยเคลียร์งานค้าง
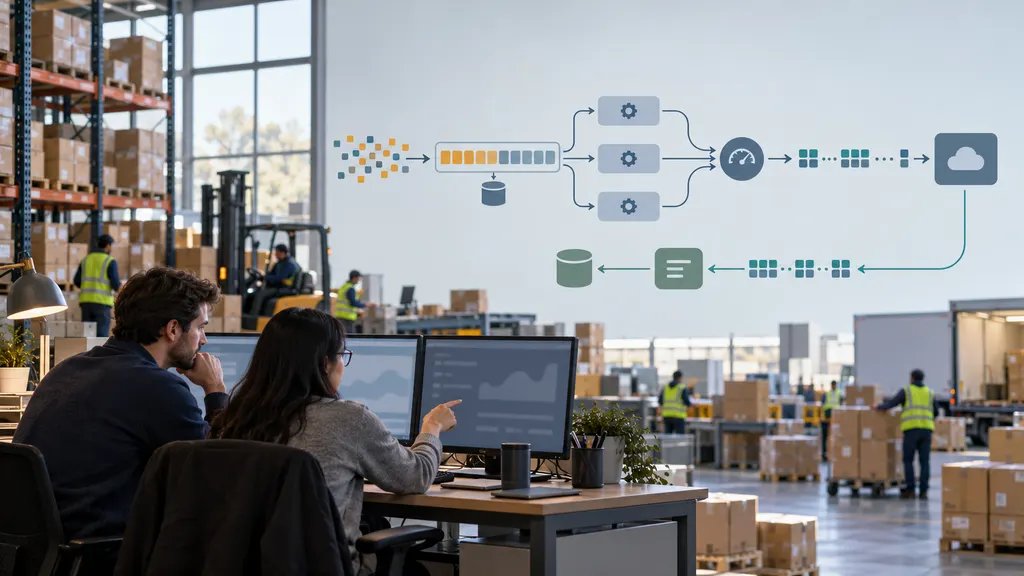
สำหรับทีมวิศวกรรมที่เชื่อมต่อระบบจัดการคำสั่งซื้อ แพลตฟอร์มคลังสินค้า หรือแบ็กเอนด์อีคอมเมิร์ซเข้ากับบริการติดตาม เป้าหมายไม่ใช่เพียงการส่งคำขอให้มากขึ้น แต่คือการลงทะเบียนพัสดุภายในช่วงเวลาที่กำหนด รักษาการอัปเดตไว้ในช่วงที่ทราฟฟิกพุ่งสูง และกู้คืนจากความล้มเหลวโดยไม่สร้างงานซ้ำซ้อน
ประเมินขนาด workload จากพัสดุ คำขอ และการอัปเดต
ปริมาณพัสดุรายวันเพียงอย่างเดียวไม่เพียงพอสำหรับการประเมินขนาด integration คลังสินค้าอาจปล่อยหมายเลขติดตามส่วนใหญ่ภายในช่วงเวลาจัดส่งสั้น ๆ ขณะที่การอัปเดตสถานะเข้ามาตลอดทั้งวัน จึงควรจำลอง workload เหล่านี้แยกจากกัน
- การเข้ามาของการลงทะเบียน: จำนวนระเบียนพัสดุใหม่ที่เข้าสู่ระบบต่อวินาทีหรือต่อนาที รวมถึงการนำเข้าและการปล่อยพัสดุเป็นชุดจากคลังสินค้า
- ทราฟฟิก API ขาออก: คำขอลงทะเบียน การค้นหา การแก้ไข การเรียกเพื่อกระทบยอด และการ retry
- ทราฟฟิกการอัปเดตขาเข้า: การส่ง webhook และการส่งซ้ำ ในกรณีที่ผู้ให้บริการรองรับ
- งาน downstream: การเขียนฐานข้อมูล การแจ้งเตือนลูกค้า เหตุการณ์ด้านการวิเคราะห์ และการเปลี่ยนแปลงสถานะคำสั่งซื้อที่ถูกเรียกใช้จากการอัปเดตแต่ละครั้ง
กำหนดเป้าหมายการลงทะเบียนภายใน เช่น ระยะเวลาสูงสุดที่ยอมรับได้ระหว่างการได้รับหมายเลขติดตามกับการยืนยันการลงทะเบียน แยกเป้าหมายนี้ออกจากความใหม่ของข้อมูลการติดตามอย่างชัดเจน เพราะการลงทะเบียนสำเร็จไม่ได้หมายความว่าข้อมูลการสแกนจากผู้ขนส่งพร้อมใช้งานแล้ว
คำนวณความสามารถในการลงทะเบียนที่แท้จริง
สำหรับ endpoint การลงทะเบียนที่จำกัดด้วยจำนวนคำขอ ความสัมพันธ์ที่มีประโยชน์สำหรับการวางแผนคือ:
ความสามารถในการลงทะเบียน = จำนวนคำขอที่อนุญาตต่อวินาที × จำนวนระเบียนเฉลี่ยต่อคำขอ × สัดส่วนระเบียนที่สำเร็จ
นี่เป็นค่าประมาณเพื่อการวางแผน ไม่ใช่การรับประกันจากผู้ให้บริการ โดยสมมติว่าข้อจำกัดจำนวนคำขอเป็นปัจจัยจำกัดหลัก โควตาที่อิงตามระเบียน ขนาด payload เวลาแฝง และข้อจำกัดร่วมของบัญชี อาจทำให้เพดานจริงต่ำลง
เพื่อประกอบการอธิบาย สมมติว่า integration หนึ่งได้รับอนุญาตให้ส่งคำขอลงทะเบียนสองครั้งต่อวินาที และส่งระเบียนเฉลี่ย 30 รายการต่อคำขอ ความสามารถตามทฤษฎีคือ 60 ระเบียนต่อวินาที ก่อนคำนึงถึงความล้มเหลวและข้อจำกัดอื่น ๆ หากการลงทะเบียนขาเข้ามีค่าเฉลี่ย 80 ระเบียนต่อวินาทีในช่วง burst ที่ต่อเนื่อง คิวจะเพิ่มขึ้นประมาณ 20 ระเบียนต่อวินาที ตัวเลขเหล่านี้เป็นเพียงสมมติฐาน ไม่ใช่ข้อจำกัดของ 17TRACK
ควรคำนวณความสามารถในการกู้คืนด้วย หากรายการใหม่เข้ามาในอัตรา λ และความสามารถในการประมวลผลที่แท้จริงคือ μ งานค้างจำนวน B ระเบียนจะใช้เวลาประมาณ B / (μ − λ) วินาทีในการระบายออก เมื่อ μ > λ หากความสามารถในการประมวลผลไม่มากกว่าอัตราการเข้ามา งานค้างจะไม่หมดลงภายใต้เงื่อนไขดังกล่าว
ยืนยันว่าผู้ให้บริการจำกัดสิ่งใดจริง
การจำกัดอัตราและโควตาการใช้งานแก้ปัญหาคนละประเภท การจำกัดอัตราควบคุมความเร็วในการส่งคำขอหรือระเบียน ส่วนโควตาการใช้งานอาจควบคุมปริมาณกิจกรรมการติดตามที่บัญชีสามารถใช้ได้ภายในช่วงเวลาการเรียกเก็บเงินหรือช่วงสิทธิ์การใช้งาน การอยู่ต่ำกว่าข้อจำกัดหนึ่งไม่ได้หมายความว่าจะปฏิบัติตามอีกข้อจำกัดหนึ่ง
ก่อนกำหนดจำนวน worker ให้ตรวจสอบสิ่งต่อไปนี้กับเอกสารของผู้ให้บริการและเงื่อนไขบัญชีของคุณ:
- ข้อจำกัดมีผลต่อบัญชี API key endpoint IP address หรือขอบเขตอื่นใด
- หน่วยที่ใช้ในการนับคือคำขอ ระเบียนการติดตาม หรือการดำเนินการประเภทอื่น
- endpoint ต่าง ๆ ใช้ข้อจำกัดร่วมกันหรือมีโควตาแยกกัน
- จำนวนระเบียนสูงสุดและขนาด payload ที่อนุญาตในหนึ่งคำขอ
- การส่งซ้ำ ระเบียนที่ไม่ถูกต้อง และการ retry ส่งผลต่อการใช้งานอย่างไร
- การตอบกลับแสดงข้อมูลการถูกจำกัดอัตราหรือคำแนะนำในการ retry หรือไม่
- โควตาหมดแตกต่างจากการถูกจำกัดอัตราชั่วคราวอย่างไร
สำหรับ integration ของ 17TRACK ให้ใช้ หน้า Tracking API อย่างเป็นทางการ และ เอกสาร API เป็นจุดเริ่มต้นในการกำหนดค่านี้ ยืนยันพฤติกรรมของ endpoint และข้อจำกัดบัญชีที่เกี่ยวข้องก่อนนำไปใช้งาน ความสามารถตัวอย่างในคู่มือนี้เป็นเพียงภาพประกอบด้านสถาปัตยกรรม ไม่ใช่คำแถลงเกี่ยวกับสิทธิ์การใช้งาน ขนาด batch หรือการรับประกันบริการของ 17TRACK
วางคิวที่มีความทนทานระหว่างการประมวลผลคำสั่งซื้อกับการลงทะเบียน
อย่าให้การชำระเงินหรือการดำเนินการของคลังสินค้าต้องรอให้ผู้ให้บริการติดตามยอมรับการลงทะเบียน ให้บันทึกพัสดุไว้ในระบบภายใน บันทึกงานลงทะเบียนอย่างถาวร และให้ worker เบื้องหลังจัดการการส่ง
ลำดับการทำงานที่ใช้งานได้จริงคือ:
- บันทึกพัสดุและเจตนาการลงทะเบียน ใช้ transactional outbox หรือการออกแบบที่เทียบเท่า เพื่อป้องกันการบันทึกคำสั่งซื้อสำเร็จแต่สูญเสียงานเบื้องหลัง
- ตรวจสอบและทำข้อมูลให้เป็นมาตรฐาน เก็บหมายเลขติดตามเป็น string รวมถึงเลขศูนย์นำหน้า ใช้การทำ normalization เฉพาะผู้ขนส่งเมื่อมีเหตุผลรองรับ
- ตรวจสอบการลงทะเบียนที่มีอยู่ ใช้ตัวระบุที่มีเสถียรภาพและเหมาะสมกับผู้ให้บริการและโมเดลข้อมูลของคุณ
- นำระเบียนที่พร้อมดำเนินการเข้าคิว เก็บจำนวนครั้งที่พยายาม เวลาที่ retry ได้ครั้งถัดไป และบริบทที่เพียงพอสำหรับการวินิจฉัย
- ส่งผ่านตัวจำกัดร่วม ขอใช้ความจุทันที ก่อนส่งคำขอขาออก
- บันทึกผลลัพธ์ระดับระเบียน แยกความสำเร็จที่ยืนยันแล้ว ความล้มเหลวที่ retry ได้ การปฏิเสธถาวร และผลลัพธ์ที่ไม่แน่ชัด
คิวช่วยดูดซับ burst แต่ไม่ได้สร้างความสามารถของผู้ให้บริการ หากระเบียนที่พร้อมดำเนินการเก่าที่สุดมีอายุมากขึ้นเรื่อย ๆ ให้ตรวจสอบช่องว่างระหว่างอัตราการเข้ามากับความสามารถในการประมวลผล แทนที่จะเพิ่มจำนวน worker เพียงอย่างเดียว
ประสานข้อจำกัดระหว่าง worker
worker ที่ทำงานแยกกันต้องไม่สมมติว่าแต่ละตัวสามารถใช้โควตาบัญชีทั้งหมดได้ ให้ใช้ตัวจำกัดอัตราที่ประสานงานกัน หรือ dispatcher ที่จัดสรรงบประมาณคำขอร่วม รวมการนำเข้าตามกำหนดเวลา สคริปต์ปฏิบัติการ และงานกระทบยอดไว้ในงบประมาณนี้ด้วย
อัตราและ concurrency เป็นตัวควบคุมคนละแบบ ตัวจำกัดอัตราควบคุมความถี่ในการเริ่มคำขอ ส่วนขีดจำกัด concurrency ควบคุมจำนวนคำขอที่ยังดำเนินการอยู่ ทั้งสองอย่างมีประโยชน์เมื่อเวลาแฝงของผู้ให้บริการสูงขึ้น การเพิ่ม concurrency อาจช่วย workload ที่ถูกจำกัดด้วยเวลาแฝง แต่ไม่สามารถฝ่าฝืนข้อจำกัดอัตราขาออกได้
ใช้การลงทะเบียนแบบ bulk โดยไม่สูญเสียการควบคุมระดับระเบียน
เมื่อ endpoint รองรับหลายระเบียนต่อคำขอ การทำ batching สามารถลด overhead ของคำขอได้ แต่ไม่ได้ลดการใช้งานที่คิดตามระเบียนเสมอไป และ batch ที่ใหญ่ที่สุดที่อนุญาตอาจไม่ใช่ตัวเลือกที่ดีที่สุดสำหรับการปฏิบัติงาน
สร้าง batch โดยใช้เงื่อนไขสองอย่าง ได้แก่ จำนวนระเบียนสูงสุดและเวลารอสูงสุด ส่งเมื่อเงื่อนไขใดเงื่อนไขหนึ่งเกิดขึ้น วิธีนี้ช่วยให้ช่วงที่มีงานมากสามารถเติม batch ได้อย่างมีประสิทธิภาพ โดยไม่บังคับให้ทราฟฟิกปริมาณน้อยต้องรอไม่มีกำหนด
- เคารพข้อจำกัด payload รวมถึงจำนวนระเบียน metadata เสริมอาจทำให้ batch ที่มีขนาดเท่ากันมีขนาดเป็นไบต์แตกต่างกันมาก
- เก็บ batch manifest ภายใน บันทึกว่าตัวตนพัสดุภายในใดถูกส่ง และเชื่อมโยงผลลัพธ์ที่ส่งกลับมาแต่ละรายการให้ถูกต้อง
- ตรวจสอบผลลัพธ์ระดับแอปพลิเคชัน การตอบกลับ HTTP สำเร็จไม่ได้พิสูจน์ด้วยตัวเองว่าทุกระเบียนได้รับการยอมรับ
- retry เฉพาะระเบียนที่ต้อง retry การส่งระเบียนที่สำเร็จแล้วซ้ำจะสร้างทราฟฟิกที่ไม่จำเป็นและอาจส่งผลต่อการใช้งาน
- ส่งความล้มเหลวจากการตรวจสอบแบบถาวรไปแก้ไข payload ที่ไม่ถูกต้องและไม่มีการเปลี่ยนแปลงไม่ควรถูกวนอยู่ในคิว retry
timeout มีความสำคัญเป็นพิเศษ ผู้ให้บริการอาจยอมรับคำขอแล้ว แม้ client ของคุณจะไม่ได้รับการตอบกลับ ให้ทำเครื่องหมายผลลัพธ์นั้นว่าไม่แน่ชัด แก้ไขผ่านกลไก idempotency ที่รองรับ กฎการลงทะเบียนซ้ำที่ระบุไว้ในเอกสาร หรือการค้นหาเพื่อกระทบยอดเมื่อมีให้ใช้งาน อย่าสมมติว่าการเขียนที่ timeout ล้มเหลว
แยกทราฟฟิกแบบ live ออกจากการนำเข้าข้อมูลย้อนหลัง
การ backfill ไม่ควรใช้ความจุทั้งหมดที่จำเป็นสำหรับพัสดุที่เพิ่งจัดส่ง ใช้คิวแยกกันพร้อมการจัดตารางแบบมีน้ำหนัก หรือสำรองความจุไว้อย่างชัดเจน อนุญาตให้การนำเข้าใช้ความจุส่วนเกิน พร้อมรักษาการจัดสรรขั้นต่ำสำหรับการลงทะเบียนแบบ live ใช้กฎด้านอายุหรือนโยบายความเป็นธรรมอื่น เพื่อให้ระเบียนที่มีลำดับความสำคัญต่ำได้รับการประมวลผลในท้ายที่สุด
ทำให้การ retry อยู่ภายใต้การควบคุม มีการหน่วงเวลา และมีขอบเขต
HTTP 429 หมายถึง “Too Many Requests” RFC 6585 ระบุว่าการตอบกลับ 429 อาจมี header Retry-After RFC 9110 กำหนดว่าค่าของ header นี้อาจเป็นวันที่ HTTP หรือจำนวนวินาทีที่ต้องหน่วง client ควรแยกวิเคราะห์ได้ทั้งสองรูปแบบ แทนที่จะสมมติว่าจะได้รับจำนวนเต็มเสมอ
เมื่อมีการระบุระยะเวลา retry ที่ถูกต้อง อย่า retry ก่อนเวลานั้นหมดลง หากไม่มีคำแนะนำในการ retry ให้ใช้ exponential backoff ที่มีเพดานร่วมกับ jitter โดยเพิ่มระยะเวลาระหว่างความพยายามทีละน้อยและเพิ่มความสุ่ม เพื่อไม่ให้ worker ทั้งหมด retry พร้อมกัน การ retry ต้องผ่านตัวจำกัดขาออกเดียวกันกับความพยายามครั้งแรก
จัดประเภทความล้มเหลวก่อน retry:
- การถูกจำกัดอัตรา: หน่วงงานที่ได้รับผลกระทบและลดแรงกดดันในการ dispatch ภายในขอบเขตข้อจำกัดที่เกี่ยวข้อง
- ความล้มเหลวของเครือข่ายหรือเซิร์ฟเวอร์ชั่วคราว: retry ภายใต้นโยบายที่มีขอบเขต โดยคำนึงถึงผลลัพธ์การเขียนที่ไม่แน่ชัด
- ความล้มเหลวด้านการยืนยันตัวตนหรือสิทธิ์: แจ้งเตือนและหยุดงานที่ได้รับผลกระทบจนกว่าจะมีการแก้ไขข้อมูลรับรองหรือสิทธิ์
- ความล้มเหลวจากการตรวจสอบ: แก้ไขหรือแยกระเบียน แทนการส่งข้อมูลเดิมซ้ำโดยไม่เปลี่ยนแปลง
- โควตาที่ใช้หมด: ปฏิบัติตามวิธีแก้ไขบัญชีที่ระบุไว้ในเอกสาร แทนการถือว่าเป็นเพียง traffic spike ระยะสั้น
กำหนดทั้งจำนวนครั้งที่พยายามและอายุสูงสุดของการ retry ย้ายรายการที่พยายามครบแล้วไปยัง dead-letter queue พร้อมเหตุผล ผู้รับผิดชอบ และขั้นตอนการ replay มิฉะนั้นความล้มเหลวเก่าอาจใช้ความจุที่ตั้งใจไว้สำหรับพัสดุใหม่อย่างเงียบ ๆ
ปรับขนาดการรับ webhook อย่างอิสระ
เมื่อผู้ให้บริการมี webhook ที่เหมาะสม webhook สามารถลดการ polling สถานะซ้ำ ๆ ได้ แต่ก็สร้าง workload ขาเข้าอีกประเภทหนึ่งที่ต้องพร้อมใช้งานในช่วงที่การอัปเดตพุ่งสูง
ทำให้ endpoint รับข้อมูลมีหน้าที่กระชับ: ตรวจสอบคำขอโดยใช้กลไกที่ระบุไว้ในเอกสารของผู้ให้บริการ จัดเก็บเหตุการณ์อย่างถาวร และส่งการรับทราบที่จำเป็นกลับไป ประมวลผลการเปลี่ยนแปลงคำสั่งซื้อ การวิเคราะห์ และข้อความถึงลูกค้าแบบอะซิงโครนัส อย่าส่งการรับทราบก่อนการยอมรับอย่างถาวร หากการทำเช่นนั้นอาจเสี่ยงต่อการสูญเสียเหตุการณ์
ออกแบบ consumer ให้รองรับการส่งซ้ำ เว้นแต่สัญญาของผู้ให้บริการจะระบุไว้อย่างชัดเจนเป็นอย่างอื่น ควรใช้ตัวระบุเหตุการณ์ที่มีเสถียรภาพและระบุไว้ในเอกสารเพื่อทำ deduplication หากไม่มี ให้สร้างและทดสอบตัวตนแบบ composite อย่างรอบคอบ การใช้เพียงป้ายสถานะอาจทำให้เหตุการณ์ที่แตกต่างกันถูกรวมเป็นเหตุการณ์เดียว
ควรป้องกันการอัปเดตที่มาถึงไม่เรียงลำดับด้วย จัดเก็บประวัติเหตุการณ์แยกจากสถานะพัสดุปัจจุบันที่คำนวณขึ้น ใช้ timestamp ของเหตุการณ์และกฎการเปลี่ยนสถานะตามที่ระบุไว้ในเอกสารเมื่อมี อย่าสมมติว่าลำดับการมาถึงคือลำดับเหตุการณ์ หรือสถานะพัสดุจะเพิ่มขึ้นตามลำดับเดียวกันในทุกกรณี
ทำให้การกระทบยอดมุ่งเป้าและมีการจำกัดอัตรา การกระทบยอดสามารถตรวจสอบช่องว่างการส่งที่สงสัยหรือการลงทะเบียนที่ไม่แน่ชัดได้ แต่การ polling พัสดุทุกชิ้นอย่างหนักอาจสร้างภาระขาออกแบบเดียวกับที่ webhook มีไว้เพื่อหลีกเลี่ยง
ทดสอบการกู้คืน ไม่ใช่แค่ throughput สูงสุด
ทำ load test กับส่วนประกอบของคุณเองโดยใช้ตัวจำลองผู้ให้บริการ ประสานงานการทดสอบที่ส่งทราฟฟิกจำนวนมากไปยังผู้ให้บริการจริง และอยู่ภายในขีดจำกัดที่ได้รับอนุญาต การทดสอบที่ประสบความสำเร็จควรแสดงให้เห็นว่าระบบกลับสู่ภาวะปกติหลังเกิดการหยุดชะงัก ไม่ใช่เพียงแสดงว่าระบบรับ burst ขนาดใหญ่ได้
- จำลอง burst รูปแบบคลังสินค้า ตามด้วยทราฟฟิกปกติที่ดำเนินต่อเนื่อง
- แทรกการตอบกลับแบบถูกจำกัดอัตรา เวลาแฝงที่สูงขึ้น และความล้มเหลวของเซิร์ฟเวอร์ชั่วคราว
- จำลองการปฏิเสธ batch บางส่วนและ timeout หลังจากเซิร์ฟเวอร์ยอมรับแล้ว
- ส่งเหตุการณ์ webhook ซ้ำและไม่เรียงลำดับ
- ตัดการเข้าถึงฐานข้อมูลและตรวจสอบว่าเหตุการณ์ที่ยังไม่ได้รับการยอมรับไม่ถูกตอบรับอย่างผิดพลาด
- รัน backfill ควบคู่กับการลงทะเบียนแบบ live และตรวจสอบความเป็นธรรม
- replay รายการใน dead-letter โดยไม่ข้ามการควบคุมอัตรา
ติดตามอายุของการลงทะเบียนที่พร้อมดำเนินการซึ่งเก่าที่สุด เวลาแฝงในการยอมรับ อัตราความสำเร็จระดับระเบียน ความถี่ในการถูกจำกัดอัตรา ปริมาณการ retry ความล่าช้าในการประมวลผล webhook และการเพิ่มขึ้นของ dead-letter เพียงความลึกของคิวไม่เพียงพอ: คิวขนาดใหญ่อาจระบายได้รวดเร็ว ขณะที่คิวขนาดเล็กอาจมีพัสดุสำคัญทางธุรกิจเพียงไม่กี่รายการที่ล้มเหลวซ้ำ ๆ
ก่อนเข้าสู่พีคซีซัน ให้กำหนดผู้รับผิดชอบด้านปฏิบัติการ ฝ่ายวิศวกรรมควรรับผิดชอบการควบคุม dispatch และเครื่องมือกู้คืน เจ้าของ integration ควรยืนยันสิทธิ์การใช้งานของผู้ให้บริการ ฝ่ายปฏิบัติการควรกำหนดว่าพัสดุใดได้รับลำดับความสำคัญ จัดทำเอกสารว่าควรหยุดการนำเข้าเมื่อใด ขอความจุเพิ่มเติมเมื่อใด หรือสืบสวนการอัปเดตที่หายไปเมื่อใด การออกแบบที่แข็งแกร่งที่สุดคือการออกแบบที่ยังคงคาดการณ์ได้เมื่อทราฟฟิกเกินความสามารถในการประมวลผลทันที
คำถามที่พบบ่อย
การเพิ่ม API key จะเพิ่ม throughput หรือไม่
ไม่เสมอไป หลาย key อาจใช้โควตาระดับบัญชีร่วมกัน ยืนยันขอบเขตข้อจำกัดและแนวทางการปรับขนาดที่อนุญาตกับผู้ให้บริการ อย่าใช้การหมุนเวียน key เพื่อหลีกเลี่ยงข้อจำกัด
การลงทะเบียนทุกครั้งควรใช้ batch ที่ใหญ่ที่สุดเท่าที่เป็นไปได้หรือไม่
ไม่ใช่ batch ที่ใหญ่ขึ้นอาจเพิ่มประสิทธิภาพของคำขอ แต่การรอให้ batch เต็มจะเพิ่มเวลาแฝงเมื่อมีปริมาณงานต่ำ ใช้เพดานขนาดที่ระบุไว้ในเอกสารร่วมกับตัวจับเวลา flush จากนั้นปรับโดยอิงจากเวลาแฝงในการยอมรับและพฤติกรรมความล้มเหลวที่วัดได้
จะป้องกันการลงทะเบียนซ้ำหลัง timeout ได้อย่างไร
ใช้ตัวตนพัสดุภายในที่จัดเก็บอย่างถาวร และพฤติกรรมด้าน idempotency หรือการจัดการรายการซ้ำของผู้ให้บริการตามที่ระบุไว้ในเอกสาร หากผลลัพธ์ยังไม่แน่ชัด ให้กระทบยอดเมื่อระบบรองรับก่อน replay การทำ deduplication ภายในระบบเพียงอย่างเดียวไม่สามารถพิสูจน์ได้ว่าคำขอระยะไกลสำเร็จหรือไม่
การลงทะเบียนสำเร็จหมายความว่าข้อมูลการติดตามเป็นปัจจุบันหรือไม่
ไม่ใช่ การยอมรับการลงทะเบียน ความพร้อมใช้งานของเหตุการณ์จากผู้ขนส่ง การประมวลผลของผู้ให้บริการ และการประมวลผลการอัปเดตของคุณเองเป็นขั้นตอนที่แยกจากกัน ควรวัดแต่ละขั้นตอนแยกกัน เพื่อไม่ให้การสแกนจากผู้ขนส่งที่ล่าช้าถูกเข้าใจผิดว่าเป็นงานลงทะเบียนค้าง
ทีมควรขอความจุจากผู้ให้บริการเพิ่มเมื่อใด
ให้ขอเมื่ออัตราการเข้ามาที่คาดการณ์ไว้และเวลาการกู้คืนที่จำเป็นเกินความสามารถที่ตรวจสอบแล้วและใช้งานได้ หลังจากตัดการ retry ที่หลีกเลี่ยงได้ การส่งซ้ำ และ batching ที่ไม่มีประสิทธิภาพออกแล้ว โควตาที่ใหญ่ขึ้นไม่สามารถแก้ consumer ที่ติดขัดหรือคอขวดฐานข้อมูลได้ ดังนั้นควรระบุปัจจัยจำกัดหลักก่อน
แหล่งข้อมูล
- 17TRACK Tracking API — จุดเริ่มต้นอย่างเป็นทางการสำหรับบริการ API
- เอกสาร 17TRACK API — แหล่งอ้างอิงสำหรับตรวจสอบข้อกำหนด integration พฤติกรรมของ endpoint และข้อจำกัดคำขอที่เกี่ยวข้อง
- RFC 6585, Section 4: 429 Too Many Requests — ความหมายของการจำกัดอัตรา HTTP และคำแนะนำ Retry-After ที่อาจมี
- RFC 9110, Section 10.2.3: Retry-After — รูปแบบ HTTP-date และ delay-seconds
- RFC 9110, Section 9.2.2: Idempotent Methods — ข้อควรพิจารณาในการ retry เมื่อผลลัพธ์ของคำขอไม่แน่ชัด