Guida all'affidabilità delle API di tracking: come monitorare l'uptime, la freschezza dei dati e gli aggiornamenti mancati dopo il go-live
Dopo il go-live, monitora l'affidabilità dell'API di tracking su tre livelli distinti: se le richieste vanno a buon fine, se le informazioni sulla spedizione arrivano entro un ritardo accettabile e se gli aggiornamenti raggiungono i tuoi sistemi senza lacune. Una risposta API corretta non dimostra che i dati di tracking siano aggiornati o che una notifica al cliente sia stata recapitata. Assegna a ogni livello metriche, avvisi e procedure di ripristino specifici.
Questa guida è destinata agli ingegneri e ai team operativi responsabili di un'integrazione attiva per il tracking delle spedizioni. L'obiettivo è rilevare i problemi di visibilità prima che diventino un problema per l'assistenza, quindi identificare se il guasto riguarda il feed del corriere, il provider di tracking, il ricevitore dei webhook o l'elaborazione a valle.
Definisci cosa significa un aggiornamento di tracking affidabile
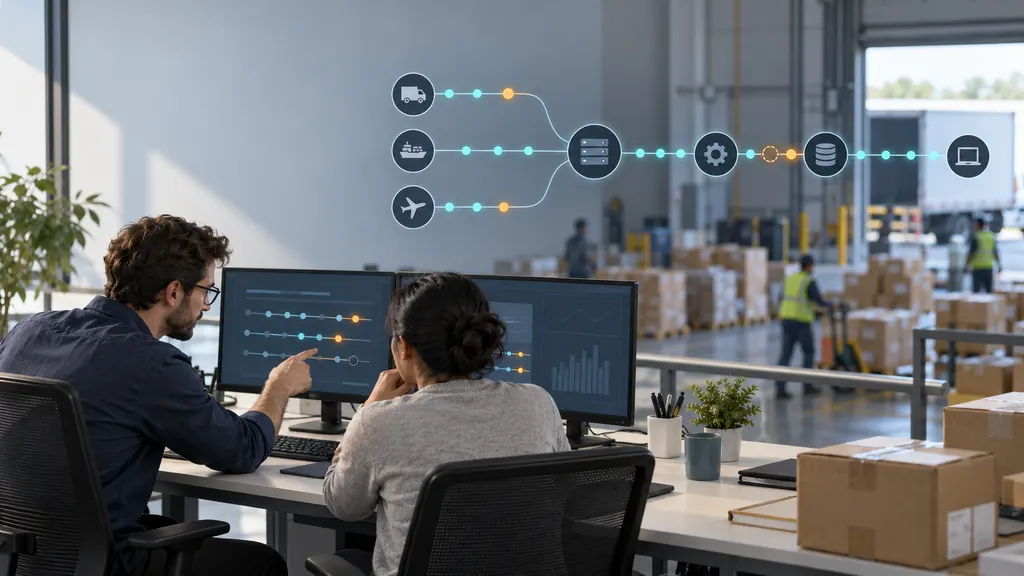
Inizia dal percorso completo della consegna: registrazione della spedizione, recupero da parte del provider, risposta API o consegna del webhook, elaborazione interna, persistenza nel database e visualizzazione rivolta al cliente. Se invii notifiche, trattale come una fase aggiuntiva invece di presumere che un aggiornamento salvato abbia raggiunto l'acquirente.
Per ogni fase, registra il responsabile e le prove che ne dimostrano il completamento. L'accettazione di un numero di tracking da parte del provider dimostra che la registrazione è stata accettata, non che il corriere abbia pubblicato un evento. La ricezione di una risposta HTTP corretta da parte di un webhook dimostra che il tuo endpoint l'ha riconosciuta, ma non necessariamente che il worker abbia salvato l'aggiornamento.
Le linee guida SRE di Google descrivono latenza, traffico, errori e saturazione come i quattro segnali d'oro del monitoraggio. Questi segnali sono utili per l'infrastruttura della tua integrazione, ma il tracking delle spedizioni richiede anche controlli di aggiornamento e completezza, perché un endpoint apparentemente sano può fornire informazioni invariate o incomplete.
| Livello | Domanda a cui rispondere | Prove da raccogliere |
|---|---|---|
| Disponibilità API | L'integrazione può completare un'operazione valida? | Risultato del trasporto, risultato dell'applicazione, latenza, percentuale di timeout |
| Aggiornamento dei dati | Quanto sono in ritardo le informazioni? | Ora dell'evento, ora dell'osservazione, ora della ricezione, ora della persistenza |
| Completezza degli aggiornamenti | Ogni aggiornamento previsto e recuperabile ha raggiunto la destinazione? | Differenze di riconciliazione, record di elaborazione, lacune irrisolte |
| Visibilità per il cliente | Lo stato visualizzato corrisponde allo stato della spedizione memorizzato? | Controlli del percorso di lettura, età della cache, risultati dell'elaborazione delle notifiche |
Strumenta l'integrazione prima di impostare gli avvisi
Conserva un record operativo che colleghi una spedizione al tentativo di registrazione, agli aggiornamenti in arrivo, ai tentativi di elaborazione e allo stato risultante. Usa un identificativo interno della spedizione per la correlazione; ove possibile, evita di inserire numeri di tracking e dati dei clienti nei log ampiamente accessibili.
Il record minimo utile include:
- ID interno della spedizione, identificativo del corriere quando noto, account dell'integrazione e ambiente.
- ID della richiesta o di correlazione, tipo di operazione, ora del tentativo, categoria del risultato e durata.
- ID dell'evento del provider quando fornito, oltre al timestamp originale dell'evento e alle informazioni sul fuso orario.
- Ora di ricezione del webhook, ora dell'archiviazione durevole, ora di completamento dell'elaborazione e ora di disponibilità per la visualizzazione, quando misurabile.
- Versione dello schema del payload quando disponibile, risultato dell'analisi, risultato della deduplicazione e motivo del fallimento.
Conserva il payload originale con controlli appropriati di accesso e conservazione quando è necessario per un'indagine o un replay. Non registrare gli header di autorizzazione o i segreti. Usa dimensioni limitate, come corriere e categoria del risultato, per le metriche; i singoli numeri di tracking devono appartenere ai record ricercabili, non alle etichette delle metriche ad alta cardinalità.
Mantieni separata l'ora dell'evento dall'ora dell'osservazione. Il modello di dati dei log di OpenTelemetry distingue esplicitamente questi elementi tramite Timestamp e ObservedTimestamp. Applicare la stessa distinzione ai record di tracking aiuta a evitare che un evento del corriere segnalato in ritardo venga scambiato per una scrittura lenta nel database.
Monitora l'uptime dal punto di vista della tua applicazione
Usa sia il traffico reale di produzione sia un controllo sintetico a basso volume. Il traffico di produzione rivela l'impatto effettivo sui clienti. Un controllo sintetico può rilevare i guasti quando il traffico di produzione è ridotto, a condizione che utilizzi un'operazione documentata e non distruttiva e rispetti i limiti di utilizzo del provider.
Un indicatore utile del successo delle richieste è:
Operazioni idonee riuscite / Tutte le operazioni idonee tentate
Definisci il termine “riuscita” utilizzando sia lo stato HTTP sia il risultato documentato a livello applicativo. Alcune interfacce possono restituire una risposta HTTP corretta mentre segnalano nel corpo una operazione non riuscita. Per le operazioni batch, misura i risultati a livello di singolo elemento oltre a quelli a livello di richiesta.
Mantieni due visualizzazioni dei guasti. La visualizzazione relativa all'impatto sul cliente include tutto ciò che impedisce alla tua applicazione di completare il proprio compito. La visualizzazione diagnostica separa gli errori del provider, i guasti di rete, i problemi di autenticazione, gli input non validi e le risposte relative a quote o limiti di frequenza. Una credenziale scaduta potrebbe non essere un'interruzione del provider, ma è comunque un'interruzione per la tua integrazione.
- Latenza: monitora p50, p95 e p99 quando il volume di traffico consente percentili significativi. Misura separatamente i timeout, così i fallimenti rapidi non fanno sembrare sana la latenza.
- Traffico: confronta il volume delle richieste e dei callback con le registrazioni delle spedizioni e la popolazione delle spedizioni attive.
- Errori: separa i guasti di trasporto, i fallimenti applicativi, gli errori di analisi e i fallimenti della persistenza a valle.
- Saturazione: monitora i pool di connessioni, la capacità dei worker, la profondità della coda, l'elemento più vecchio in coda e il budget di richieste disponibile.
Non presentare queste misurazioni come l'uptime contrattuale del provider a meno che non utilizzino le definizioni esatte del contratto. La disponibilità osservata della tua integrazione e il service-level agreement di un fornitore rispondono a domande diverse.
Misura l'aggiornamento senza confondere il silenzio con un guasto
Una spedizione che non si è spostata non è automaticamente obsoleta. Il transito internazionale, i passaggi di consegna, i fine settimana e le pratiche di scansione dei corrieri possono produrre lacune legittime. Il problema del monitoraggio consiste nel distinguere “non è successo nulla di nuovo” da “esistono nuove informazioni, ma il nostro sistema non le ha ricevute”.
Usa orologi separati per ritardi separati
- Età dell'ultimo evento: ora corrente meno l'ora dell'ultimo evento del corriere. Descrive la visibilità della spedizione, non necessariamente le prestazioni dell'integrazione.
- Ritardo di ricezione: ora della ricezione meno l'ora dell'evento. Include i ritardi di segnalazione e recupero a monte quando i timestamp intermedi non sono disponibili.
- Ritardo dell'elaborazione interna: ora del completamento dell'elaborazione durevole meno l'ora della ricezione. Isola il lavoro svolto all'interno del sistema.
- Ritardo di visualizzazione: ora della disponibilità per il cliente meno l'ora del completamento dell'elaborazione. Può rivelare problemi di cache o del modello di lettura.
- Età della verifica: ora corrente meno l'ora dell'ultimo controllo riuscito per informazioni più recenti. Misura l'attività di controllo, non dimostra che il feed del corriere sia aggiornato.
Calcola il ritardo di acquisizione specifico del provider solo se esiste il timestamp necessario del provider e il suo significato è documentato. In sua assenza, il ritardo di ricezione non può essere attribuito correttamente a una sola parte.
Normalizza i timestamp a un fuso orario coerente, preservandone la rappresentazione originale. Segnala le informazioni mancanti sul fuso orario, gli eventi con data futura e le incoerenze degli orologi. Non convertire silenziosamente un ritardo negativo in zero; esaminalo o classificalo come problema di qualità del timestamp.
Confronta spedizioni simili
Crea visualizzazioni dell'aggiornamento per corriere, servizio o rotta quando noti, stato della spedizione e tempo trascorso dalla registrazione. Separa le spedizioni appena registrate in attesa del primo evento da quelle già in transito. Escludi le spedizioni consegnate dai controlli sui movimenti attivi secondo le tue regole operative, mantenendo comunque l'eventuale monitoraggio post-consegna richiesto dal flusso di lavoro.
Imposta le soglie iniziali sulla base dei requisiti aziendali e del comportamento osservato, non di un intervallo di aggiornamento universale inventato. Una soglia adatta alla consegna locale può creare rumore per un passaggio transfrontaliero. Al contrario, una media ampia della rete può nascondere un problema che riguarda un solo corriere.
Indica la copertura in ogni pannello sull'aggiornamento. Se mancano i timestamp degli eventi per una parte della popolazione, mostra quella popolazione separatamente invece di far apparire le spedizioni restanti rappresentative di tutto il traffico.
Trova gli aggiornamenti persi tramite la riconciliazione
Il solo volume dei webhook non può stabilire la completezza. Un traffico ridotto può essere normale e una risposta webhook corretta può nascondere un errore di elaborazione a valle. La riconciliazione confronta ciò che una fonte di riferimento espone attualmente con ciò che il sistema ha effettivamente memorizzato o elaborato.
- Definisci la popolazione idonea. Includi le spedizioni registrate e monitorate attivamente. Traccia separatamente le registrazioni rifiutate e il monitoraggio sospeso, in modo che non scompaiano dai report operativi.
- Seleziona un riferimento. Quando l'API documentata lo consente, recupera i dettagli di tracking correnti indipendentemente dall'acquisizione tramite webhook. Le pagine di tracking dei corrieri possono aiutare a esaminare i singoli casi, ma non devono diventare una dipendenza automatizzata dallo scraping senza autorizzazione.
- Applica un periodo di tolleranza. Considera i normali ritardi di consegna ed elaborazione prima di classificare una differenza come possibile lacuna.
- Confronta elementi omogenei. Abbina gli identificativi degli eventi supportati oppure usa una regola di normalizzazione documentata per timestamp, stati, località e descrizioni.
- Ripristina in sicurezza. Riproduci i messaggi conservati o recupera gli aggiornamenti consentiti tramite il normale percorso di elaborazione idempotente.
- Conferma la destinazione. Verifica che il database e la visualizzazione rivolta al cliente siano stati corretti, non solo che sia stato eseguito un job di ripristino.
Un indicatore interno può essere espresso come:
Spedizioni riconciliate idonee con differenze irrisolte / Tutte le spedizioni riconciliate idonee
Definiscilo come tasso di lacune di riconciliazione irrisolte, non come tasso universale di eventi persi. Se il riferimento espone solo lo stato più recente, non può dimostrare che ogni evento storico sia arrivato. Anche uno stato finale coincidente può nascondere la perdita di una tappa intermedia.
Inizia con un campione stratificato per corrieri, età delle spedizioni e stati. Durante un incidente, amplia la copertura per i segmenti interessati, nel rispetto dei limiti documentati. Riporta sia il numero di elementi controllati sia il numero di quelli con differenze, così un campione ridotto non viene scambiato per una copertura completa.
Rendi recuperabile l'acquisizione dei webhook
Progetta il ricevitore in modo che convalidi le richieste in arrivo e acquisisca in modo durevole i messaggi accettati prima di riconoscerli, in conformità con il contratto di consegna documentato dal provider. Quando possibile, mantieni la logica aziendale più lenta in un worker separato.
Verifica le regole effettive dell'integrazione invece di darne per scontate: autenticazione o convalida della firma, requisiti di riconoscimento, timeout della richiesta, condizioni di retry, durata dei retry, ordinamento e disponibilità del replay. Questi dettagli determinano il ripristino che l'applicazione deve fornire.
- Prevedi i duplicati nella progettazione: usa un ID evento documentato quando disponibile. In caso contrario, crea una chiave di deduplicazione attentamente circoscritta e testala rispetto a eventi simili legittimi.
- Gestisci la consegna fuori ordine: conserva la cronologia degli eventi e usa regole di transizione esplicite invece di sostituire ciecamente lo stato della spedizione con quello dell'ultimo messaggio ricevuto.
- Metti in quarantena i fallimenti: conserva i messaggi non elaborabili con i relativi dettagli di errore e fornisci un processo controllato di reinoltro.
- Separa il ripristino dello stato dagli effetti collaterali: la riproduzione di un evento non deve inviare automaticamente una vecchia email di consegna né ripetere un'altra azione rivolta al cliente.
Se la tua integrazione utilizza 17TRACK, usa la documentazione ufficiale dell'API di Tracking come riferimento per l'implementazione e verifica i requisiti applicabili alla tua integrazione. La pagina del prodotto Tracking API fornisce il contesto del prodotto, ma le soglie di monitoraggio e le ipotesi di ripristino devono derivare dal comportamento documentato, dal tuo contratto di servizio e dalle misurazioni di produzione, non dalle descrizioni del prodotto.
Trasforma i dashboard in avvisi attuabili
Ogni avviso dovrebbe identificare la popolazione interessata, la probabile fase del guasto, l'impatto aziendale e il primo passaggio dell'indagine. Un avviso globale “il tracking è obsoleto” raramente fornisce informazioni sufficienti per agire.
| Schema del segnale | Prima indagine | Responsabile principale |
|---|---|---|
| Le richieste falliscono su diversi corrieri | Controlla credenziali, rete, limiti e risposte del provider | Reperibilità dell'integrazione o della piattaforma |
| I callback arrivano, ma l'età dell'elaborazione aumenta | Esamina i worker, lo stato del database e i messaggi in quarantena | Ingegneria applicativa |
| Un corriere mostra lacune insolite nell'aggiornamento | Confronta le coorti e campiona i record di tracking di riferimento | Operations del tracking con l'ingegneria |
| Lo stato memorizzato è aggiornato, ma la visualizzazione è vecchia | Esamina cache, modelli di lettura e recupero dal frontend | Team dell'applicazione rivolta al cliente |
Usa violazioni persistenti e dimensioni minime del campione per ridurre il rumore. Per gli obiettivi di disponibilità ed elaborazione, un budget degli errori può aiutare a distinguere una breve anomalia da un guasto che consuma una quota inaccettabile degli errori consentiti. Mantieni separati gli obiettivi di aggiornamento dei dati del corriere dagli obiettivi direttamente controllati dal team di ingegneria.
Usa un runbook di ripristino che dimostri il completamento
Quando inizia un incidente, stabilisci l'ultimo punto noto come sano e conserva i record pertinenti. Determina se sono interessate le nuove registrazioni, i messaggi in arrivo, l'elaborazione o gli aggiornamenti della visualizzazione. Quindi stima la popolazione di spedizioni a rischio invece di riportare solo il numero di richieste.
Ripristina la fase guasta, riproduci o recupera nuovamente i dati entro i limiti documentati ed esegui la riconciliazione sulla popolazione interessata. Chiudi l'incidente solo dopo che l'età dell'arretrato è tornata alla normalità, le lacune irrisolte sono state contabilizzate e lo stato rivolto al cliente è stato controllato. Registra separatamente gli eventuali aggiornamenti storici che non possono essere recuperati.
Testa questo processo con guasti controllati: ricevitore non disponibile, payload malformato, interruzione del worker, evento duplicato, evento fuori ordine e credenziale scaduta. Un test ha esito positivo quando il team rileva il problema, identifica il responsabile, recupera i dati ed evita effetti collaterali duplicati, non semplicemente quando l'endpoint torna raggiungibile.
FAQ
Un'API può restituire risposte corrette mentre le informazioni di tracking sono obsolete?
Sì. Il successo della richiesta stabilisce che un'operazione è stata completata secondo le regole dell'interfaccia. Non stabilisce che un corriere abbia pubblicato una nuova scansione o che ogni sistema a valle abbia elaborato il risultato. Monitora separatamente l'aggiornamento e l'elaborazione end-to-end.
Con quale frequenza dovremmo riconciliare le spedizioni?
Scegli una frequenza in base al ritardo di rilevamento accettabile, al volume delle spedizioni attive, al budget di richieste e ai limiti documentati. Usa controlli più frequenti per i segmenti operativamente sensibili e un'analisi programmata più ampia per la copertura. Non esiste un unico intervallo adatto a ogni corriere e flusso di lavoro.
L'assenza di attività dei webhook significa che l'integrazione è guasta?
No. Potrebbero non esserci nuovi eventi. Confronta l'attività dei callback con la popolazione delle spedizioni attive, i modelli recenti, lo stato del ricevitore e un controllo di recupero indipendente quando supportato. Invia avvisi sulla base di prove corroboranti, non del solo silenzio.
Dovremmo eseguire il polling continuamente come backup?
Non per impostazione predefinita. Un polling incontrollato può consumare la capacità di richieste senza migliorare la visibilità. Usa una riconciliazione limitata e un recupero specifico per gli incidenti entro i limiti documentati. Verifica come interagiscono polling e consegna dei webhook per il tuo provider.
Cosa dovremmo inviare quando segnaliamo un sospetto problema del provider?
Includi i tipi di operazione interessati, gli intervalli temporali in UTC, gli ID delle richieste anonimizzati, i codici di risposta, riferimenti rappresentativi alle spedizioni tramite un canale sicuro approvato e il comportamento atteso rispetto a quello osservato. Spiega quali fasi interne hai verificato. Non includere credenziali o dati dei clienti non necessari.
Fonti
- Google SRE: Monitoring Distributed Systems — i quattro segnali d'oro e i principi di monitoraggio.
- OpenTelemetry: Logs Data Model — la distinzione tra timestamp degli eventi e timestamp osservati.
- Documentazione dell'API di Tracking di 17TRACK — il riferimento per l'implementazione di un'integrazione 17TRACK.
- 17TRACK Tracking API — contesto ufficiale del prodotto.