Guide de fiabilité de l’API de suivi : comment surveiller la disponibilité, l’actualisation des données et les mises à jour manquées après la mise en production
Après la mise en production, surveillez la fiabilité de l’API de suivi à trois niveaux distincts : la réussite des requêtes, l’arrivée des informations d’expédition dans un délai acceptable et la transmission sans interruption des mises à jour à vos propres systèmes. Une réponse API réussie ne prouve ni que les données de suivi sont à jour ni qu’une notification client a été envoyée. Attribuez à chaque niveau ses propres métriques, alertes et procédures de récupération.
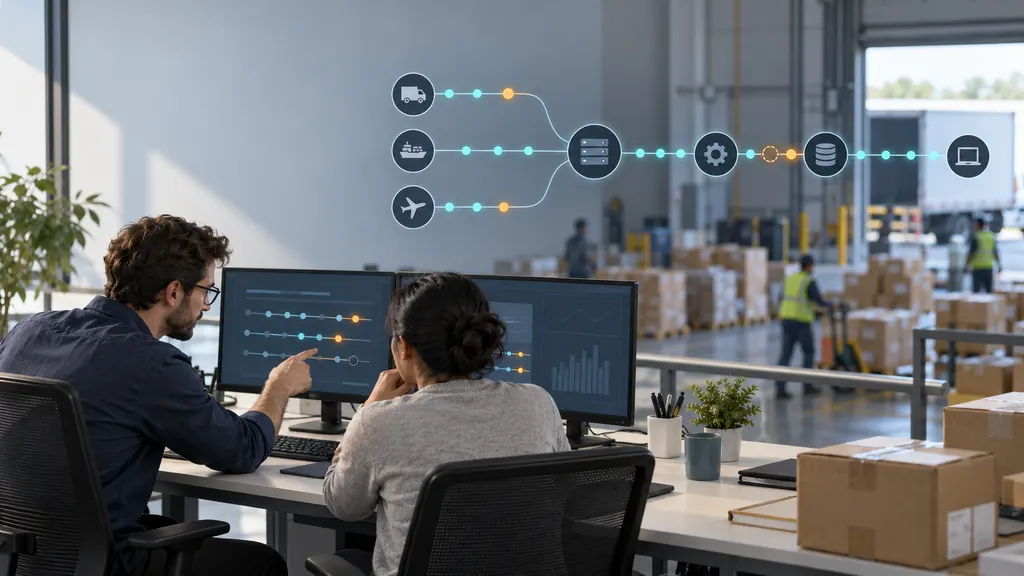
Ce guide s’adresse aux ingénieurs et aux équipes opérationnelles responsables d’une intégration de suivi des expéditions en production. L’objectif est de détecter une visibilité défaillante avant qu’elle ne devienne un problème pour le support, puis de déterminer si la défaillance provient du flux d’un transporteur, du fournisseur de suivi, de votre récepteur de webhooks ou du traitement en aval.
Définir ce que signifie une mise à jour de suivi fiable
Commencez par examiner l’ensemble du parcours de livraison : enregistrement de l’expédition, récupération par le fournisseur, réponse API ou livraison du webhook, traitement interne, persistance en base de données et affichage destiné au client. Si vous envoyez des notifications, considérez-les comme une étape supplémentaire au lieu de supposer qu’une mise à jour enregistrée est parvenue à l’acheteur.
Pour chaque étape, enregistrez son responsable et les éléments qui prouvent sa réussite. L’acceptation d’un numéro de suivi par un fournisseur prouve que l’enregistrement a été accepté, et non qu’un transporteur a publié un événement. La réception par un webhook d’une réponse HTTP réussie prouve que votre point de terminaison l’a reconnu, mais pas nécessairement que votre worker a validé la mise à jour.
Les recommandations SRE de Google décrivent la latence, le trafic, les erreurs et la saturation comme les quatre signaux clés de la surveillance. Ces signaux sont utiles pour votre infrastructure d’intégration, mais le suivi des expéditions exige également des contrôles de fraîcheur et d’exhaustivité, car un point de terminaison apparemment sain peut fournir des informations inchangées ou incomplètes.
| Niveau | Question à résoudre | Éléments à recueillir |
|---|---|---|
| Disponibilité de l’API | L’intégration peut-elle terminer une opération valide ? | Résultat du transport, résultat applicatif, latence, taux d’expiration |
| Fraîcheur des données | Quel est le retard des informations ? | Heure de l’événement, heure d’observation, heure de réception, heure de persistance |
| Exhaustivité des mises à jour | Chaque mise à jour attendue et récupérable est-elle parvenue à destination ? | Écarts de rapprochement, enregistrements de traitement, lacunes non résolues |
| Visibilité client | Le statut affiché correspond-il à l’état enregistré de l’expédition ? | Contrôles du chemin de lecture, ancienneté du cache, résultats du traitement des notifications |
Instrumenter l’intégration avant de définir les alertes
Conservez un enregistrement opérationnel reliant une expédition à sa tentative d’enregistrement, aux mises à jour entrantes, aux tentatives de traitement et à l’état résultant. Utilisez un identifiant interne d’expédition pour la corrélation ; dans la mesure du possible, ne faites pas figurer les numéros de suivi ni les informations client dans des journaux largement accessibles.
L’enregistrement minimal utile comprend :
- Identifiant interne de l’expédition, identifiant du transporteur lorsqu’il est connu, compte d’intégration et environnement.
- ID de requête ou de corrélation, type d’opération, heure de la tentative, catégorie du résultat et durée.
- ID d’événement du fournisseur lorsqu’il est fourni, ainsi que l’horodatage d’origine de l’événement et les informations de fuseau horaire.
- Heure de réception du webhook, heure du stockage durable, heure de fin du traitement et heure de disponibilité à l’affichage lorsqu’elles sont mesurables.
- Version du schéma de la charge utile lorsqu’elle est disponible, résultat de l’analyse, résultat de la déduplication et motif de l’échec.
Conservez la charge utile d’origine avec des contrôles d’accès et de conservation appropriés lorsqu’elle est nécessaire à une investigation ou à une relecture. N’enregistrez pas les en-têtes d’autorisation ni les secrets. Utilisez des dimensions limitées, telles que le transporteur et la catégorie de résultat, pour les métriques ; les numéros de suivi individuels doivent figurer dans des enregistrements consultables, et non dans des libellés de métriques à forte cardinalité.
Gardez l’heure de l’événement distincte de l’heure d’observation. Le modèle de données des journaux OpenTelemetry établit explicitement cette distinction au moyen de Timestamp et ObservedTimestamp. Appliquer cette même distinction aux enregistrements de suivi aide à éviter de confondre un événement de transporteur signalé tardivement avec une écriture lente dans la base de données.
Surveiller la disponibilité du point de vue de votre application
Utilisez à la fois le trafic réel de production et un contrôle synthétique à faible volume. Le trafic de production révèle l’impact réel sur les clients. Un contrôle synthétique peut détecter les défaillances lorsque le trafic de production est faible, à condition d’utiliser une opération documentée et non destructive et de respecter les limites d’utilisation du fournisseur.
Un indicateur utile de réussite des requêtes est :
Opérations éligibles réussies / Toutes les opérations éligibles tentées
Définissez la notion de « réussite » à partir du statut HTTP et du résultat applicatif documenté. Certaines interfaces peuvent renvoyer une réponse HTTP réussie tout en signalant une opération échouée dans le corps de la réponse. Pour les opérations par lots, mesurez les résultats au niveau des éléments ainsi qu’au niveau des requêtes.
Conservez deux visions des échecs. La vision axée sur l’impact client inclut tout ce qui empêche votre application d’accomplir sa tâche. La vision diagnostique distingue les erreurs du fournisseur, les défaillances réseau, les problèmes d’authentification, les entrées invalides et les réponses liées aux quotas ou aux limites de débit. Un identifiant d’accès expiré n’est peut-être pas une panne du fournisseur, mais il constitue tout de même une panne pour votre intégration.
- Latence : Suivez les valeurs p50, p95 et p99 lorsque le volume de trafic permet d’obtenir des percentiles significatifs. Mesurez séparément les expirations afin que les échecs rapides ne donnent pas l’impression que la latence est saine.
- Trafic : Comparez le volume des requêtes et des callbacks avec les enregistrements d’expéditions et la population d’expéditions actives.
- Erreurs : Distinguez les défaillances de transport, les échecs applicatifs, les erreurs d’analyse et les échecs de persistance en aval.
- Saturation : Surveillez les pools de connexions, la capacité des workers, la profondeur de la file d’attente, l’élément le plus ancien en attente et le budget de requêtes disponible.
Ne présentez pas ces mesures comme la disponibilité contractuelle du fournisseur, sauf si elles utilisent exactement les définitions du contrat. La disponibilité observée de votre intégration et l’accord de niveau de service d’un fournisseur répondent à des questions différentes.
Mesurer la fraîcheur sans confondre silence et défaillance
Une expédition qui n’a pas bougé n’est pas automatiquement obsolète. Le transport international, les transferts, les week-ends et les pratiques de scan des transporteurs peuvent créer des interruptions légitimes. Le problème de surveillance consiste à distinguer « rien de nouveau ne s’est produit » de « de nouvelles informations existent, mais notre système ne les a pas reçues ».
Utiliser des horloges distinctes pour des délais distincts
- Ancienneté du dernier événement : Heure actuelle moins l’heure du dernier événement du transporteur. Cela décrit la visibilité de l’expédition, et pas nécessairement les performances de l’intégration.
- Délai de réception : Votre heure de réception moins l’heure de l’événement. Il inclut les délais de signalement et de récupération en amont lorsque les horodatages intermédiaires ne sont pas disponibles.
- Délai de traitement interne : Heure de fin du traitement durable moins l’heure de réception. Cela isole le travail effectué dans votre système.
- Délai d’affichage : Heure de disponibilité côté client moins l’heure de fin du traitement. Cela peut révéler des problèmes de cache ou de modèle de lecture.
- Ancienneté de la vérification : Heure actuelle moins la dernière vérification réussie de nouvelles informations. Cela mesure l’activité de vérification, et ne prouve pas que le flux du transporteur est à jour.
Ne calculez un délai d’ingestion propre au fournisseur que si l’horodatage nécessaire est disponible et que sa signification est documentée. Sans cela, le délai de réception ne peut pas être attribué équitablement à une seule partie.
Normalisez les horodatages selon un fuseau horaire cohérent tout en conservant leur représentation d’origine. Signalez les informations de fuseau horaire manquantes, les événements datés dans le futur et les incohérences d’horloge. Ne convertissez pas silencieusement un délai négatif en zéro ; examinez-le ou classez-le comme un problème de qualité d’horodatage.
Comparer des expéditions similaires
Construisez des vues de fraîcheur par transporteur, service ou itinéraire lorsqu’il est connu, par statut de l’expédition et par durée écoulée depuis l’enregistrement. Séparez les expéditions nouvellement enregistrées qui attendent leur premier événement des expéditions déjà en transit. Excluez les expéditions livrées des contrôles de déplacement actif conformément à vos règles opérationnelles, tout en conservant toute surveillance post-livraison requise par votre workflow.
Définissez les seuils initiaux à partir des exigences métier et des comportements observés, et non à partir d’un intervalle universel de mise à jour inventé. Un seuil adapté à une livraison locale peut générer du bruit lors d’un transfert transfrontalier. À l’inverse, une moyenne réseau large peut masquer un problème touchant un seul transporteur.
Indiquez la couverture sur chaque panneau de fraîcheur. Si les horodatages d’événements manquent pour une partie de la population, affichez cette population séparément au lieu de faire paraître les expéditions restantes représentatives de l’ensemble du trafic.
Détecter les mises à jour manquées grâce au rapprochement
Le seul volume de webhooks ne permet pas d’établir l’exhaustivité. Un trafic faible peut être normal, et une réponse webhook réussie peut dissimuler un échec de traitement en aval. Le rapprochement compare ce qu’une source de référence expose actuellement avec ce que votre système a effectivement stocké ou traité.
- Définissez la population éligible. Incluez les expéditions enregistrées et activement surveillées. Suivez séparément les enregistrements rejetés et la surveillance suspendue afin qu’ils ne disparaissent pas des rapports opérationnels.
- Sélectionnez une référence. Lorsque l’API documentée le permet, récupérez les détails actuels du suivi indépendamment de l’ingestion des webhooks. Les pages de suivi des transporteurs peuvent aider à examiner des cas individuels, mais ne doivent pas devenir une dépendance automatisée au scraping sans autorisation.
- Appliquez une période de grâce. Tenez compte des délais normaux de livraison et de traitement avant de classer une différence comme une lacune présumée.
- Comparez des éléments comparables. Faites correspondre les identifiants d’événements pris en charge, ou utilisez une règle de normalisation documentée pour les horodatages, les statuts, les lieux et les descriptions.
- Récupérez de manière sûre. Relisez les messages conservés ou récupérez les mises à jour autorisées par le chemin normal de traitement idempotent.
- Confirmez la destination. Vérifiez que la base de données et la vue destinée au client sont corrigées, et pas seulement qu’une tâche de récupération a été exécutée.
Un indicateur interne peut être exprimé ainsi :
Expéditions éligibles rapprochées présentant des différences non résolues / Toutes les expéditions éligibles rapprochées
Appelez cela un taux d’écarts de rapprochement non résolus, et non un taux universel d’événements manqués. Si la référence n’expose que l’état le plus récent, elle ne peut pas prouver que chaque événement historique est arrivé. Même un statut final correspondant peut dissimuler un jalon intermédiaire manqué.
Commencez par un échantillon stratifié couvrant les transporteurs, l’ancienneté des expéditions et les statuts. Étendez la couverture aux segments touchés pendant un incident, dans les limites documentées. Indiquez à la fois le nombre d’éléments vérifiés et le nombre présentant des différences afin qu’un petit échantillon ne soit pas confondu avec une couverture complète.
Rendre l’ingestion des webhooks récupérable
Concevez le récepteur pour valider les requêtes entrantes et capturer durablement les messages acceptés avant de les reconnaître, conformément au contrat de livraison documenté du fournisseur. Lorsque cela est possible, gardez la logique métier plus lente dans un worker séparé.
Vérifiez les règles réelles de l’intégration au lieu de les supposer : authentification ou validation de signature, exigences d’accusé de réception, délai d’expiration des requêtes, conditions de nouvelle tentative, durée des nouvelles tentatives, ordre de livraison et disponibilité de la relecture. Ces détails déterminent les mécanismes de récupération que votre application doit fournir.
- Prévoyez les doublons dans votre conception : Utilisez un ID d’événement documenté lorsqu’il est disponible. Sinon, créez une clé de déduplication soigneusement délimitée et testez-la avec des événements légitimement similaires.
- Gérez les livraisons dans le désordre : Conservez l’historique des événements et utilisez des règles de transition explicites au lieu de remplacer aveuglément l’état de l’expédition par celui du dernier message reçu.
- Mettez les échecs en quarantaine : Conservez les messages impossibles à traiter avec leurs détails d’erreur et fournissez un processus contrôlé de rediffusion.
- Séparez la récupération de l’état des effets secondaires : La relecture d’un événement ne doit pas automatiquement renvoyer un ancien e-mail de livraison ni répéter une autre action destinée au client.
Si votre intégration utilise 17TRACK, utilisez la documentation officielle de l’API Tracking comme référence d’implémentation et vérifiez les exigences applicables à votre intégration. La page produit de l’API Tracking fournit le contexte produit, mais les seuils de surveillance et les hypothèses de récupération doivent provenir du comportement documenté, de votre accord de service et des mesures de production, et non des descriptions du produit.
Transformer les tableaux de bord en alertes exploitables
Chaque alerte doit identifier la population touchée, l’étape probablement défaillante, l’impact métier et la première étape d’investigation. Une alerte globale indiquant que « le suivi est obsolète » fournit rarement suffisamment d’informations pour agir.
| Type de signal | Première investigation | Responsable principal |
|---|---|---|
| Les requêtes échouent auprès de plusieurs transporteurs | Vérifier les identifiants, le réseau, les limites et les réponses du fournisseur | Équipe d’intégration ou de plateforme d’astreinte |
| Les callbacks arrivent, mais l’ancienneté du traitement augmente | Examiner les workers, l’état de la base de données et les messages en quarantaine | Ingénierie applicative |
| Un transporteur présente des lacunes de fraîcheur inhabituelles | Comparer les cohortes et échantillonner les enregistrements de suivi de référence | Opérations de suivi avec l’ingénierie |
| L’état stocké est à jour, mais l’affichage est ancien | Examiner les caches, les modèles de lecture et la récupération côté frontend | Équipe de l’application destinée aux clients |
Utilisez des dépassements persistants et des tailles minimales d’échantillon afin de réduire le bruit. Pour les objectifs de disponibilité et de traitement, un budget d’erreur peut aider à distinguer une brève anomalie d’une défaillance consommant une part inacceptable des erreurs autorisées. Gardez les objectifs de fraîcheur des données des transporteurs séparés des objectifs directement contrôlés par votre équipe d’ingénierie.
Utiliser un runbook de récupération qui prouve la fin du processus
Lorsqu’un incident commence, établissez le dernier point connu comme sain et conservez les enregistrements pertinents. Déterminez si les nouveaux enregistrements, les messages entrants, le traitement ou les mises à jour de l’affichage sont affectés. Estimez ensuite la population d’expéditions à risque au lieu de ne communiquer que le nombre de requêtes.
Restaurez l’étape défaillante, relisez ou récupérez de nouveau les données dans les limites documentées, puis effectuez un rapprochement sur la population touchée. Ne clôturez l’incident qu’après le retour à la normale de l’ancienneté de la file d’attente, la prise en compte des lacunes non résolues et la vérification de l’état destiné aux clients. Enregistrez séparément les mises à jour historiques qui ne peuvent pas être récupérées.
Testez ce processus avec des défaillances contrôlées : récepteur indisponible, charge utile malformée, panne d’un worker, événement en double, événement reçu dans le désordre et identifiant expiré. Un test est réussi lorsque l’équipe détecte le problème, identifie son responsable, récupère les données et évite les effets secondaires en double, et pas simplement lorsque le point de terminaison redevient accessible.
FAQ
Une API peut-elle renvoyer des réponses réussies alors que les informations de suivi sont obsolètes ?
Oui. La réussite de la requête établit qu’une opération s’est terminée conformément aux règles de l’interface. Elle n’établit pas qu’un transporteur a publié un nouveau scan ni que chaque système en aval a traité le résultat. Surveillez séparément la fraîcheur et le traitement de bout en bout.
À quelle fréquence devons-nous rapprocher les expéditions ?
Choisissez une fréquence en fonction du délai de détection acceptable, du volume d’expéditions actives, du budget de requêtes et des limites documentées. Utilisez des contrôles plus fréquents pour les segments sensibles sur le plan opérationnel et une analyse planifiée plus large pour assurer la couverture. Aucun intervalle unique ne convient à tous les transporteurs et workflows.
L’absence d’activité des webhooks signifie-t-elle que l’intégration est défaillante ?
Non. Il se peut qu’aucun nouvel événement n’ait eu lieu. Comparez l’activité des callbacks avec la population d’expéditions actives, les tendances récentes, l’état du récepteur et un contrôle de récupération indépendant lorsqu’il est pris en charge. Déclenchez les alertes sur la base d’éléments corroborants plutôt que sur le seul silence.
Devons-nous interroger le système en continu comme solution de secours ?
Pas par défaut. Des interrogations incontrôlées peuvent consommer la capacité de requêtes sans améliorer la visibilité. Utilisez un rapprochement limité et une récupération propre à l’incident dans les limites documentées. Vérifiez comment les interrogations et la livraison des webhooks interagissent pour votre fournisseur.
Que devons-nous envoyer lors de l’escalade d’un problème présumé chez le fournisseur ?
Incluez les types d’opérations concernés, les plages horaires UTC, les ID de requête nettoyés, les codes de réponse, des références d’expédition représentatives via un canal sécurisé approuvé et le comportement attendu par rapport au comportement observé. Expliquez quelles étapes internes vous avez vérifiées. N’incluez ni identifiants ni données client inutiles.
Sources
- Google SRE : Monitoring Distributed Systems — les quatre signaux clés et les principes de surveillance.
- OpenTelemetry : Logs Data Model — la distinction entre les horodatages des événements et les horodatages observés.
- Documentation de l’API Tracking 17TRACK — la référence d’implémentation pour une intégration 17TRACK.
- API Tracking 17TRACK — le contexte produit officiel.