Przewodnik po niezawodności Tracking API: jak monitorować dostępność, aktualność danych i pominięte aktualizacje po uruchomieniu produkcyjnym
Po uruchomieniu produkcyjnym monitoruj niezawodność API śledzenia na trzech odrębnych poziomach: czy żądania kończą się powodzeniem, czy informacje o przesyłkach docierają z akceptowalnym opóźnieniem oraz czy aktualizacje docierają do Twoich systemów bez luk. Pomyślna odpowiedź API nie dowodzi, że dane śledzenia są aktualne ani że powiadomienie klienta zostało dostarczone. Nadaj każdemu poziomowi własne metryki, alerty i procedurę odzyskiwania.
Ten przewodnik jest przeznaczony dla inżynierów i zespołów operacyjnych odpowiedzialnych za działającą produkcyjnie integrację śledzenia przesyłek. Celem jest wykrycie utraty widoczności, zanim stanie się ona problemem dla pomocy technicznej, a następnie ustalenie, czy przyczyna leży po stronie danych przewoźnika, dostawcy śledzenia, odbiornika webhooków czy przetwarzania następującego dalej.
Zdefiniuj, co oznacza niezawodna aktualizacja śledzenia
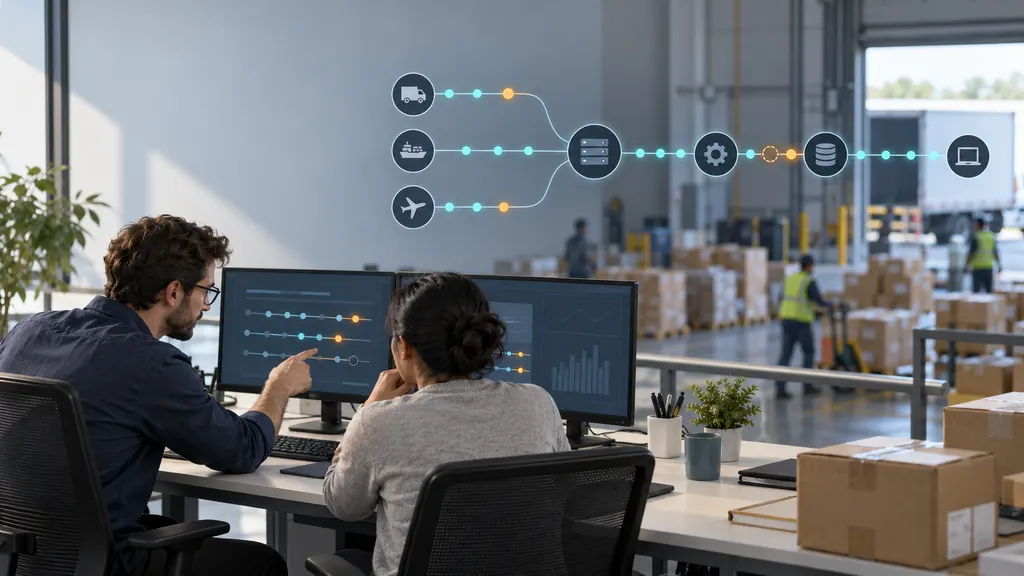
Rozpocznij od pełnej ścieżki dostawy: rejestracji przesyłki, pobrania danych przez dostawcę, odpowiedzi API lub dostarczenia webhooka, przetwarzania wewnętrznego, utrwalenia w bazie danych i wyświetlenia dla klienta. Jeśli wysyłasz powiadomienia, traktuj to jako kolejny etap, zamiast zakładać, że zapisana aktualizacja dotarła do kupującego.
Dla każdego etapu zapisz jego właściciela oraz dowody potwierdzające powodzenie. Zaakceptowanie numeru śledzenia przez dostawcę dowodzi, że rejestracja została przyjęta, a nie że przewoźnik opublikował zdarzenie. Otrzymanie przez webhook pomyślnej odpowiedzi HTTP dowodzi, że punkt końcowy potwierdził odbiór, ale niekoniecznie, że worker zatwierdził aktualizację.
Wytyczne SRE firmy Google opisują opóźnienie, ruch, błędy i nasycenie jako cztery złote sygnały monitorowania. Sygnały te są przydatne w przypadku infrastruktury integracji, ale śledzenie przesyłek wymaga również kontroli aktualności i kompletności, ponieważ pozornie sprawny punkt końcowy może dostarczać niezmienione lub niepełne informacje.
| Warstwa | Pytanie, na które należy odpowiedzieć | Gromadzone dowody |
|---|---|---|
| Dostępność API | Czy integracja może zakończyć prawidłową operację? | Wynik transportu, wynik aplikacji, opóźnienie, wskaźnik przekroczeń limitu czasu |
| Aktualność danych | Jak bardzo informacje są opóźnione? | Czas zdarzenia, czas obserwacji, czas otrzymania, czas utrwalenia |
| Kompletność aktualizacji | Czy każda oczekiwana i możliwa do pobrania aktualizacja dotarła do miejsca docelowego? | Różnice uzgodnienia, rejestry przetwarzania, nierozwiązane luki |
| Widoczność dla klienta | Czy wyświetlany status odpowiada zapisanemu stanowi przesyłki? | Kontrole ścieżki odczytu, wiek pamięci podręcznej, wyniki przetwarzania powiadomień |
Oprzyrządkuj integrację przed skonfigurowaniem alertów
Prowadź operacyjny rejestr łączący przesyłkę z próbą rejestracji, przychodzącymi aktualizacjami, próbami przetwarzania i wynikowym stanem. Do korelacji używaj wewnętrznego identyfikatora przesyłki; w miarę możliwości nie umieszczaj numerów śledzenia ani danych klientów w szeroko dostępnych logach.
Minimalny użyteczny rejestr obejmuje:
- Wewnętrzny identyfikator przesyłki, identyfikator przewoźnika, jeśli jest znany, konto integracji i środowisko.
- Identyfikator żądania lub korelacji, typ operacji, czas próby, kategorię wyniku i czas trwania.
- Identyfikator zdarzenia dostawcy, jeśli został przekazany, a także oryginalny znacznik czasu zdarzenia i informacje o strefie czasowej.
- Czas otrzymania webhooka, czas trwałego zapisu, czas zakończenia przetwarzania oraz czas dostępności w widoku, jeśli można je zmierzyć.
- Wersję schematu danych, jeśli jest dostępna, wynik analizy, wynik deduplikacji i przyczynę niepowodzenia.
Przechowuj oryginalny ładunek danych z odpowiednimi kontrolami dostępu i retencji, gdy jest potrzebny do analizy lub ponownego odtworzenia. Nie zapisuj w logach nagłówków autoryzacyjnych ani sekretów. Dla metryk używaj ograniczonych wymiarów, takich jak przewoźnik i kategoria wyniku; poszczególne numery śledzenia powinny znajdować się w przeszukiwalnych rejestrach, a nie w etykietach metryk o dużej kardynalności.
Oddziel czas zdarzenia od czasu obserwacji. Model danych logów OpenTelemetry wyraźnie rozróżnia je za pomocą pól Timestamp i ObservedTimestamp. Zastosowanie tego samego rozróżnienia do rejestrów śledzenia pomaga uniknąć pomylenia późno zgłoszonego zdarzenia przewoźnika z powolnym zapisem do bazy danych.
Monitoruj dostępność z perspektywy swojej aplikacji
Wykorzystuj zarówno rzeczywisty ruch produkcyjny, jak i syntetyczną kontrolę o małym natężeniu. Ruch produkcyjny pokazuje rzeczywisty wpływ na klientów. Kontrola syntetyczna może wykrywać awarie, gdy ruch produkcyjny jest niewielki, pod warunkiem że korzysta z udokumentowanej, nieinwazyjnej operacji i respektuje limity użytkowania dostawcy.
Przydatny wskaźnik powodzenia żądań to:
Successful eligible operations / All eligible attempted operations
Zdefiniuj „powodzenie” na podstawie zarówno statusu HTTP, jak i udokumentowanego wyniku na poziomie aplikacji. Niektóre interfejsy mogą zwrócić pomyślną odpowiedź HTTP, jednocześnie zgłaszając nieudaną operację w treści odpowiedzi. W przypadku operacji wsadowych mierz wyniki na poziomie elementu oraz na poziomie żądania.
Utrzymuj dwa widoki błędów. Widok wpływu na klienta obejmuje wszystko, co uniemożliwia aplikacji wykonanie zadania. Widok diagnostyczny rozdziela błędy dostawcy, awarie sieci, problemy z uwierzytelnianiem, nieprawidłowe dane wejściowe oraz odpowiedzi związane z limitami lub ograniczeniem częstotliwości. Wygasłe dane uwierzytelniające mogą nie oznaczać awarii dostawcy, ale nadal stanowią awarię Twojej integracji.
- Opóźnienie: Śledź wartości p50, p95 i p99, jeśli natężenie ruchu pozwala uzyskać miarodajne percentyle. Mierz przekroczenia limitu czasu osobno, aby szybkie błędy nie sprawiały, że opóźnienie będzie wyglądać prawidłowo.
- Ruch: Porównuj liczbę żądań i wywołań zwrotnych z rejestracjami przesyłek oraz populacją aktywnych przesyłek.
- Błędy: Rozdzielaj awarie transportu, awarie aplikacji, błędy analizy i błędy trwałego zapisu w systemach dalszego przetwarzania.
- Nasycenie: Monitoruj pule połączeń, wydajność workerów, głębokość kolejki, wiek najstarszego elementu w kolejce oraz dostępny budżet żądań.
Nie przedstawiaj tych pomiarów jako umownej dostępności dostawcy, chyba że stosują dokładnie definicje zawarte w umowie. Obserwowana dostępność integracji i umowa SLA dostawcy odpowiadają na różne pytania.
Mierz aktualność bez mylenia ciszy z awarią
Przesyłka, która się nie porusza, nie jest automatycznie nieaktualna. Transport międzynarodowy, przekazania, weekendy i praktyki skanowania przewoźników mogą powodować uzasadnione przerwy. Problem monitorowania polega na odróżnieniu sytuacji „nic nowego się nie wydarzyło” od sytuacji „nowe informacje istnieją, ale nasz system ich nie otrzymał”.
Używaj oddzielnych zegarów dla oddzielnych opóźnień
- Wiek najnowszego zdarzenia: Bieżący czas minus czas najnowszego zdarzenia przewoźnika. Opisuje widoczność przesyłki, a niekoniecznie wydajność integracji.
- Opóźnienie otrzymania: Czas otrzymania przez Ciebie minus czas zdarzenia. Obejmuje opóźnienia raportowania i pobierania danych z wcześniejszych etapów, gdy pośrednie znaczniki czasu są niedostępne.
- Wewnętrzne opóźnienie przetwarzania: Czas zakończenia trwałego przetwarzania minus czas otrzymania. Izoluje pracę wykonywaną w Twoim systemie.
- Opóźnienie wyświetlania: Czas dostępności dla klienta minus czas zakończenia przetwarzania. Może ujawnić problemy z pamięcią podręczną lub modelem odczytu.
- Wiek weryfikacji: Bieżący czas minus czas ostatniej pomyślnej kontroli pod kątem nowszych informacji. Mierzy aktywność sprawdzania, a nie dowodzi aktualności danych przewoźnika.
Obliczaj opóźnienie pozyskiwania danych właściwe dla dostawcy tylko wtedy, gdy istnieje wymagany znacznik czasu dostawcy, a jego znaczenie jest udokumentowane. Bez niego opóźnienia otrzymania nie można uczciwie przypisać jednej stronie.
Normalizuj znaczniki czasu do spójnej strefy czasowej, zachowując ich oryginalną reprezentację. Oznaczaj brakujące informacje o strefie czasowej, zdarzenia z przyszłą datą i niespójności zegarów. Nie konwertuj po cichu ujemnego opóźnienia do zera; zbadaj je lub zaklasyfikuj jako problem jakości znacznika czasu.
Porównuj podobne przesyłki
Twórz widoki aktualności według przewoźnika, usługi lub trasy, jeśli są znane, statusu przesyłki i czasu od rejestracji. Oddzielaj nowo zarejestrowane przesyłki oczekujące na pierwsze zdarzenie od przesyłek znajdujących się już w transporcie. Wykluczaj dostarczone przesyłki z kontroli aktywnego przemieszczania zgodnie z zasadami operacyjnymi, zachowując wymagane przez proces monitorowanie po doręczeniu.
Ustalaj początkowe progi na podstawie wymagań biznesowych i obserwowanego zachowania, a nie wymyślonego uniwersalnego interwału odświeżania. Próg odpowiedni dla dostawy lokalnej może powodować szum w przypadku przekazania transgranicznego. Z kolei szeroka średnia sieciowa może ukryć problem dotyczący jednego przewoźnika.
Oznaczaj każdy panel aktualności informacją o zakresie. Jeśli dla części populacji brakuje znaczników czasu zdarzeń, pokazuj tę populację osobno, zamiast sprawiać, że pozostałe przesyłki będą wyglądać na reprezentatywne dla całego ruchu.
Wykrywaj pominięte aktualizacje dzięki uzgadnianiu
Sama liczba webhooków nie pozwala ustalić kompletności. Niewielki ruch może być normalny, a pomyślna odpowiedź webhooka może ukrywać błąd dalszego przetwarzania. Uzgadnianie porównuje to, co obecnie udostępnia źródło referencyjne, z tym, co system faktycznie zapisał lub przetworzył.
- Zdefiniuj kwalifikującą się populację. Uwzględnij zarejestrowane, aktywnie monitorowane przesyłki. Odrzucone rejestracje i wstrzymane monitorowanie śledź osobno, aby nie znikały z raportów operacyjnych.
- Wybierz źródło referencyjne. Jeśli udokumentowane API na to pozwala, pobieraj bieżące szczegóły śledzenia niezależnie od obsługi webhooków. Strony śledzenia przewoźników mogą pomóc w analizie pojedynczych przypadków, ale bez autoryzacji nie powinny stać się zależnością od automatycznego skrobania.
- Zastosuj okres karencji. Uwzględnij normalne opóźnienia dostarczania i przetwarzania, zanim zaklasyfikujesz różnicę jako podejrzaną lukę.
- Porównuj dane tego samego rodzaju. Dopasowuj obsługiwane identyfikatory zdarzeń albo stosuj udokumentowaną regułę normalizacji znaczników czasu, statusów, lokalizacji i opisów.
- Odzyskuj bezpiecznie. Odtwarzaj zachowane wiadomości lub pobieraj dozwolone aktualizacje za pomocą zwykłej, idempotentnej ścieżki przetwarzania.
- Potwierdź miejsce docelowe. Sprawdź, czy baza danych i widok dla klienta zostały poprawione, a nie tylko czy uruchomiono zadanie odzyskiwania.
Wewnętrzny wskaźnik można wyrazić następująco:
Eligible reconciled shipments with unresolved differences / All eligible reconciled shipments
Nazywaj to wskaźnikiem nierozwiązanych luk uzgodnienia, a nie uniwersalnym wskaźnikiem pominiętych zdarzeń. Jeśli źródło referencyjne udostępnia tylko najnowszy stan, nie może dowieść, że dotarło każde historyczne zdarzenie. Nawet zgodny status końcowy może ukrywać pominięty etap pośredni.
Rozpocznij od warstwowej próby obejmującej przewoźników, wiek przesyłek i statusy. Podczas incydentu zwiększaj zakres dla dotkniętych segmentów, z zachowaniem udokumentowanych limitów. Raportuj zarówno liczbę sprawdzonych przesyłek, jak i liczbę przesyłek z różnicami, aby mała próba nie została uznana za pełny zakres.
Zapewnij możliwość odzyskiwania danych z obsługi webhooków
Zaprojektuj odbiornik tak, aby weryfikował przychodzące żądania i trwale przechwytywał zaakceptowane wiadomości przed ich potwierdzeniem, zgodnie z udokumentowaną umową dostarczania dostawcy. W miarę możliwości przenieś wolniejszą logikę biznesową do oddzielnego workera.
Weryfikuj rzeczywiste zasady integracji, zamiast je zakładać: uwierzytelnianie lub walidację podpisu, wymagania dotyczące potwierdzenia, limit czasu żądania, warunki ponowień, czas trwania ponowień, kolejność i dostępność ponownego odtworzenia. Szczegóły te określają, jakie mechanizmy odzyskiwania musi zapewnić aplikacja.
- Uwzględnij duplikaty w projekcie: Jeśli jest dostępny, używaj udokumentowanego identyfikatora zdarzenia. W przeciwnym razie utwórz starannie ograniczony klucz deduplikacji i przetestuj go względem prawidłowych, podobnych zdarzeń.
- Obsługuj dostarczanie poza kolejnością: Zachowuj historię zdarzeń i stosuj jawne reguły przejść zamiast bezkrytycznie zastępować stan przesyłki ostatnią otrzymaną wiadomością.
- Izoluj błędy: Zachowuj wiadomości niemożliwe do przetworzenia wraz ze szczegółami błędu i udostępniaj kontrolowany proces ponownego kierowania.
- Oddziel odzyskiwanie stanu od skutków ubocznych: Ponowne odtworzenie zdarzenia nie powinno automatycznie wysyłać ponownie starej wiadomości e-mail o dostawie ani powtarzać innej czynności skierowanej do klienta.
Jeśli Twoja integracja korzysta z 17TRACK, używaj oficjalnej dokumentacji Tracking API jako źródła odniesienia podczas implementacji i sprawdź wymagania dotyczące Twojej integracji. Strona produktu Tracking API zapewnia kontekst produktu, ale progi monitorowania i założenia dotyczące odzyskiwania powinny wynikać z udokumentowanego działania, umowy serwisowej i pomiarów produkcyjnych, a nie z opisów produktu.
Przekształcaj pulpity nawigacyjne w użyteczne alerty
Każdy alert powinien wskazywać dotkniętą populację, prawdopodobny etap awarii, wpływ biznesowy i pierwszy krok analizy. Globalny alert „śledzenie jest nieaktualne” rzadko dostarcza wystarczających informacji do działania.
| Wzorzec sygnału | Pierwsza analiza | Główny właściciel |
|---|---|---|
| Żądania kończą się niepowodzeniem u kilku przewoźników | Sprawdź dane uwierzytelniające, sieć, limity i odpowiedzi dostawcy | Dyżurny zespołu integracji lub platformy |
| Wywołania zwrotne docierają, ale rośnie wiek przetwarzania | Sprawdź workery, stan bazy danych i odizolowane wiadomości | Inżynieria aplikacji |
| Jeden przewoźnik wykazuje nietypowe luki aktualności | Porównaj kohorty i przykładowe referencyjne rejestry śledzenia | Operacje śledzenia wraz z inżynierią |
| Zapisany stan jest aktualny, ale wyświetlany jest stary | Sprawdź pamięci podręczne, modele odczytu i pobieranie danych przez frontend | Zespół aplikacji klienckiej |
Stosuj utrzymujące się przekroczenia progów i minimalne rozmiary prób, aby ograniczyć szum. W przypadku celów dostępności i przetwarzania budżet błędów może pomóc odróżnić krótkotrwałą anomalię od awarii zużywającej niedopuszczalną część dozwolonych błędów. Cele aktualności danych przewoźnika utrzymuj oddzielnie od celów bezpośrednio kontrolowanych przez zespół inżynieryjny.
Używaj procedury odzyskiwania, która potwierdza zakończenie
Po rozpoczęciu incydentu ustal ostatni znany prawidłowy punkt i zachowaj odpowiednie rejestry. Określ, czy dotyczy on nowych rejestracji, przychodzących wiadomości, przetwarzania czy aktualizacji wyświetlania. Następnie oszacuj populację przesyłek zagrożonych problemem, zamiast raportować wyłącznie liczbę żądań.
Przywróć niedziałający etap, odtwórz lub pobierz dane ponownie w ramach udokumentowanych limitów i przeprowadź uzgodnienie z dotkniętą populacją. Zamknij incydent dopiero po powrocie wieku zaległości do normy, rozliczeniu nierozwiązanych luk i sprawdzeniu stanu widocznego dla klienta. Oddzielnie zapisz wszelkie historyczne aktualizacje, których nie można odzyskać.
Testuj ten proces przy użyciu kontrolowanych awarii: niedostępnego odbiornika, nieprawidłowego ładunku danych, awarii workera, zduplikowanego zdarzenia, zdarzenia dostarczonego poza kolejnością i wygasłych danych uwierzytelniających. Test kończy się powodzeniem, gdy zespół wykryje problem, zidentyfikuje jego właściciela, odzyska dane i uniknie zduplikowanych skutków ubocznych, a nie tylko wtedy, gdy punkt końcowy stanie się ponownie osiągalny.
FAQ
Czy API może zwracać pomyślne odpowiedzi, gdy informacje o śledzeniu są nieaktualne?
Tak. Powodzenie żądania potwierdza, że operacja została zakończona zgodnie z zasadami interfejsu. Nie potwierdza, że przewoźnik opublikował nowy skan ani że każdy system dalszego przetwarzania przetworzył wynik. Monitoruj aktualność i przetwarzanie kompleksowe oddzielnie.
Jak często powinniśmy uzgadniać przesyłki?
Wybierz częstotliwość na podstawie akceptowalnego opóźnienia wykrywania, liczby aktywnych przesyłek, budżetu żądań i udokumentowanych limitów. Częstsze kontrole stosuj w segmentach wrażliwych operacyjnie, a szersze zaplanowane skanowanie do zapewnienia pokrycia. Nie istnieje jeden interwał odpowiedni dla każdego przewoźnika i procesu.
Czy brak aktywności webhooków oznacza, że integracja jest niesprawna?
Nie. Może po prostu nie być nowych zdarzeń. Porównaj aktywność wywołań zwrotnych z populacją aktywnych przesyłek, ostatnimi wzorcami, stanem odbiornika i niezależną kontrolą pobierania danych, jeśli jest obsługiwana. Alerty uruchamiaj na podstawie potwierdzających się dowodów, a nie samej ciszy.
Czy powinniśmy stale odpytywać API jako rozwiązanie zapasowe?
Nie domyślnie. Niekontrolowane odpytywanie może zużywać przepustowość żądań bez poprawy widoczności. Stosuj ograniczone uzgadnianie i pobieranie danych właściwe dla incydentu, w ramach udokumentowanych limitów. Potwierdź, jak odpytywanie i dostarczanie webhooków współdziałają u Twojego dostawcy.
Co powinniśmy przesłać podczas eskalacji podejrzenia problemu po stronie dostawcy?
Uwzględnij typy dotkniętych operacji, zakresy czasu w UTC, oczyszczone identyfikatory żądań, kody odpowiedzi, reprezentatywne identyfikatory przesyłek za pośrednictwem zatwierdzonego bezpiecznego kanału oraz oczekiwane i zaobserwowane zachowanie. Wyjaśnij, które wewnętrzne etapy zostały sprawdzone. Nie dołączaj danych uwierzytelniających ani niepotrzebnych danych klientów.
Źródła
- Google SRE: Monitoring Distributed Systems — cztery złote sygnały i zasady monitorowania.
- OpenTelemetry: Logs Data Model — rozróżnienie między znacznikami czasu zdarzenia i obserwacji.
- 17TRACK Tracking API documentation — źródło odniesienia podczas implementacji integracji z 17TRACK.
- 17TRACK Tracking API — oficjalny kontekst produktu.