Vodnik za zanesljivost API-ja za sledenje: Kako spremljati čas delovanja, svežino podatkov in izpuščene posodobitve po zagonu v produkciji
Po zagonu v produkciji spremljajte zanesljivost API-ja za sledenje na treh ločenih ravneh: ali so zahteve uspešne, ali informacije o pošiljki prispejo v sprejemljivem času in ali posodobitve brez vrzeli dosežejo vaše lastne sisteme. Uspešen odgovor API-ja ne dokazuje, da so podatki o sledenju sveži ali da je bilo obvestilo stranki dostavljeno. Vsaki ravni dodelite lastne metrike, opozorila in postopek za obnovitev.
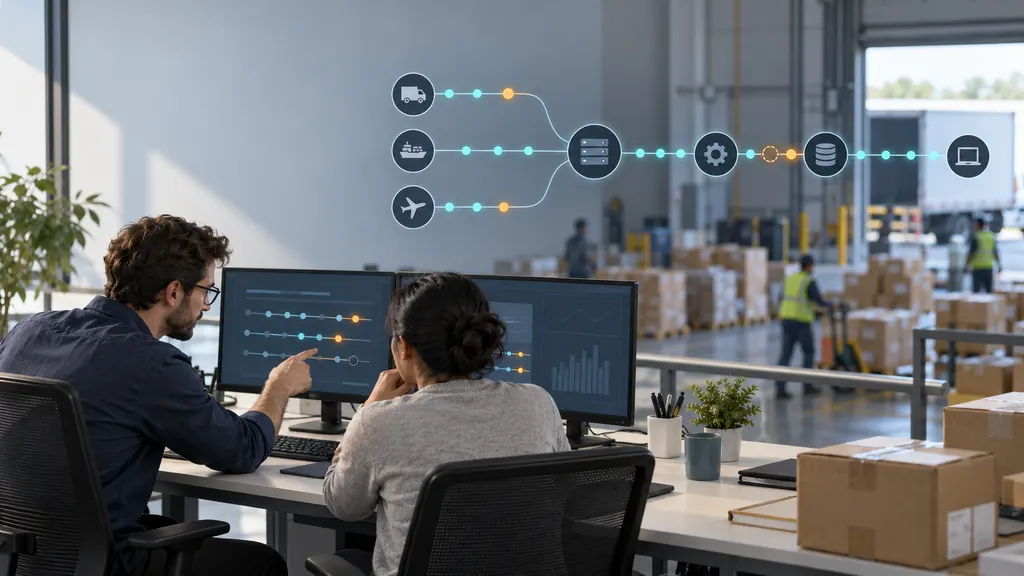
Ta vodnik je namenjen inženirjem in operativnim ekipam, odgovornim za delujočo integracijo sledenja pošiljk. Cilj je zaznati izgubo vidljivosti, preden ta postane težava za podporo, nato pa ugotoviti, ali je napaka pri viru podatkov prevoznika, ponudniku sledenja, vašem prejemniku webhookov ali nadaljnji obdelavi.
Opredelite, kaj pomeni zanesljiva posodobitev sledenja
Začnite s celotno potjo dostave: registracija pošiljke, pridobivanje podatkov ponudnika, odgovor API-ja ali dostava webhooka, interna obdelava, shranjevanje v zbirko podatkov in prikaz stranki. Če pošiljate obvestila, jih obravnavajte kot dodatno stopnjo, namesto da predpostavite, da je shranjena posodobitev dosegla kupca.
Za vsako stopnjo zabeležite njenega lastnika in dokaze, ki potrjujejo uspeh. To, da ponudnik sprejme številko za sledenje, dokazuje sprejem registracije, ne pa tudi, da je prevoznik objavil dogodek. Prejem webhooka z uspešnim odgovorom HTTP dokazuje, da ga je vaša končna točka potrdila, ne pa nujno, da je vaš delavec posodobitev shranil.
Googlove smernice SRE opisujejo zakasnitev, promet, napake in zasičenost kot štiri zlate signale spremljanja. Ti signali so uporabni za vašo integracijsko infrastrukturo, vendar sledenje pošiljkam zahteva tudi preverjanje svežine in popolnosti, saj lahko navidezno zdrava končna točka posreduje nespremenjene ali nepopolne informacije.
| Raven | Vprašanje, na katerega je treba odgovoriti | Dokazi za zbiranje |
|---|---|---|
| Razpoložljivost API-ja | Ali lahko integracija dokonča veljavno operacijo? | Rezultat prenosa, rezultat aplikacije, zakasnitev, stopnja časovnih omejitev |
| Svežina podatkov | Kako zelo informacije zaostajajo? | Čas dogodka, čas opazovanja, čas prejema, čas shranjevanja |
| Popolnost posodobitev | Ali je vsaka pričakovana in pridobljiva posodobitev dosegla cilj? | Razlike pri usklajevanju, zapisi obdelave, nerazrešene vrzeli |
| Vidljivost za stranko | Ali se prikazano stanje ujema s shranjenim stanjem pošiljke? | Preverjanja poti branja, starost predpomnilnika, rezultati obdelave obvestil |
Pred nastavitvijo opozoril opremite integracijo z merjenjem
Vodite operativni zapis, ki povezuje pošiljko z njenim poskusom registracije, prejetimi posodobitvami, poskusi obdelave in končnim stanjem. Za korelacijo uporabite interni identifikator pošiljke; številke za sledenje in podatke o strankah po možnosti hranite zunaj široko dostopnih dnevnikov.
Najmanj uporaben zapis vključuje:
- Interni ID pošiljke, identifikator prevoznika, kadar je znan, integracijski račun in okolje.
- ID zahteve ali korelacije, vrsto operacije, čas poskusa, kategorijo rezultata in trajanje.
- ID dogodka ponudnika, kadar je posredovan, ter izvirni čas dogodka in informacije o časovnem pasu.
- Čas prejema webhooka, čas trajnega shranjevanja, čas zaključka obdelave in čas razpoložljivosti prikaza, kadar jih je mogoče izmeriti.
- Različico sheme tovora, kadar je na voljo, rezultat razčlenjevanja, rezultat odstranjevanja dvojnikov in razlog napake.
Izvirni tovor ohranite z ustreznim nadzorom dostopa in hrambe, kadar je potreben za preiskavo ali ponovitev. Ne beležite avtorizacijskih glav ali skrivnosti. Za metrike uporabite omejene dimenzije, kot sta prevoznik in kategorija rezultata; posamezne številke za sledenje sodijo v zapise, po katerih je mogoče iskati, ne pa med oznake metrik z velikim številom različnih vrednosti.
Čas dogodka ločite od časa opazovanja. Podatkovni model dnevnikov OpenTelemetry to razliko izrecno izraža prek Timestamp in ObservedTimestamp. Uporaba iste razlike pri zapisih sledenja pomaga preprečiti, da bi pozno poročan dogodek prevoznika zamenjali za počasno zapisovanje v zbirko podatkov.
Razpoložljivost spremljajte z vidika svoje aplikacije
Uporabite tako dejanski produkcijski promet kot sintetično preverjanje z majhnim obsegom. Produkcijski promet razkrije dejanski vpliv na stranke. Sintetično preverjanje lahko zazna napake, ko je produkcijski promet majhen, če uporablja dokumentirano, nespremenljivo operacijo in upošteva omejitve uporabe ponudnika.
Uporaben kazalnik uspešnosti zahtev je:
Uspešne primerne operacije / Vse poskusene primerne operacije
»Uspešno« opredelite tako s statusom HTTP kot z dokumentiranim rezultatom na ravni aplikacije. Nekateri vmesniki lahko vrnejo uspešen odgovor HTTP, medtem ko v telesu poročajo o neuspešni operaciji. Pri paketnih operacijah merite rezultate na ravni elementov in na ravni zahtev.
Vzdržujte dva pogleda na napake. Pogled vpliva na stranko vključuje vse, kar vaši aplikaciji preprečuje dokončanje naloge. Diagnostični pogled ločuje napake ponudnika, omrežne napake, težave z avtentikacijo, neveljaven vnos ter odgovore o kvoti ali omejitvi hitrosti. Poteklo poverilno sredstvo morda ni izpad ponudnika, vendar je še vedno izpad vaše integracije.
- Zakasnitev: Spremljajte p50, p95 in p99, kadar obseg prometa omogoča smiselne percentile. Časovne omejitve merite ločeno, da zaradi hitrih napak zakasnitev ne bi bila videti zdrava.
- Promet: Obseg zahtev in povratnih klicev primerjajte z registracijami pošiljk in aktivno populacijo pošiljk.
- Napake: Ločite napake prenosa, napake aplikacije, napake razčlenjevanja in napake nadaljnjega shranjevanja.
- Zasičenost: Spremljajte bazene povezav, zmogljivost delavcev, globino čakalne vrste, najstarejši element v čakalni vrsti in razpoložljivi proračun zahtev.
Teh meritev ne predstavljajte kot pogodbeno razpoložljivost ponudnika, razen če uporabljajo natančne opredelitve iz pogodbe. Opažena razpoložljivost vaše integracije in pogodba o ravni storitve ponudnika odgovarjata na različni vprašanji.
Merite svežino, ne da bi tišino zamenjali za napako
Pošiljka, ki se ni premaknila, ni samodejno zastarela. Mednarodni tranzit, predaje, vikendi in prakse skeniranja prevoznikov lahko povzročijo legitimne vrzeli. Težava spremljanja je razlikovati med »nič novega se ni zgodilo« in »nove informacije obstajajo, vendar jih naš sistem še ni prejel«.
Za različne zakasnitve uporabite ločene ure
- Starost najnovejšega dogodka: Trenutni čas minus čas najnovejšega dogodka prevoznika. To opisuje vidljivost pošiljke, ne nujno uspešnosti integracije.
- Zakasnitev prejema: Čas vašega prejema minus čas dogodka. To vključuje zakasnitve poročanja in pridobivanja iz zgornjih sistemov, kadar vmesni časovni žigi niso na voljo.
- Interna zakasnitev obdelave: Čas zaključka trajne obdelave minus čas prejema. To izolira delo znotraj vašega sistema.
- Zakasnitev prikaza: Čas razpoložljivosti za stranko minus čas zaključka obdelave. To lahko razkrije težave s predpomnilnikom ali bralnim modelom.
- Starost preverjanja: Trenutni čas minus zadnje uspešno preverjanje novejših informacij. To meri dejavnost preverjanja, ne dokazuje pa, da je vir podatkov prevoznika aktualen.
Zakasnitev vnosa, specifično za ponudnika, izračunajte samo, če obstaja potreben časovni žig ponudnika in je njegov pomen dokumentiran. Brez njega zakasnitve prejema ni mogoče pošteno pripisati eni strani.
Časovne žige normalizirajte na enoten časovni pas, hkrati pa ohranite njihovo izvirno predstavitev. Označite manjkajoče informacije o časovnem pasu, dogodke z datumom v prihodnosti in nedoslednosti ur. Negativne zakasnitve ne pretvarjajte tiho v nič; raziščite jo ali jo razvrstite kot težavo kakovosti časovnega žiga.
Primerjajte podobne pošiljke
Prikaze svežine ustvarite po prevozniku, storitvi ali poti, kadar so znane, po statusu pošiljke in času od registracije. Ločite na novo registrirane pošiljke, ki čakajo na prvi dogodek, od pošiljk, ki so že v tranzitu. Dostavljene pošiljke izključite iz preverjanj aktivnega premikanja v skladu z operativnimi pravili, hkrati pa ohranite nadzor po dostavi, ki ga zahteva vaš potek dela.
Začetne pragove določite na podlagi poslovnih zahtev in opaženega vedenja, ne na podlagi izmišljenega univerzalnega intervala osveževanja. Prag, primeren za lokalno dostavo, lahko povzroči šum pri čezmejni predaji. Nasprotno lahko široko omrežno povprečje skrije težavo, ki vpliva na enega prevoznika.
Vsak panel svežine označite z njegovim obsegom. Če za del populacije manjkajo časovni žigi dogodkov, to populacijo prikažite ločeno, namesto da bi preostale pošiljke predstavljale kot reprezentativne za ves promet.
Z usklajevanjem poiščite zamujene posodobitve
Sam obseg webhookov ne more potrditi popolnosti. Majhen promet je lahko normalen, uspešen odgovor webhooka pa lahko skrije napako nadaljnje obdelave. Usklajevanje primerja podatke, ki jih trenutno izpostavlja referenčni vir, s tem, kar je vaš sistem dejansko shranil ali obdelal.
- Opredelite primerno populacijo. Vključite registrirane, aktivno spremljane pošiljke. Zavrnjene registracije in začasno ustavljeno spremljanje spremljajte ločeno, da ne izginejo iz operativnega poročanja.
- Izberite referenco. Kadar dokumentirani API to omogoča, trenutne podrobnosti sledenja pridobite neodvisno od vnosa webhookov. Strani za sledenje prevoznikov lahko pomagajo pri preiskavi posameznih primerov, vendar brez dovoljenja ne smejo postati avtomatizirana odvisnost od strganja podatkov.
- Uporabite obdobje tolerance. Preden razliko razvrstite kot domnevno vrzel, omogočite običajne zamude pri dostavi in obdelavi.
- Primerjajte primerljivo s primerljivim. Ujemajte podprte identifikatorje dogodkov ali uporabite dokumentirano normalizacijsko pravilo za časovne žige, statuse, lokacije in opise.
- Varno obnovite stanje. Ponovite shranjena sporočila ali pridobite dovoljene posodobitve po običajni idempotentni poti obdelave.
- Potrdite cilj. Preverite, ali sta zbirka podatkov in prikaz za stranko popravljena, ne le, ali je opravilo za obnovitev steklo.
Interni kazalnik je mogoče izraziti tako:
Primerne usklajene pošiljke z nerazrešenimi razlikami / Vse primerne usklajene pošiljke
To imenujte stopnja nerazrešenih vrzeli pri usklajevanju, ne univerzalna stopnja zamujenih dogodkov. Če referenca izpostavlja samo najnovejše stanje, ne more dokazati, da je prispel vsak zgodovinski dogodek. Tudi ujemanje končnega statusa lahko skrije zamujen vmesni mejnik.
Začnite s stratificiranim vzorcem po prevoznikih, starosti pošiljk in statusih. Med incidentom razširite obseg za prizadete segmente, pri čemer upoštevajte dokumentirane omejitve. Poročajte o številu preverjenih in številu pošiljk z razlikami, da majhen vzorec ne bi bil zamenjan za popolno pokritost.
Omogočite obnovitev vnosa webhookov
Prejemnik naj preveri vhodne zahteve in trajno zajame sprejeta sporočila, preden jih potrdi, skladno z dokumentirano pogodbo dostave ponudnika. Počasnejšo poslovno logiko, kjer je praktično, izvajajte v ločenem delavcu.
Preverite dejanska pravila integracije, namesto da jih predpostavljate: avtentikacijo ali preverjanje podpisa, zahteve za potrditev, časovno omejitev zahteve, pogoje ponovnega poskusa, trajanje ponovnih poskusov, vrstni red in razpoložljivost ponovitve. Te podrobnosti določajo, kakšno obnovitev mora zagotoviti vaša aplikacija.
- V zasnovi pričakujte dvojnike: Kadar je na voljo, uporabite dokumentirani ID dogodka. Sicer ustvarite skrbno omejen ključ za odstranjevanje dvojnikov in ga preizkusite z legitimnimi podobnimi dogodki.
- Obravnavajte dostavo izven vrstnega reda: Ohranite zgodovino dogodkov in uporabite izrecna pravila prehodov, namesto da bi stanje pošiljke slepo nadomestili z zadnjim prejetim sporočilom.
- Izolirajte napake: Neobdelana sporočila hranite skupaj s podrobnostmi napake in zagotovite nadzorovan postopek ponovne obdelave.
- Ločite obnovitev stanja od stranskih učinkov: Ponovitev dogodka ne sme samodejno znova poslati starega e-poštnega obvestila o dostavi ali ponoviti drugega dejanja, usmerjenega k stranki.
Če vaša integracija uporablja 17TRACK, kot izvedbeni vir uporabite uradno dokumentacijo API-ja za sledenje in preverite zahteve, ki veljajo za vašo integracijo. Stran izdelka Tracking API zagotavlja kontekst izdelka, vendar morajo pragovi spremljanja in predpostavke o obnovitvi izhajati iz dokumentiranega vedenja, vaše pogodbe o storitvah in produkcijskih meritev, ne iz opisov izdelka.
Nadzorne plošče pretvorite v uporabna opozorila
Vsako opozorilo mora določiti prizadeto populacijo, verjetno stopnjo napake, poslovni vpliv in prvi korak preiskave. Globalno opozorilo »sledenje je zastarelo« redko zagotavlja dovolj informacij za ukrepanje.
| Vzorec signala | Prva preiskava | Glavni lastnik |
|---|---|---|
| Zahteve ne uspejo pri več prevoznikih | Preverite poverilnice, omrežje, omejitve in odgovore ponudnika | Dežurna ekipa za integracijo ali platformo |
| Povratni klici prispejo, vendar starost obdelave narašča | Preglejte delavce, stanje zbirke podatkov in izolirana sporočila | Inženiring aplikacij |
| Pri enem prevozniku so vrzeli v svežini nenavadne | Primerjajte kohorte in vzorčite referenčne zapise sledenja | Operacije sledenja skupaj z inženiringom |
| Shranjeno stanje je aktualno, prikaz pa star | Preglejte predpomnilnike, bralne modele in pridobivanje v uporabniškem vmesniku | Ekipa aplikacije, usmerjene k stranki |
Za zmanjšanje šuma uporabite trajne prekoračitve in minimalne velikosti vzorcev. Pri ciljih razpoložljivosti in obdelave lahko proračun napak pomaga razlikovati kratko anomalijo od napake, ki porabi nesprejemljiv delež dovoljenih napak. Cilje svežine podatkov prevoznikov ločite od ciljev, ki jih vaš inženirski tim neposredno nadzoruje.
Uporabite priročnik za obnovitev, ki dokazuje zaključek
Ko se začne incident, določite zadnjo znano zdravo točko in ohranite ustrezne zapise. Ugotovite, ali so prizadete nove registracije, prihajajoča sporočila, obdelava ali posodobitve prikaza. Nato ocenite populacijo pošiljk v nevarnosti, namesto da poročate samo o številu zahtev.
Obnovite okvarjeno stopnjo, ponovite ali znova pridobite podatke v dokumentiranih omejitvah in izvedite usklajevanje s prizadeto populacijo. Incident zaključite šele, ko se starost zaostanka vrne v normalno stanje, so nerazrešene vrzeli pojasnjene in je stanje, prikazano strankam, preverjeno. Ločeno zabeležite vse zgodovinske posodobitve, ki jih ni mogoče obnoviti.
Ta postopek preizkusite z nadzorovanimi napakami: nedosegljiv prejemnik, napačen tovor, izpad delavca, podvojen dogodek, dogodek izven vrstnega reda in potekla poverilnica. Preizkus je uspešen, ko ekipa zazna težavo, določi njenega lastnika, obnovi podatke in prepreči podvojene stranske učinke, ne zgolj takrat, ko je končna točka znova dosegljiva.
Pogosta vprašanja
Ali lahko API vrne uspešne odgovore, medtem ko so informacije o sledenju zastarele?
Da. Uspeh zahteve potrjuje, da je bila operacija dokončana v skladu s pravili vmesnika. Ne potrjuje, da je prevoznik objavil novo skeniranje ali da je vsak nadaljnji sistem obdelal rezultat. Svežino in obdelavo od začetka do konca spremljajte ločeno.
Kako pogosto naj usklajujemo pošiljke?
Izberite pogostost glede na sprejemljivo zakasnitev zaznavanja, obseg aktivnih pošiljk, proračun zahtev in dokumentirane omejitve. Za operativno občutljive segmente uporabite pogostejša preverjanja, za pokritost pa širši načrtovani pregled. Noben interval ni primeren za vsakega prevoznika in vsak potek dela.
Ali pomanjkanje dejavnosti webhookov pomeni, da je integracija pokvarjena?
Ne. Morda ni novih dogodkov. Dejavnost povratnih klicev primerjajte z aktivno populacijo pošiljk, nedavnimi vzorci, stanjem prejemnika in neodvisnim preverjanjem pridobivanja, kjer je podprto. Opozorilo sprožite na podlagi potrditvenih dokazov, ne zgolj tišine.
Ali naj kot varnostno kopijo neprekinjeno izvajamo poizvedovanje?
Ne privzeto. Nenadzorovano poizvedovanje lahko porabi zmogljivost zahtev, ne da bi izboljšalo vidljivost. Uporabite omejeno usklajevanje in pridobivanje, specifično za incident, znotraj dokumentiranih omejitev. Pri ponudniku preverite, kako medsebojno delujeta poizvedovanje in dostava webhookov.
Kaj naj pošljemo pri eskalaciji domnevne težave pri ponudniku?
Vključite prizadete vrste operacij, časovna obdobja v UTC, anonimizirane ID-je zahtev, kode odgovorov, reprezentativne reference pošiljk prek odobrenega varnega kanala ter pričakovano in opaženo vedenje. Pojasnite, katere interne stopnje ste preverili. Ne vključujte poverilnic ali nepotrebnih podatkov o strankah.
Viri
- Google SRE: Spremljanje porazdeljenih sistemov — štirje zlati signali in načela spremljanja.
- OpenTelemetry: Podatkovni model dnevnikov — razlika med časovnimi žigi dogodkov in opaženimi časovnimi žigi.
- Dokumentacija API-ja za sledenje 17TRACK — izvedbeni vir za integracijo 17TRACK.
- 17TRACK Tracking API — uradni kontekst izdelka.