Guide till tillförlitlighet för Tracking API: Så övervakar du drifttid, dataaktualitet och missade uppdateringar efter Go-Live
Efter produktionssättningen ska du övervaka tracking-API:ets tillförlitlighet på tre separata nivåer: om förfrågningar lyckas, om försändelseinformationen kommer fram inom en acceptabel fördröjning och om uppdateringar når dina egna system utan luckor. Ett lyckat API-svar bevisar inte att trackinginformationen är aktuell eller att en kundavisering har levererats. Ge varje nivå egna mätvärden, aviseringar och återställningsprocedurer.
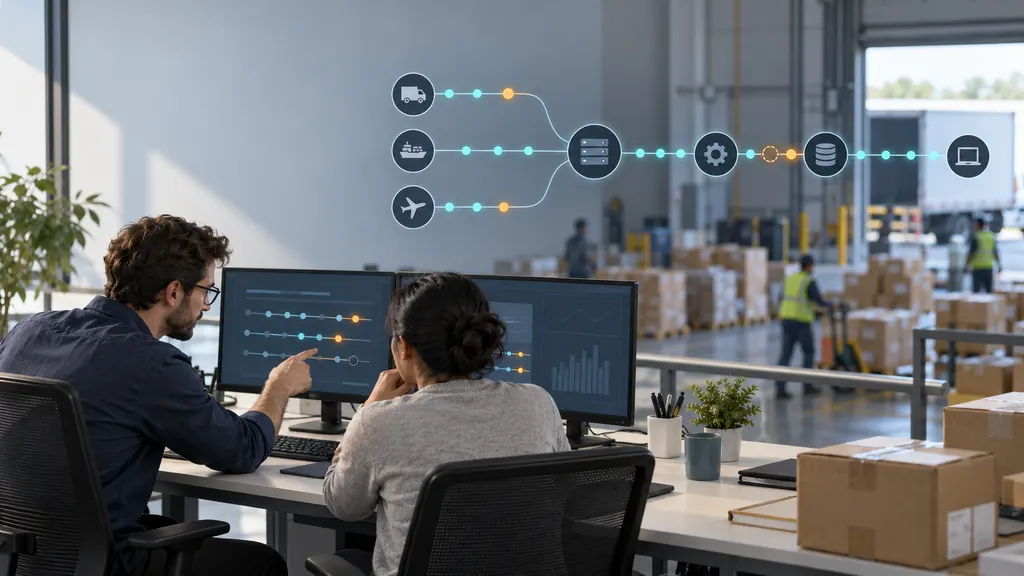
Den här guiden är avsedd för ingenjörer och driftteam som ansvarar för en aktiv integration för spårning av försändelser. Målet är att upptäcka bristande synlighet innan det blir ett supportproblem och därefter fastställa om felet ligger hos en transportörs dataflöde, trackingleverantören, din webhook-mottagare eller efterföljande bearbetning.
Definiera vad en tillförlitlig trackinguppdatering innebär
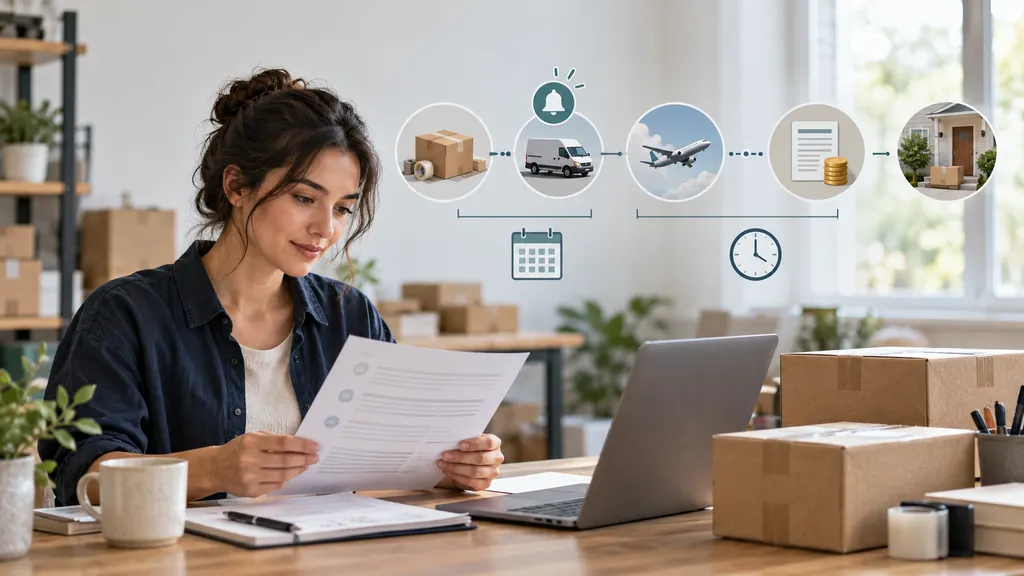
Börja med hela leveransvägen: registrering av försändelsen, hämtning från leverantören, API-svar eller webhook-leverans, intern bearbetning, lagring i databasen och visning för kunden. Om du skickar aviseringar ska du behandla det som ytterligare ett steg i stället för att anta att en sparad uppdatering nådde köparen.
För varje steg ska du registrera ägare och den evidens som bevisar att steget lyckades. Att en leverantör accepterar ett trackingnummer bevisar att registreringen accepterades, inte att en transportör har publicerat en händelse. Att en webhook tar emot ett lyckat HTTP-svar bevisar att din endpoint bekräftade mottagandet, men inte nödvändigtvis att din worker sparade uppdateringen.
Googles SRE-vägledning beskriver latens, trafik, fel och mättnad som övervakningens fyra gyllene signaler. Dessa signaler är användbara för din integrationsinfrastruktur, men tracking av försändelser kräver även kontroller av aktualitet och fullständighet eftersom en till synes frisk endpoint kan leverera oförändrad eller ofullständig information.
| Nivå | Fråga att besvara | Evidens att samla in |
|---|---|---|
| API-tillgänglighet | Kan integrationen slutföra en giltig åtgärd? | Transportresultat, applikationsresultat, latens, timeoutfrekvens |
| Dataaktualitet | Hur långt efter ligger informationen? | Händelsetid, observationstid, mottagningstid, lagringstid |
| Uppdateringarnas fullständighet | Nådde varje förväntad och tillgänglig uppdatering destinationen? | Skillnader vid avstämning, bearbetningsposter, olösta luckor |
| Kundsynlighet | Matchar den visade statusen det lagrade försändelsetillståndet? | Kontroller av läsvägen, cacheålder, resultat från aviseringsbearbetning |
Instrumentera integrationen innan du ställer in aviseringar
Behåll en driftsjournal som kopplar en försändelse till dess registreringsförsök, inkommande uppdateringar, bearbetningsförsök och resulterande tillstånd. Använd en intern försändelseidentifierare för korrelation och håll trackingnummer och kunduppgifter borta från brett åtkomliga loggar där det är möjligt.
Den minsta användbara posten innehåller:
- Internt försändelse-ID, transportörsidentifierare när den är känd, integrationskonto och miljö.
- Förfrågnings- eller korrelations-ID, åtgärdstyp, försö kanal, resultatkategori och varaktighet.
- Leverantörens händelse-ID när det tillhandahålls, samt den ursprungliga händelsetidsstämpeln och tidszonsinformationen.
- Tidpunkt för webhook-mottagning, tidpunkt för varaktig lagring, tidpunkt för slutförd bearbetning och tidpunkt då informationen blev tillgänglig för visning, där det går att mäta.
- Version av payloadens schema när den finns, tolkningsresultat, resultat av deduplicering och felorsak.
Bevara den ursprungliga payloaden under lämpliga åtkomst- och lagringskontroller när den behövs för undersökning eller återuppspelning. Logga inte auktoriseringsheaders eller hemligheter. Använd begränsade dimensioner, till exempel transportör och resultatkategori, för mätvärden; enskilda trackingnummer hör hemma i sökbara poster, inte som högkardinalitets-etiketter i mätvärden.
Håll händelsetid åtskild från observationstid. OpenTelemetrys datamodell för loggar gör denna åtskillnad uttryckligen genom Timestamp och ObservedTimestamp. Om du tillämpar samma åtskillnad på trackingposter minskar risken att en sent rapporterad transportörshändelse misstas för en långsam databasskrivning.
Övervaka drifttid ur applikationens perspektiv
Använd både verklig produktionstrafik och en syntetisk kontroll med låg volym. Produktionstrafik visar den faktiska kundpåverkan. En syntetisk kontroll kan upptäcka fel när produktionstrafiken är låg, förutsatt att den använder en dokumenterad, icke-förstörande åtgärd och respekterar leverantörens användningsgränser.
En användbar indikator för lyckade förfrågningar är:
Lyckade berättigade åtgärder / Alla försöta berättigade åtgärder
Definiera ”lyckad” med både HTTP-status och det dokumenterade resultatet på applikationsnivå. Vissa gränssnitt kan returnera ett lyckat HTTP-svar samtidigt som de rapporterar en misslyckad åtgärd i innehållet. För batchåtgärder ska du mäta resultat på objektnivå såväl som på förfrågningsnivå.
Behåll två vyer över fel. Kundpåverkansvyn omfattar allt som hindrar applikationen från att slutföra sin uppgift. Diagnostikvyn skiljer mellan leverantörsfel, nätverksfel, autentiseringsproblem, ogiltiga indata samt kvot- eller hastighetsbegränsningssvar. Ett utgånget autentiseringsuppgift kanske inte är ett avbrott hos leverantören, men det är fortfarande ett avbrott för din integration.
- Latens: Följ p50, p95 och p99 när trafikvolymen ger meningsfulla percentiler. Mät timeouts separat så att snabba fel inte får latensen att se frisk ut.
- Trafik: Jämför volymen av förfrågningar och callbacks med registreringar av försändelser och populationen av aktiva försändelser.
- Fel: Separera transportfel, applikationsfel, tolkningsfel och fel vid efterföljande lagring.
- Mättnad: Övervaka anslutningspooler, workerkapacitet, ködjup, äldsta köade objekt och tillgänglig förfrågningsbudget.
Presentera inte dessa mätningar som leverantörens avtalsenliga drifttid om de inte använder avtalets exakta definitioner. Din observerade integrationstillgänglighet och en leverantörs servicenivåavtal besvarar olika frågor.
Mät aktualitet utan att förväxla tystnad med fel
En försändelse som inte har rört sig är inte automatiskt inaktuell. Internationell transport, överlämningar, helger och transportörers skanningsrutiner kan skapa legitima luckor. Övervakningsproblemet är att skilja mellan ”inget nytt har hänt” och ”ny information finns, men vårt system har inte tagit emot den”.
Använd separata klockor för separata fördröjningar
- Ålder på senaste händelsen: Aktuell tid minus tiden för den senaste transportörshändelsen. Detta beskriver försändelsens synlighet, inte nödvändigtvis integrationens prestanda.
- Mottagningsfördröjning: Din mottagningstid minus händelsetiden. Detta omfattar fördröjningar i uppströmsrapportering och hämtning när mellanliggande tidsstämplar saknas.
- Intern bearbetningsfördröjning: Tidpunkt för slutförd varaktig bearbetning minus mottagningstid. Detta isolerar arbetet i ditt system.
- Visningsfördröjning: Tidpunkt då informationen blev tillgänglig för kunden minus tidpunkten då bearbetningen slutfördes. Detta kan avslöja problem med cache eller läsmodeller.
- Verifieringsålder: Aktuell tid minus den senaste lyckade kontrollen av nyare information. Detta mäter kontrollaktiviteten, inte att transportörens dataflöde faktiskt är aktuellt.
Beräkna endast leverantörsspecifik inmatningsfördröjning om den nödvändiga leverantörstidsstämpeln finns och dess innebörd är dokumenterad. Utan den kan mottagningsfördröjningen inte rättvist tillskrivas en enskild part.
Normalisera tidsstämplar till en konsekvent tidszon samtidigt som den ursprungliga representationen bevaras. Markera saknad tidszonsinformation, framtidsdaterade händelser och inkonsekventa klockor. Konvertera inte tyst en negativ fördröjning till noll; undersök den eller klassificera den som ett problem med tidsstämpelkvaliteten.
Jämför liknande försändelser
Skapa aktualitetsvyer per transportör, tjänst eller rutt när dessa är kända, försändelsestatus och tid sedan registrering. Separera nyregistrerade försändelser som väntar på sin första händelse från försändelser som redan är under transport. Undanta levererade försändelser från kontroller av aktiv rörelse enligt dina driftsregler, men behåll den övervakning efter leverans som arbetsflödet kräver.
Fastställ inledande trösklar utifrån verksamhetskrav och observerat beteende, inte utifrån ett påhittat universellt uppdateringsintervall. En tröskel som passar lokal leverans kan skapa brus vid en gränsöverskridande överlämning. Omvänt kan ett brett nätverksgenomsnitt dölja ett problem som påverkar en enda transportör.
Märk varje aktualitetspanel med dess täckning. Om händelsetidsstämplar saknas för en del av populationen ska du visa den populationen separat i stället för att få de återstående försändelserna att verka representativa för all trafik.
Hitta missade uppdateringar genom avstämning
Webhook-volymen ensam kan inte fastställa fullständighet. Låg trafik kan vara normalt, och ett lyckat webhook-svar kan dölja ett fel i efterföljande bearbetning. Avstämning jämför vad en referenskälla för närvarande visar med vad ditt system faktiskt har lagrat eller bearbetat.
- Definiera den berättigade populationen. Inkludera registrerade och aktivt övervakade försändelser. Följ avvisade registreringar och pausad övervakning separat så att de inte försvinner ur driftsrapporteringen.
- Välj en referens. När det dokumenterade API:et tillåter det ska du hämta aktuell trackinginformation oberoende av webhook-inmatningen. Transportörers trackingsidor kan hjälpa till att undersöka enskilda fall, men bör inte bli ett automatiserat scraping-beroende utan tillstånd.
- Tillämpa en respitperiod. Tillåt normala leverans- och bearbetningsfördröjningar innan en skillnad klassificeras som en misstänkt lucka.
- Jämför likvärdiga saker. Matcha händelseidentifierare som stöds eller använd en dokumenterad normaliseringsregel för tidsstämplar, statusar, platser och beskrivningar.
- Återställ säkert. Spela upp bevarade meddelanden igen eller hämta tillåtna uppdateringar genom den normala idempotenta bearbetningsvägen.
- Bekräfta destinationen. Kontrollera att databasen och kundvyn är korrigerade, inte bara att ett återställningsjobb kördes.
En intern indikator kan uttryckas som:
Avstämda berättigade försändelser med olösta skillnader / Alla berättigade avstämda försändelser
Kalla detta en frekvens för olösta avstämningsluckor, inte en universell frekvens för missade händelser. Om referensen endast visar det senaste tillståndet kan den inte bevisa att varje historisk händelse kom fram. Även en matchande slutstatus kan dölja en missad mellanliggande milstolpe.
Börja med ett stratifierat urval över transportörer, försändelsernas ålder och statusar. Utöka täckningen för berörda segment under en incident, med hänsyn till dokumenterade gränser. Rapportera både antalet kontrollerade och antalet med skillnader så att ett litet urval inte misstas för fullständig täckning.
Gör webhook-inmatningen återställningsbar
Utforma mottagaren så att den validerar inkommande förfrågningar och varaktigt fångar accepterade meddelanden innan den bekräftar mottagandet, i enlighet med leverantörens dokumenterade leveransavtal. Håll långsammare affärslogik i en separat worker där det är praktiskt.
Verifiera de faktiska integrationsreglerna i stället för att anta dem: autentisering eller signaturvalidering, krav på bekräftelse, timeout för förfrågningar, villkor för återförsök, återförsökens varaktighet, ordning och möjlighet till återuppspelning. Dessa detaljer avgör vilken återställning din applikation måste tillhandahålla.
- Räkna med dubbletter i designen: Använd ett dokumenterat händelse-ID när det finns. Skapa annars en noggrant avgränsad dedupliceringsnyckel och testa den mot legitima liknande händelser.
- Hantera leverans i fel ordning: Bevara händelsehistoriken och använd uttryckliga övergångsregler i stället för att blint ersätta försändelsens tillstånd med det senast mottagna meddelandet.
- Isolera fel: Behåll meddelanden som inte kan bearbetas tillsammans med deras feldetaljer och tillhandahåll en kontrollerad process för ny körning.
- Separera återställning av tillstånd från bieffekter: Att spela upp en händelse igen ska inte automatiskt skicka om ett gammalt leveransmejl eller upprepa någon annan kundåtgärd.
Om din integration använder 17TRACK ska du använda den officiella dokumentationen för Tracking API som implementeringsreferens och kontrollera de krav som gäller för din integration. Produktsidan för Tracking API ger produktkontext, men övervakningströsklar och återställningsantaganden bör hämtas från dokumenterat beteende, ditt serviceavtal och produktionsmätningar – inte från produktbeskrivningar.
Gör instrumentpaneler till handlingsbara aviseringar
Varje avisering bör identifiera den berörda populationen, det sannolika felsteget, verksamhetspåverkan och det första utredningssteget. En global avisering om att ”tracking är inaktuell” ger sällan tillräcklig information för att agera.
| Signalmönster | Första utredning | Huvudansvarig |
|---|---|---|
| Förfrågningar misslyckas hos flera transportörer | Kontrollera autentiseringsuppgifter, nätverk, begränsningar och leverantörssvar | Integration- eller plattformsjour |
| Callbacks kommer fram men bearbetningsåldern ökar | Granska workers, databasens hälsa och isolerade meddelanden | Applikationsutveckling |
| En transportör visar ovanligt stora aktualitetsluckor | Jämför kohorter och kontrollera ett urval av referenstrackingposter | Trackingdrift tillsammans med utveckling |
| Det lagrade tillståndet är aktuellt men visningen är gammal | Granska cacher, läsmodeller och frontend-hämtning | Teamet för den kundvända applikationen |
Använd ihållande överträdelser och minsta urvalsstorlekar för att minska brus. För mål för tillgänglighet och bearbetning kan en felbudget hjälpa till att skilja en kortvarig avvikelse från ett fel som förbrukar en oacceptabel andel av de tillåtna felen. Håll mål för transportörsdata och aktualitet separata från mål som ditt utvecklingsteam direkt kan påverka.
Använd en återställningsrunbook som bevisar att arbetet slutförts
När en incident börjar ska du fastställa den senast kända friska punkten och bevara relevanta poster. Avgör om nya registreringar, inkommande meddelanden, bearbetning eller visningsuppdateringar påverkas. Uppskatta därefter populationen av försändelser som är i riskzonen i stället för att endast rapportera antal förfrågningar.
Återställ det felaktiga steget, spela upp eller hämta information igen inom dokumenterade gränser och kör en avstämning mot den berörda populationen. Stäng incidenten först när backloggens ålder har återgått till det normala, olösta luckor har hanterats och det kundvända tillståndet har kontrollerats. Registrera separat historiska uppdateringar som inte kan återställas.
Testa processen med kontrollerade fel: en otillgänglig mottagare, felaktig payload, avbrott hos en worker, en dubbletthändelse, en händelse i fel ordning och ett utgånget autentiseringsuppgift. Ett test är godkänt när teamet upptäcker problemet, identifierar dess ägare, återställer informationen och undviker dubbla bieffekter – inte bara när endpointen blir nåbar igen.
Vanliga frågor
Kan ett API returnera lyckade svar samtidigt som trackinginformationen är inaktuell?
Ja. Ett lyckat svar på en förfrågan visar att en åtgärd slutfördes enligt gränssnittets regler. Det visar inte att en transportör publicerade en ny skanning eller att alla efterföljande system bearbetade resultatet. Övervaka aktualitet och bearbetning från början till slut separat.
Hur ofta bör vi stämma av försändelser?
Välj intervall utifrån den acceptabla upptäcktsfördröjningen, volymen av aktiva försändelser, förfrågningsbudgeten och dokumenterade begränsningar. Använd tätare kontroller för operativt känsliga segment och en bredare schemalagd genomgång för täckning. Det finns inget enda intervall som passar alla transportörer och arbetsflöden.
Innebär avsaknad av webhook-aktivitet att integrationen är trasig?
Nej. Det kan saknas nya händelser. Jämför callback-aktiviteten med populationen av aktiva försändelser, aktuella mönster, mottagarens hälsa och en oberoende hämtning när detta stöds. Skicka aviseringar baserat på bekräftande evidens, inte enbart på tystnad.
Bör vi polla kontinuerligt som backup?
Inte som standard. Okontrollerad polling kan förbruka förfrågningskapacitet utan att förbättra synligheten. Använd begränsad avstämning och incidentspecifik hämtning inom dokumenterade gränser. Bekräfta hur polling och webhook-leverans samverkar hos din leverantör.
Vad bör vi skicka när vi eskalerar ett misstänkt problem hos leverantören?
Inkludera berörda åtgärdstyper, tidsintervall i UTC, sanerade förfrågnings-ID:n, svarskoder, representativa försändelsereferenser via en godkänd säker kanal samt förväntat jämfört med observerat beteende. Förklara vilka interna steg du har kontrollerat. Inkludera inte autentiseringsuppgifter eller onödiga kunddata.
Källor
- Google SRE: Monitoring Distributed Systems — de fyra gyllene signalerna och övervakningsprinciper.
- OpenTelemetry: Logs Data Model — skillnaden mellan händelsetidsstämplar och observationstidsstämplar.
- 17TRACK-dokumentation för Tracking API — implementeringsreferens för en 17TRACK-integration.
- 17TRACK Tracking API — officiell produktkontext.