Comment les prestataires de services après-vente peuvent gérer le suivi de plusieurs marques avec une seule API
Les prestataires de services post-achat peuvent gérer le suivi de plusieurs marques de commerce électronique via une seule API en séparant la couche partagée de données d’expédition de l’expérience client propre à chaque marque. Le modèle pratique est un service de suivi multi-locataire : une intégration reçoit les demandes et les événements de suivi, tandis que les règles propres à chaque locataire contrôlent l’authentification, l’image de marque, le comportement des transporteurs, les notifications et les rapports. Cette approche réduit la duplication des intégrations, mais elle ne fonctionne correctement que si la propriété des données, l’identité des expéditions, la normalisation des transporteurs et les contrôles opérationnels sont conçus dès le départ.
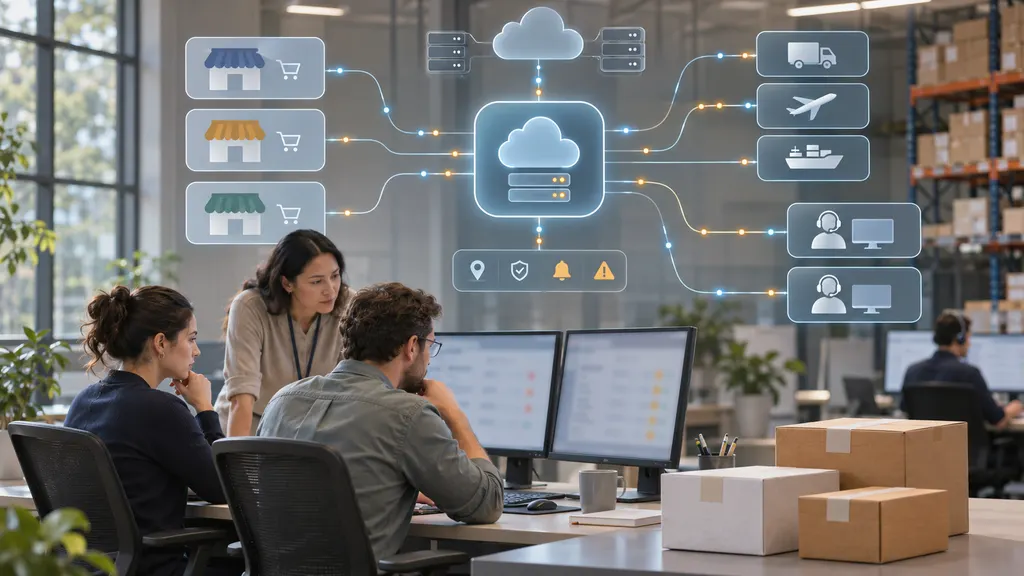
L’objectif n’est pas simplement de placer plusieurs marques derrière un même point de terminaison. Il s’agit de fournir à chaque client un flux de suivi post-achat fiable sans obliger le prestataire de services à créer et maintenir une connexion distincte avec chaque transporteur. Un système bien conçu doit rendre l’infrastructure partagée invisible pour les acheteurs tout en donnant aux opérateurs suffisamment de contrôle pour analyser les exceptions et protéger les limites entre les données.
Que doit signifier « une API » dans un modèle multi-marques ?
Dans ce contexte, une API unique désigne généralement une couche d’intégration gérée par un seul prestataire pour plusieurs marques clientes. Cela ne signifie pas nécessairement que chaque client reçoit la même réponse, la même interface ou le même parcours de notification. L’API peut exposer un contrat commun tout en appliquant des règles propres à chaque locataire en arrière-plan.
Une demande typique peut inclure un identifiant de locataire, une référence d’expédition ou de commande, les informations du transporteur lorsqu’elles sont disponibles, le numéro de suivi, la langue et l’opération demandée. Le service authentifie ensuite l’appelant, détermine quelle marque est propriétaire de l’expédition, envoie ou récupère les données de suivi, normalise le résultat et renvoie une réponse cohérente. La boutique en ligne, le centre d’aide, le portail de commandes ou l’application de service client de la marque peuvent utiliser cette réponse sans devoir comprendre le modèle de données distinct de chaque transporteur.
Ce modèle crée trois limites qui ne doivent pas être confondues :
- Limite d’intégration : la manière dont chaque client se connecte au prestataire.
- Limite des données : les expéditions, événements et références client auxquels chaque client peut accéder.
- Limite de l’expérience : la manière dont chaque marque présente le suivi, les notifications et les options d’assistance à ses acheteurs.
Le fait de maintenir ces limites explicites permet au prestataire de centraliser le travail technique tout en préservant le contrôle au niveau de la marque.
Commencer par un modèle de données tenant-aware
La décision de conception la plus importante concerne la manière dont la plateforme identifie une marque et ses expéditions. Un numéro de suivi seul ne doit pas être considéré comme l’identité commerciale complète d’une expédition. La même référence peut apparaître dans différents systèmes, et les applications clientes peuvent utiliser des numéros de commande, des identifiants d’exécution ou des identifiants de dossier internes en plus des numéros de suivi des transporteurs.
Un modèle plus sûr attribue à chaque marque un ID de locataire stable et stocke les enregistrements d’expédition avec une propriété explicite. Les champs utiles peuvent inclure l’ID du locataire, l’ID de l’expédition, la référence de commande, le numéro de suivi, le code du transporteur, la région de destination lorsque cela est pertinent, le statut actuel, l’historique des événements, l’heure de création, l’heure de la dernière synchronisation et le système source. Le schéma exact varie, mais la propriété doit être appliquée au niveau de l’API et de la base de données, et non pas reposer uniquement sur l’interface client.
La configuration de la marque doit également être séparée des données d’expédition. Un enregistrement de configuration peut contrôler le domaine de la page de suivi, le logo, les langues prises en charge, la formulation des statuts, les préférences de notification, les règles d’escalade et les liens du service client. Cela évite aux opérateurs de recopier la logique propre à chaque marque dans le code de l’application à chaque ajout d’un nouveau client.
Pour les prestataires de services, cette séparation offre un deuxième avantage : une intégration avec un transporteur peut être améliorée une seule fois, puis utilisée par tous les locataires concernés. Toutefois, le code partagé ne doit pas impliquer des autorisations partagées. Une connexion à un transporteur peut être commune, tandis que la visibilité des expéditions reste limitée au locataire qui a soumis ou qui possède l’expédition.
Normaliser les données des transporteurs avant de les exposer aux marques
Le suivi multi-marques devient difficile lorsque chaque transporteur utilise des noms d’événements, une logique de statut, des horodatages et des descriptions d’exception différents. Un transporteur peut signaler qu’un colis circule dans le réseau, tandis qu’un autre utilise un événement de transport ou d’installation plus précis. Transmettre directement ces valeurs brutes à chaque client crée des expériences client incohérentes et complique les rapports.
Une couche de normalisation partagée doit mapper les événements propres à chaque transporteur vers un vocabulaire interne contrôlé. Les catégories courantes peuvent inclure informations reçues, en transit, disponible pour retrait, en cours de livraison, livré, exception de livraison et événements liés au retour. Le modèle interne doit conserver l’événement original du transporteur ainsi que le statut normalisé. L’expérience client peut ainsi rester simple sans supprimer les détails de diagnostic nécessaires aux équipes d’assistance.
La normalisation doit également tenir compte de l’incertitude. Une plateforme doit distinguer un événement de livraison confirmé par le transporteur, une absence temporaire de mises à jour et un état opérationnel déduit. Elle doit éviter de transformer un message ambigu du transporteur en promesse définitive. Si un transporteur fournit une date de livraison estimée, l’API doit l’identifier comme une estimation plutôt que de la présenter comme un rendez-vous garanti.
Un prestataire tel que 17TRACK peut être évalué comme couche partagée de données de suivi lorsque les capacités de transporteurs et d’API requises correspondent au cas d’utilisation du prestataire de services. Ses ressources officielles sur l’API et sa documentation développeur doivent être consultées afin de confirmer les opérations prises en charge, les formats de requête, l’authentification, les limites et les exigences de mise en œuvre avant la planification de la production.
Concevoir le contrat d’API autour des cas d’utilisation opérationnels
Une API multi-marques doit être conçue autour de ce que les systèmes clients doivent faire, et pas seulement autour des données fournies par un transporteur. Au minimum, le contrat doit définir comment un client peut créer ou enregistrer une demande de suivi, récupérer l’état actuel de l’expédition, obtenir l’historique des événements et recevoir des mises à jour lorsque l’état change si la livraison d’événements fait partie du service choisi.
Le contrat doit documenter :
- La manière dont les locataires et les applications s’authentifient.
- Les identifiants requis et ceux qui sont facultatifs.
- La manière dont les codes de transporteur sont fournis, détectés ou corrigés.
- La signification d’une réponse réussie par rapport à une demande acceptée pour un traitement ultérieur.
- La représentation des événements inconnus, retardés, dupliqués ou contradictoires.
- La gestion de la pagination, des nouvelles tentatives, des limites de débit et des erreurs.
- La gestion des signatures de webhook, de la protection contre les rejeux et de l’ordre des événements lorsque des webhooks sont utilisés.
L’idempotence est particulièrement importante. Les clients peuvent réessayer une demande après un délai d’expiration réseau, et la plateforme ne doit pas créer de doublons dans les enregistrements d’expédition simplement parce que la même demande a été envoyée deux fois. Chaque locataire doit également recevoir des identifiants disposant de la portée pratique la plus limitée. L’application d’une marque ne doit pas pouvoir interroger les données d’expédition d’une autre marque en modifiant un identifiant dans une demande.
Séparer la couche de données partagée de l’expérience de marque
Une API unique n’impose pas une page de suivi unique. Un prestataire de services peut utiliser les mêmes données normalisées pour prendre en charge différentes expériences client : une page de statut de commande aux couleurs de la marque, un widget intégré, une console de service client ou des notifications gérées par la plateforme de commerce existante du client.
La couche d’expérience doit déterminer la quantité d’informations à afficher. Une marque haut de gamme peut présenter une chronologie détaillée et un lien d’assistance, tandis qu’un autre client peut préférer une carte de statut compacte. Les deux peuvent utiliser le même modèle d’événements sous-jacent. C’est également à ce niveau que doivent être gérés la langue, l’affichage du fuseau horaire, la terminologie de la marque et les instructions de contact.
Pour les prestataires de commerce électronique, la référence de commande est souvent aussi importante pour l’acheteur que le numéro de suivi. La réponse de l’API doit donc permettre de relier le statut de l’expédition à la bonne commande sans exposer de données personnelles inutiles. Les pages destinées aux clients doivent utiliser le minimum de données nécessaire, et les tableaux de bord opérationnels doivent appliquer un accès basé sur les rôles pour les agents, les responsables de compte et les administrateurs.
Mettre en place une supervision de la plateforme, pas seulement des expéditions
Un service de suivi partagé présente deux problèmes de supervision. Il doit identifier les problèmes au niveau de l’expédition, comme une exception de livraison ou une période inhabituelle sans mise à jour, ainsi que les problèmes au niveau de la plateforme, comme une hausse des erreurs d’API, un traitement retardé des événements ou un connecteur de transporteur qui renvoie des données incomplètes.
Les indicateurs doivent être segmentés par locataire, transporteur, région, point de terminaison et type d’erreur lorsque les données le permettent. Les contrôles opérationnels utiles comprennent le taux de réussite des demandes, la latence des réponses, le délai de traitement des événements, le taux d’événements dupliqués, les échecs d’authentification et le nombre d’enregistrements nécessitant une vérification manuelle. La segmentation est importante, car un indicateur global de la plateforme peut sembler normal alors qu’une marque ou un transporteur rencontre un problème grave.
Créez un processus d’escalade avant le lancement. Définissez qui reçoit une alerte, quelles preuves y sont jointes, comment distinguer un problème de transporteur d’un problème de données client et à quel moment l’équipe du service client doit être informée. Une API partagée doit réduire la fragmentation opérationnelle, et non dissimuler les problèmes derrière un message d’erreur générique unique.
Utiliser un processus d’intégration contrôlé pour chaque marque
L’ajout d’une nouvelle marque doit suivre un processus d’implémentation reproductible. Commencez par cartographier les systèmes de commande, d’exécution et de service client du client. Confirmez les identifiants d’expédition disponibles, les transporteurs utilisés, les régions nécessitant un traitement particulier et si le client souhaite que le prestataire gère les notifications, fournisse uniquement les données ou assure les deux.
- Définir le locataire : créer l’enregistrement de la marque, les identifiants, les rôles, les environnements et les attentes en matière de conservation des données.
- Mapper les identifiants : documenter la relation entre les commandes, les enregistrements d’exécution, les numéros de suivi et les références destinées aux clients.
- Tester les données des transporteurs : utiliser des expéditions représentatives pour les principales destinations et les principaux types de service de la marque.
- Valider les statuts normalisés : comparer les résultats de l’API aux informations de suivi disponibles du transporteur et à la terminologie souhaitée par le client.
- Tester les cas d’échec : inclure les numéros invalides, les scans retardés, les demandes dupliquées, les transporteurs inconnus, les retours et les scénarios d’expédition partielle.
- Effectuer un lancement limité : surveiller le trafic réel pour un groupe contrôlé avant d’activer le service pour l’ensemble des clients.
- Documenter les responsabilités : noter qui approuve la formulation des statuts, gère les escalades d’assistance et examine les changements apportés à la plateforme.
Ce processus donne également au prestataire un moyen concret de déterminer si la conception actuelle à API unique est suffisante. Si un client a besoin d’un transporteur, d’un champ de données, d’un canal de notification ou d’un flux régional que la couche partagée ne peut pas prendre en charge de manière fiable, cette lacune doit être consignée et testée plutôt que masquée par une solution personnalisée.
Modes de défaillance courants à éviter
- Utiliser les noms de marque comme contrôles de sécurité : la configuration d’affichage ne remplace pas l’autorisation du locataire.
- Renvoyer partout les statuts bruts des transporteurs : cela produit un langage client déroutant et des analyses incohérentes.
- Supposer qu’un numéro de suivi correspond à une seule commande : les expéditions fractionnées, les remplacements et les retours peuvent modifier cette relation.
- Ignorer les fuseaux horaires : les horodatages des événements doivent être stockés de manière cohérente et présentés de façon compréhensible pour les utilisateurs.
- Intégrer les notifications au modèle de données central : les préférences de notification doivent être configurables afin que différentes marques puissent utiliser différents canaux et formulations.
- Tester uniquement les livraisons réussies : c’est généralement dans les exceptions et les mises à jour manquantes que les coûts d’assistance apparaissent.
- Promettre une couverture des transporteurs sans vérification : confirmez les exigences actuelles relatives au transporteur, à la région et aux opérations dans la documentation officielle ou au moyen d’une preuve de concept technique.
Un cadre de décision pratique
Une approche à API unique convient particulièrement lorsque plusieurs marques partagent des flux d’expédition globalement similaires, ont besoin de données de transporteurs cohérentes et souhaitent que le prestataire de services assume la maintenance des intégrations. Elle est moins simple lorsque chaque client exige des contrats de données fondamentalement différents, une isolation régionale stricte ou des processus opérationnels propres à chaque transporteur. Ces exigences n’excluent pas automatiquement une plateforme partagée, mais elles accroissent le besoin de configuration, de tests et de limites de service clairement définies.
Avant de choisir un fournisseur d’API, réalisez une preuve de concept à l’aide d’exemples d’expéditions réels mais contrôlés. Testez l’identification des transporteurs, la normalisation des événements, le calendrier des mises à jour, les réponses d’erreur, l’authentification, l’isolation des locataires et la capacité à récupérer les informations nécessaires aux équipes de service client. Consultez les recommandations officielles de 17TRACK relatives au suivi multi-transporteurs et la documentation de l’API, puis confirmez directement toute exigence non résolue. La bonne décision ne dépend pas du nombre de transporteurs mentionnés sur une page marketing, mais de la capacité du fournisseur à prendre en charge les marques, destinations, flux de travail et contrôles que la plateforme devra réellement exploiter.
Lorsqu’elle est bien conçue, une API de suivi unique devient une couche opérationnelle réutilisable plutôt qu’une intégration isolée supplémentaire. Elle offre aux prestataires de services post-achat un moyen cohérent de collecter les mises à jour d’expédition, de préserver les expériences propres à chaque marque et de développer l’intégration de nouveaux clients sans reproduire le même travail lié aux transporteurs pour chaque compte de commerce électronique.
FAQ
Une API peut-elle servir plusieurs marques sans partager leurs données ?
Oui, si l’identité et l’autorisation du locataire sont appliquées dans l’ensemble du système. Chaque demande doit être associée à un locataire autorisé et les requêtes d’expédition doivent être vérifiées par rapport à ce locataire avant le renvoi des données. Des identifiants distincts, un accès basé sur les rôles, des journaux d’audit et des tests d’isolation doivent faire partie de l’implémentation.
Chaque marque doit-elle utiliser la même page de suivi ?
Non. Une API partagée peut fournir des données de suivi normalisées tandis que chaque marque utilise sa propre page, son propre widget, sa propre langue, sa propre terminologie et ses propres liens d’assistance. La séparation de la présentation et de la couche de données facilite la gestion des opérations multi-marques.
Que faut-il tester avant la mise en production ?
Testez les données réelles des transporteurs, les numéros de suivi invalides, les événements retardés, les demandes dupliquées, les expéditions fractionnées, les retours, les transporteurs inconnus, les nouvelles tentatives de webhook le cas échéant et les contrôles d’isolation des locataires. Vérifiez également que les statuts normalisés correspondent au langage que le client souhaite présenter aux acheteurs.
Une API unique élimine-t-elle la nécessité de gérer les différences entre transporteurs ?
Non. Elle centralise une grande partie du travail d’intégration, mais les différences entre transporteurs doivent toujours être surveillées et représentées avec soin. Le prestataire doit conserver les détails utiles des événements bruts tout en exposant un modèle normalisé stable aux applications clientes.
Comment un prestataire doit-il évaluer une API de suivi ?
Évaluez l’API en fonction des marques, transporteurs, régions, exigences d’événements, modèle d’authentification, limites, gestion des erreurs, comportement des mises à jour et processus d’assistance réels du prestataire. Une preuve de concept contrôlée est plus fiable que de supposer qu’une description générale des fonctionnalités couvre tous les flux de travail nécessaires.