Come i fornitori di servizi post-acquisto possono gestire il monitoraggio di più brand con una sola API
I fornitori di servizi post-acquisto possono gestire il monitoraggio per più brand di ecommerce tramite un’unica API, separando il livello condiviso dei dati di spedizione dall’esperienza rivolta ai clienti di ciascun brand. Il modello pratico è un servizio di tracking multi-tenant: una sola integrazione riceve le richieste e gli eventi di tracking, mentre le regole del tenant controllano autenticazione, branding, comportamento dei corrieri, notifiche e reportistica. Questo approccio riduce le integrazioni duplicate, ma funziona bene solo quando la titolarità dei dati, l’identità delle spedizioni, la normalizzazione dei corrieri e i controlli operativi vengono progettati fin dall’inizio.
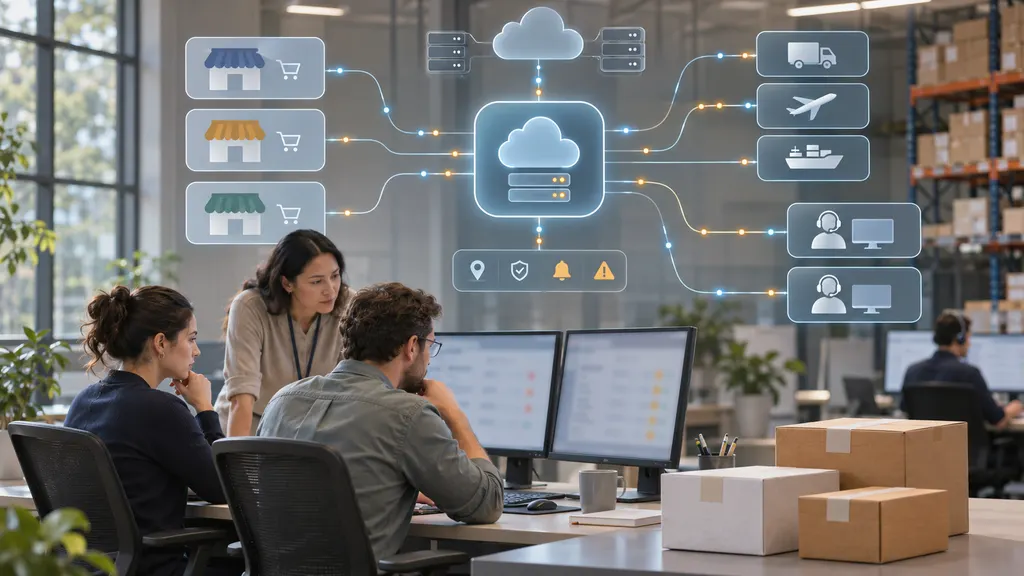
L’obiettivo non è semplicemente collocare diversi brand dietro un unico endpoint. L’obiettivo è offrire a ogni cliente un flusso di lavoro post-tracking affidabile, senza costringere il fornitore di servizi a creare e mantenere una connessione separata con ciascun corriere. Un sistema ben progettato dovrebbe rendere invisibile agli acquirenti l’infrastruttura condivisa, fornendo al contempo agli operatori un controllo sufficiente per investigare le eccezioni e proteggere i confini dei dati.
Soluzione di tracking degli ordini con brand personalizzato — Offri una CX migliore e stimola ulteriori acquisti con tracking personalizzato e notifiche automatizzate. Provala gratisCosa dovrebbe significare “un’unica API” in un modello multi-brand
In questo contesto, un’unica API indica generalmente un unico livello di integrazione gestito dal fornitore per più brand clienti. Ciò non significa necessariamente che ogni cliente riceva la stessa risposta, interfaccia o esperienza di notifica. L’API può esporre un contratto comune applicando al contempo regole specifiche per ciascun tenant.
17TRACK API — Semplifica il tracking globale dei pacchi con aggiornamenti sulle spedizioni da oltre 3.500 corrieri. Scopri di piùUna richiesta tipica può includere un identificativo del tenant, un riferimento alla spedizione o all’ordine, le informazioni sul corriere quando disponibili, il numero di tracking, la lingua e l’operazione richiesta. Il servizio autentica quindi il chiamante, determina quale brand possiede la spedizione, invia o recupera i dati di tracking, normalizza il risultato e restituisce una risposta coerente. Il negozio online, il centro assistenza, il portale degli ordini o l’applicazione del servizio clienti del brand possono utilizzare tale risposta senza dover comprendere il diverso modello di dati di ogni corriere.
17RETURNS — Soluzione per resi e cambi — Riduci i costi del supporto e conserva una quota maggiore dei ricavi con resi e cambi automatizzati, supportati da strumenti intelligenti di fidelizzazione. Provala gratisQuesto modello crea tre confini che non devono essere confusi:
- Confine dell’integrazione: il modo in cui ciascun cliente si connette al fornitore.
- Confine dei dati: quali spedizioni, eventi e riferimenti dei clienti può consultare ciascun cliente.
- Confine dell’esperienza: il modo in cui ogni brand presenta il tracking, le notifiche e le opzioni di assistenza ai propri acquirenti.
Mantenere espliciti questi confini consente al fornitore di centralizzare il lavoro tecnico preservando al contempo il controllo a livello di brand.
Inizia con un modello di dati consapevole del tenant
La decisione progettuale più importante riguarda il modo in cui la piattaforma identifica un brand e le sue spedizioni. Un numero di tracking da solo non dovrebbe essere considerato l’identità commerciale completa di una spedizione. Lo stesso riferimento può comparire in sistemi diversi e le applicazioni dei clienti possono utilizzare numeri d’ordine, ID di evasione o ID interni delle pratiche insieme ai numeri di tracking del corriere.
Un modello più sicuro assegna a ogni brand un tenant ID stabile e memorizza i record delle spedizioni con una titolarità esplicita. I campi utili possono includere tenant ID, shipment ID, riferimento dell’ordine, numero di tracking, codice del corriere, area di destinazione quando appropriato, stato attuale, cronologia degli eventi, ora di creazione, ultima sincronizzazione e sistema di origine. Lo schema esatto può variare, ma la titolarità dovrebbe essere applicata ai livelli API e database, invece di dipendere soltanto dall’interfaccia del cliente.
Anche la configurazione del brand dovrebbe essere separata dai dati della spedizione. Un record di configurazione potrebbe controllare il dominio della pagina di tracking, il logo, le lingue supportate, la terminologia degli stati, le preferenze di notifica, le regole di escalation e i link al servizio clienti. Ciò impedisce agli operatori di copiare la logica specifica del brand nel codice dell’applicazione ogni volta che viene aggiunto un nuovo cliente.
Per i fornitori di servizi, questa separazione offre un secondo vantaggio: un’integrazione con un corriere può essere migliorata una volta sola e poi utilizzata da tutti i tenant idonei. Tuttavia, il codice condiviso non dovrebbe implicare permessi condivisi. La connessione con un corriere può essere comune, mentre la visibilità delle spedizioni deve rimanere limitata al tenant che ha inviato o possiede la spedizione.
Normalizza i dati dei corrieri prima di esporli ai brand
Il tracking multi-brand diventa difficile quando ogni corriere utilizza nomi degli eventi, logiche di stato, timestamp e descrizioni delle eccezioni differenti. Un corriere può segnalare che un pacco sta attraversando la rete, mentre un altro utilizza un evento più specifico relativo al trasporto o a una struttura. Trasmettere direttamente questi valori grezzi a ogni cliente crea esperienze incoerenti e rende difficile la reportistica.
Un livello condiviso di normalizzazione dovrebbe mappare gli eventi specifici dei corrieri in un vocabolario interno controllato. Le categorie comuni possono includere informazioni ricevute, in transito, disponibile per il ritiro, in consegna, consegnato, eccezione di consegna ed eventi relativi al reso. Il modello interno dovrebbe conservare l’evento originale del corriere insieme allo stato normalizzato. In questo modo l’esperienza del cliente rimane semplice senza eliminare i dettagli diagnostici necessari ai team di supporto.
La normalizzazione dovrebbe tenere conto anche dell’incertezza. Una piattaforma deve distinguere tra un evento di consegna confermato dal corriere, una temporanea assenza di aggiornamenti e uno stato operativo dedotto. Dovrebbe evitare di trasformare un messaggio ambiguo del corriere in una promessa definitiva. Se un corriere fornisce una data di consegna stimata, l’API dovrebbe identificarla come stima anziché presentarla come appuntamento garantito.
Un fornitore come 17TRACK può essere valutato come livello condiviso dei dati di tracking quando le capacità richieste relative a corrieri e API corrispondono al caso d’uso del fornitore di servizi. I materiali ufficiali sull’API e la documentazione per sviluppatori dovrebbero essere utilizzati per confermare operazioni supportate, formati delle richieste, autenticazione, limiti e requisiti di implementazione prima della pianificazione in produzione.
Progetta il contratto API attorno ai casi d’uso operativi
Un’API multi-brand dovrebbe essere progettata in base a ciò che i sistemi dei clienti devono fare, non solo in base ai dati forniti da un corriere. Come minimo, il contratto dovrebbe definire come un cliente può creare o registrare una richiesta di tracking, recuperare lo stato attuale della spedizione, ottenere la cronologia degli eventi e ricevere aggiornamenti quando lo stato cambia, se la consegna degli eventi fa parte del servizio selezionato.
Il contratto dovrebbe documentare:
- Come vengono autenticati tenant e applicazioni.
- Quali identificativi sono obbligatori e quali facoltativi.
- Come vengono forniti, rilevati o corretti i codici dei corrieri.
- Cosa significa una risposta positiva rispetto a una richiesta accettata per l’elaborazione successiva.
- Come vengono rappresentati eventi sconosciuti, ritardati, duplicati o in conflitto.
- Come vengono gestiti paginazione, tentativi, limiti di frequenza ed errori.
- Come vengono gestiti firme dei webhook, protezione dal replay e ordine degli eventi, se vengono utilizzati webhook.
L’idempotenza è particolarmente importante. I clienti possono riprovare una richiesta dopo un timeout di rete e la piattaforma non dovrebbe creare record di spedizione duplicati solo perché la stessa richiesta è stata inviata due volte. Ogni tenant dovrebbe inoltre ricevere credenziali con l’ambito pratico più ristretto possibile. L’applicazione di un brand non dovrebbe poter interrogare i dati delle spedizioni di un altro brand modificando un identificativo nella richiesta.
Mantieni separato il livello dati condiviso dall’esperienza del brand
Un’unica API non richiede un’unica pagina di tracking. Un fornitore di servizi può utilizzare gli stessi dati normalizzati per supportare esperienze cliente diverse: una pagina di stato dell’ordine personalizzata, un widget incorporato, una console per il servizio clienti o notifiche gestite dalla piattaforma commerciale già utilizzata dal cliente.
Il livello dell’esperienza dovrebbe decidere quante informazioni mostrare. Un brand premium può visualizzare una timeline dettagliata e un link al supporto, mentre un altro cliente può preferire una scheda di stato compatta. Entrambi possono utilizzare lo stesso modello di eventi sottostante. È inoltre qui che devono essere gestiti lingua, fuso orario, terminologia del brand e istruzioni di contatto.
Per i fornitori di ecommerce, il riferimento dell’ordine è spesso importante per l’acquirente quanto il numero di tracking. La risposta dell’API dovrebbe quindi consentire di collegare lo stato della spedizione all’ordine corretto senza esporre informazioni personali non necessarie. Le pagine rivolte ai clienti dovrebbero utilizzare solo i dati strettamente necessari e i dashboard operativi dovrebbero applicare accessi basati sui ruoli per operatori, account manager e amministratori.
Crea il monitoraggio per la piattaforma, non solo per le spedizioni
Un servizio di tracking condiviso presenta due problemi di monitoraggio. Deve identificare i problemi a livello di spedizione, come un’eccezione di consegna o un periodo insolitamente lungo senza aggiornamenti, e i problemi a livello di piattaforma, come un aumento degli errori API, ritardi nell’elaborazione degli eventi o un connettore del corriere che restituisce dati incompleti.
Le metriche dovrebbero essere segmentate per tenant, corriere, area, endpoint e tipo di errore, quando i dati lo consentono. I controlli operativi utili includono percentuale di successo delle richieste, latenza delle risposte, ritardo nell’elaborazione degli eventi, percentuale di eventi duplicati, errori di autenticazione e numero di record che richiedono una revisione manuale. La segmentazione è importante perché una metrica aggregata della piattaforma può apparire sana mentre un singolo brand o corriere sta affrontando un problema grave.
Crea un percorso di escalation prima del lancio. Definisci chi riceve un avviso, quali evidenze vengono allegate, come distinguere un problema del corriere da un problema nei dati del cliente e quando informare il team del servizio clienti. Un’API condivisa dovrebbe ridurre la frammentazione operativa, non nascondere i problemi dietro un unico messaggio di errore generico.
Utilizza un processo di onboarding controllato per ogni brand
L’aggiunta di un nuovo brand dovrebbe essere un processo di implementazione ripetibile. Inizia mappando i sistemi del cliente relativi a ordini, evasione e servizio clienti. Conferma quali identificativi di spedizione sono disponibili, quali corrieri vengono utilizzati, quali aree richiedono una gestione speciale e se il cliente desidera che il fornitore gestisca le notifiche, fornisca solo i dati o supporti entrambe le attività.
- Definisci il tenant: crea il record del brand, le credenziali, i ruoli, gli ambienti e le aspettative di conservazione dei dati.
- Mappa gli identificativi: documenta la relazione tra ordini, record di evasione, numeri di tracking e riferimenti rivolti ai clienti.
- Testa gli input dei corrieri: utilizza spedizioni rappresentative tra le principali destinazioni e tipologie di servizio del brand.
- Convalida gli stati normalizzati: confronta i risultati dell’API con le informazioni di tracking disponibili del corriere e con la terminologia desiderata dal cliente.
- Testa i casi di errore: includi numeri non validi, scansioni ritardate, richieste duplicate, corrieri sconosciuti, resi e scenari di spedizione parziale.
- Esegui un rilascio limitato: monitora il traffico reale per un gruppo controllato prima di abilitare l’intera base clienti.
- Documenta la titolarità: registra chi approva la terminologia degli stati, gestisce le escalation del supporto e revisiona le modifiche alla piattaforma.
Questo processo offre inoltre al fornitore un modo pratico per decidere se l’attuale progettazione a un’unica API sia sufficiente. Se un cliente richiede un corriere, un campo dati, un canale di notifica o un flusso di lavoro regionale che il livello condiviso non può supportare in modo affidabile, tale lacuna deve essere registrata e testata invece di essere nascosta da una soluzione personalizzata.
Errori comuni da evitare
- Utilizzare i nomi dei brand come controlli di sicurezza: la configurazione visualizzata non sostituisce l’autorizzazione del tenant.
- Restituire ovunque gli stati grezzi dei corrieri: ciò produce un linguaggio confuso per i clienti e analisi incoerenti.
- Presumere che un numero di tracking corrisponda a un solo ordine: spedizioni frazionate, sostituzioni e resi possono modificare la relazione.
- Ignorare i fusi orari: i timestamp degli eventi devono essere memorizzati in modo coerente e presentati in una forma comprensibile agli utenti.
- Integrare le notifiche nel modello dati principale: le preferenze di notifica dovrebbero essere configurabili, così brand diversi possono utilizzare canali e terminologie differenti.
- Testare solo le consegne riuscite: è nelle eccezioni e negli aggiornamenti mancanti che di solito emergono i costi del supporto.
- Promettere la copertura dei corrieri senza verificarla: conferma i requisiti attuali relativi a corriere, area e operazione nella documentazione ufficiale o tramite una prova tecnica di fattibilità.
Un quadro decisionale pratico
Un approccio con un’unica API è particolarmente adatto quando diversi brand condividono flussi di lavoro di spedizione ampiamente simili, necessitano di dati coerenti sui corrieri e desiderano che il fornitore di servizi gestisca la manutenzione delle integrazioni. È meno semplice quando ogni cliente richiede contratti dati fondamentalmente diversi, una rigida separazione regionale o processi operativi specifici per corriere. Tali requisiti non escludono automaticamente una piattaforma condivisa, ma aumentano la necessità di configurazione, test e confini di servizio chiaramente definiti.
Prima di selezionare un fornitore API, esegui una prova di fattibilità utilizzando esempi di spedizioni reali ma controllati. Testa l’identificazione dei corrieri, la normalizzazione degli eventi, la tempistica degli aggiornamenti, le risposte agli errori, l’autenticazione, l’isolamento dei tenant e la possibilità di recuperare le informazioni necessarie ai team del servizio clienti. Consulta le indicazioni ufficiali di 17TRACK sul tracking multi-carrier e la documentazione API, quindi conferma direttamente eventuali requisiti non risolti. La decisione corretta non si basa sul numero di corrieri indicati in una pagina di marketing, ma sulla capacità del fornitore di supportare effettivamente i brand, le destinazioni, i flussi di lavoro e i controlli che la piattaforma dovrà gestire.
Se realizzata correttamente, un’unica API di tracking diventa un livello operativo riutilizzabile invece di un’altra integrazione isolata. Offre ai fornitori di servizi post-acquisto un modo coerente per raccogliere gli aggiornamenti sulle spedizioni, preservare esperienze a livello di brand e ampliare l’onboarding dei clienti senza duplicare lo stesso lavoro sui corrieri per ogni account ecommerce.
FAQ
Un’unica API può servire diversi brand senza condividere i loro dati?
Sì, se l’identità e l’autorizzazione del tenant vengono applicate in tutto il sistema. Ogni richiesta dovrebbe essere associata a un tenant autorizzato e le interrogazioni sulle spedizioni dovrebbero essere verificate rispetto a tale tenant prima di restituire i dati. Credenziali separate, accesso basato sui ruoli, log di audit e test di isolamento dovrebbero fare parte dell’implementazione.
Ogni brand dovrebbe utilizzare la stessa pagina di tracking?
No. Un’API condivisa può fornire dati di tracking normalizzati mentre ogni brand utilizza la propria pagina, il proprio widget, la propria lingua, terminologia e i propri link di supporto. Separare la presentazione dal livello dati rende più semplici da gestire le operazioni multi-brand.
Cosa dovrebbe essere testato prima della produzione?
Testa input reali dei corrieri, numeri di tracking non validi, eventi ritardati, richieste duplicate, spedizioni frazionate, resi, corrieri sconosciuti, tentativi ripetuti dei webhook se applicabile e controlli di isolamento dei tenant. Verifica inoltre che gli stati normalizzati corrispondano al linguaggio che il cliente desidera mostrare agli acquirenti.
Un’unica API elimina la necessità di gestire le differenze tra corrieri?
No. Centralizza gran parte del lavoro di integrazione, ma le differenze tra corrieri devono comunque essere monitorate e rappresentate con attenzione. Il fornitore dovrebbe conservare i dettagli utili degli eventi originali, esponendo al contempo alle applicazioni dei clienti un modello normalizzato stabile.
Come dovrebbe valutare un fornitore un’API di tracking?
Valuta l’API rispetto ai brand, ai corrieri, alle aree, ai requisiti degli eventi, al modello di autenticazione, ai limiti, alla gestione degli errori, al comportamento degli aggiornamenti e al processo di supporto effettivamente utilizzati dal fornitore. Una prova di fattibilità controllata è più affidabile del presupposto che una descrizione generale delle funzionalità copra ogni flusso di lavoro richiesto.