7 maneiras de configurar a frequência das atualizações de rastreamento: dados mais recentes, menos solicitações de API
Configure a frequência das atualizações de rastreamento definindo uma meta de atualização, variando a consulta conforme o status da remessa, usando webhooks quando houver suporte, reconciliando atualizações perdidas, armazenando resultados compartilhados em cache, agrupando tarefas agendadas e aplicando recuo durante erros ou limites de taxa. Para desenvolvedores e equipes de operações, o objetivo não é o menor intervalo possível: é obter alterações úteis da remessa nos seus sistemas sem solicitar repetidamente dados inalterados.
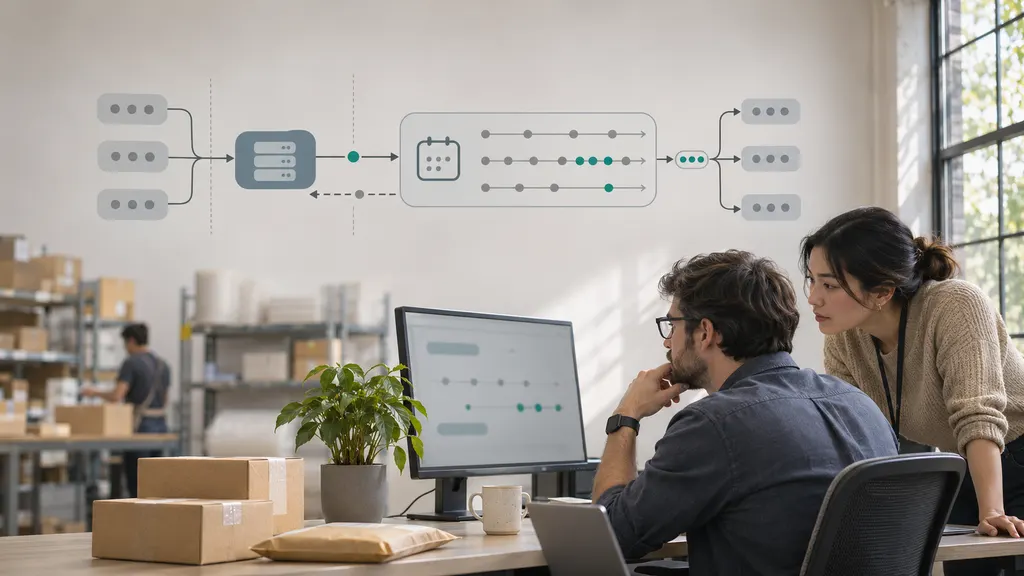
Esses controles geralmente pertencem ao aplicativo que conecta seu provedor de rastreamento a um sistema de gerenciamento de pedidos, uma plataforma de suporte ou uma página de rastreamento voltada ao cliente. Alguns provedores também oferecem seus próprios controles de atualização. Mantenha essas duas camadas separadas: alterar o cronograma de solicitações do seu aplicativo não necessariamente altera a frequência com que um provedor consulta a transportadora.
Primeiro, identifique qual frequência de atualização você pode controlar
Uma atualização da remessa passa por várias etapas antes de ser vista pelo cliente. A transportadora registra um evento, um serviço de rastreamento o obtém, seu aplicativo o recebe ou recupera, e sua interface o exibe. Atrasos em qualquer etapa podem fazer o rastreamento parecer desatualizado.
- Disponibilidade do evento da transportadora: quando a transportadora registra e publica uma leitura ou alteração de status.
- Frequência de atualização do provedor: quando um serviço de rastreamento verifica ou recebe informações da transportadora.
- Frequência de recuperação do aplicativo: quando seu sistema solicita informações ou processa notificações recebidas.
- Frequência de atualização da exibição: quando seu site, aplicativo ou ferramenta de suporte atualiza sua visualização local.
Consultar um provedor com mais frequência pode reduzir o terceiro atraso. Isso não pode garantir uma leitura mais recente da transportadora nem forçar uma atualização upstream, a menos que um endpoint documentado execute explicitamente essa ação. Antes de alterar um cronograma, determine se uma solicitação de API lê dados de rastreamento armazenados, inicia uma atualização ou faz outra coisa.
1. Defina uma meta de atualização antes de escolher um intervalo
Defina com que rapidez cada fluxo de trabalho precisa tomar conhecimento de um evento recém-disponível. Uma fila de exceções de entrega pode justificar uma meta mais rigorosa do que um painel de remessas históricas. Dar a ambos o mesmo intervalo de consulta desperdiça solicitações ou deixa o fluxo mais urgente sem atendimento adequado.
Separe duas medições: o tempo desde sua última recuperação bem-sucedida e a idade do evento mais recente da remessa. Uma solicitação bem-sucedida pode retornar um evento antigo porque nada mudou. Isso é diferente de uma integração com falha que não recupera dados há algum tempo.
Use uma pequena política de configuração em vez de incorporar intervalos em todo o código:
- Objetivo de atualização: o atraso aceitável entre a disponibilidade no provedor e a ingestão pelo aplicativo.
- Intervalo normal de consulta: o intervalo padrão para remessas elegíveis.
- Lacuna máxima de reconciliação: por quanto tempo uma remessa pode ficar sem uma verificação bem-sucedida.
- Orçamento de solicitações: a capacidade disponível após contabilizar novas tentativas, reconciliação e outras operações de API.
Como exemplo de planejamento, verificar 12.000 remessas individualmente a cada hora criaria 288.000 solicitações de consulta programadas por dia antes das novas tentativas. Verificá-las a cada quatro horas criaria 72.000. Esses são cálculos ilustrativos, não limites do provedor nem intervalos recomendados; o agrupamento e a entrega por push alterariam o cálculo.
Escolha o intervalo mais longo que atenda ao objetivo de atualização do fluxo de trabalho e, em seguida, teste se os dados upstream são suficientemente recentes para tornar esse intervalo útil.
2. Altere o intervalo conforme a remessa muda de estado
Um único cronograma ignora o comportamento das remessas. Um pacote aguardando sua primeira leitura, um pacote em uma longa etapa de transporte e um pacote próximo da entrega não necessariamente precisam da mesma atenção.
| Condição da remessa | Abordagem de agendamento sugerida | Medida de proteção |
|---|---|---|
| Aguardando informações iniciais da transportadora | Faça verificações limitadas e aumente o intervalo se não houver alterações. | Não trate apenas a ausência de leituras como prova de falha da remessa. |
| Movimentação normal | Use o intervalo de referência do serviço ou rota correspondente. | Mantenha uma lacuna máxima de reconciliação. |
| Próxima da entrega | Considere intervalos menores quando atualizações oportunas apoiarem uma ação real. | Meça se as solicitações adicionais retornam novas informações. |
| Exceção ou inatividade prolongada | Priorize a investigação e use um cronograma de monitoramento limitado. | Uma consulta mais rápida não resolve a exceção subjacente. |
| Entregue ou concluída de outra forma | Remova da consulta rotineira após suas verificações de encerramento. | Permita correções e reaberturas legítimas. |
Mapeie explicitamente os status do provedor para o ciclo de vida interno. Não presuma que uma remessa devolvida, uma tentativa de entrega malsucedida e uma entrega concluída devam interromper o monitoramento. Elas podem exigir decisões operacionais diferentes.
Armazene um registro de data e hora da próxima verificação elegível para cada remessa e recalcule-o quando chegarem eventos relevantes. Isso torna o agendamento auditável e evita depender de um temporizador que trate todos os registros de forma idêntica.
3. Use webhooks para alterações quando houver suporte do provedor
A consulta pergunta se algo mudou. Um webhook permite que um provedor notifique seu aplicativo quando uma atualização está disponível. Quando houver suporte aos eventos necessários e ao comportamento de entrega, use a entrega por push como caminho principal de ingestão, em vez de consultar repetidamente cada remessa ativa.
Webhooks não eliminam atrasos upstream. Eles também introduzem requisitos de tratamento da entrega. Verifique o mecanismo de autenticação documentado pelo provedor, as regras de confirmação, o comportamento de novas tentativas e os identificadores de eventos antes da implementação.
- Autentique as solicitações recebidas usando o mecanismo documentado.
- Armazene de forma durável ou coloque em fila uma notificação válida antes de confirmar o recebimento bem-sucedido.
- Processe notificações de forma idempotente para que uma entrega repetida não dispare mensagens duplicadas aos clientes.
- Trate eventos atrasados e fora de ordem sem substituir um estado mais recente por informações antigas.
- Monitore falhas de processamento e a idade das notificações enfileiradas.
Não presuma que a entrega de webhooks ocorra exatamente uma vez ou sempre em ordem cronológica, a menos que o provedor garanta isso explicitamente. Mantenha o histórico de eventos da remessa separado de seu status normalizado atual para que informações tardias possam ser avaliadas, em vez de aplicadas cegamente.
4. Adicione uma reconciliação direcionada em vez de um segundo ciclo completo de consultas
Uma integração baseada em webhook ainda precisa de um caminho de recuperação. Seu endpoint pode ficar indisponível, um worker pode falhar após o recebimento ou um erro de mapeamento interno pode impedir que uma atualização chegue ao registro do pedido.
A reconciliação verifica se o estado armazenado corresponde ao estado do provedor. Ela deve se concentrar nos registros que precisam de verificação, não recriar consultas frequentes em toda a população de remessas.
Os candidatos úteis à reconciliação incluem remessas com falha no processamento de notificações, registros que excederam a lacuna máxima de verificação e remessas afetadas por uma indisponibilidade conhecida. Um evento antigo da transportadora, por si só, não é necessariamente evidência de uma atualização perdida.
Após uma indisponibilidade, coloque os registros afetados em fila e processe-os dentro de um orçamento de solicitações controlado. Elimine trabalhos de recuperação sobrepostos e cancele trabalhos redundantes quando uma atualização bem-sucedida já tiver resolvido a discrepância. Evite iniciar uma solicitação simultânea para cada remessa ativa.
Acompanhe separadamente o registro de data e hora da última verificação bem-sucedida e o registro do evento mais recente. Caso contrário, um pacote sem leitura recente poderá se qualificar repetidamente para reconciliação, mesmo que seu sistema tenha acabado de confirmar que o provedor não possui novas informações.
5. Armazene os dados de rastreamento em cache e compartilhe solicitações entre consumidores
Uma página de rastreamento, um painel de suporte, um worker de notificações e um sistema de pedidos podem solicitar a mesma remessa. Forneça a eles um registro compartilhado no aplicativo, em vez de permitir que cada consumidor consulte o provedor de rastreamento de forma independente.
Armazene localmente o estado mais recente conhecido da remessa, junto com o horário de recuperação e os registros de data e hora dos eventos relevantes. Permita que seu agendador ou manipulador de webhook atualize esse registro. Um cliente que atualiza uma página não deve automaticamente forçar outra solicitação upstream.
Use também a consolidação de solicitações: se vários consumidores solicitarem o mesmo registro desatualizado ao mesmo tempo, permita uma única operação de atualização e deixe os demais usarem ou aguardarem seu resultado. Defina corretamente as chaves de cache e as verificações de acesso para que os dados não atravessem limites de contas.
Se um endpoint oferecer validadores HTTP, como ETag ou Last-Modified, as solicitações condicionais poderão reduzir a transferência do corpo da resposta. No entanto, uma solicitação condicional ainda é uma solicitação e ainda pode contar para a cota do provedor. A semântica de cache HTTP é definida em RFC 9111; o suporte a um endpoint específico de rastreamento deve ser verificado separadamente.
Torne a atualização compreensível na interface. “Última verificação” deve descrever a recuperação, enquanto “Último evento da remessa” deve descrever o evento da transportadora. Exibir um registro de data e hora como se representasse ambos pode induzir os clientes ao erro.
6. Agrupe consultas elegíveis e distribua as solicitações ao longo do tempo
Quando o endpoint de consulta relevante oferecer suporte a vários registros de rastreamento por solicitação, o agrupamento poderá reduzir a quantidade de solicitações HTTP. Verifique se a operação necessária oferece suporte a agrupamento: o registro em lote não implica automaticamente recuperação em lote.
Distinga também eficiência de transporte de cobrança. Uma solicitação HTTP contendo vários registros ainda pode consumir várias unidades de cota ou consultas faturáveis, dependendo das regras do provedor.
Um agendador prático deve:
- Selecionar os registros cujo horário da próxima verificação elegível já chegou.
- Excluir registros concluídos, pausados ou já enfileirados.
- Agrupar registros elegíveis dentro dos limites documentados do endpoint e da carga útil.
- Despachar o trabalho por meio de um limitador de taxa compartilhado.
- Registrar o resultado de cada item e repetir apenas os itens com falha ou não resolvidos, quando apropriado.
Distribua o trabalho ao longo da janela de agendamento em vez de executar todos os trabalhos no início da hora. Adicione um deslocamento aleatório limitado, frequentemente chamado de jitter, para reduzir picos sincronizados. Mantenha esse deslocamento pequeno o suficiente para respeitar o objetivo de atualização de cada fluxo de trabalho.
O agrupamento é menos útil quando esperar para preencher um lote atrasaria uma atualização urgente. Permita que o trabalho sensível ao tempo prossiga sem um lote completo, mantendo-o dentro do mesmo orçamento geral de taxa.
7. Adapte-se a limites de taxa, falhas e verificações de baixo valor
Seu intervalo normal de atualização não deve ser também o intervalo de novas tentativas após erros. Um endpoint indisponível precisa de novas tentativas controladas, não de outra onda completa de solicitações programadas sobreposta às falhas.
HTTP 429 significa “Too Many Requests”, e sua resposta pode incluir um campo Retry-After, conforme descrito em RFC 6585. A semântica HTTP do campo é definida em RFC 9110. Siga as instruções aplicáveis do provedor e um valor válido de Retry-After quando fornecido. Caso contrário, use recuo exponencial limitado com jitter para falhas que permitem novas tentativas.
Não repita indefinidamente falhas de autenticação ou entradas de rastreamento inválidas. Encaminhe-as para correção. Para operações que alteram o estado no servidor, confirme a segurança da repetição antes de repetir automaticamente uma solicitação após um tempo limite ambíguo.
Adapte a consulta normal separadamente. Se verificações bem-sucedidas repetidas não retornarem novas informações, considere aumentar o intervalo dentro dos limites de atualização da remessa. Quando um evento relevante mover o pacote para uma etapa mais sensível ao tempo, reduza-o novamente.
Aplique a limitação de taxa a todos os workers que compartilham a cota relevante. Limites independentes por worker podem parecer compatíveis individualmente, enquanto o tráfego combinado excede o limite da conta.
Valide a atualização e a eficiência em conjunto
Teste a política em um grupo controlado de remessas antes de aplicá-la amplamente. Compare fluxos de trabalho com características semelhantes de transportadora, rota e ciclo de vida para que uma alteração na composição das remessas não seja confundida com uma melhoria no agendamento.
- Rendimento de atualizações úteis: a proporção de verificações bem-sucedidas que acrescentam informações relevantes.
- Idade da verificação: tempo desde a última verificação bem-sucedida do estado do provedor.
- Atraso de ingestão: tempo entre a disponibilidade no provedor e o recebimento pelo aplicativo, quando esse horário de disponibilidade for observável.
- Pressão de solicitações: volume de solicitações, respostas de limite de taxa, novas tentativas e profundidade da fila.
- Qualidade da recuperação: alterações perdidas recuperadas por meio da reconciliação e tempo necessário para eliminar falhas.
Não classifique o tempo entre o evento da transportadora e a ingestão como puro atraso de integração. Ele pode incluir atrasos de publicação e coleta upstream que seu aplicativo não pode controlar diretamente. Uma política bem-sucedida reduz a recuperação desnecessária enquanto mantém as alterações operacionalmente importantes dentro de suas metas de atualização definidas.
FAQ
Qual é o melhor intervalo de consulta para o rastreamento de remessas?
Não existe um intervalo universal. Escolha-o com base na meta de atualização do fluxo de trabalho, no comportamento das atualizações upstream, nos limites da API e no orçamento de solicitações. Comece com uma referência documentada, meça o valor das verificações bem-sucedidas e ajuste por estado do ciclo de vida, em vez de fazer todas as remessas consultarem mais rapidamente.
Atualizar uma página de rastreamento força uma nova verificação da transportadora?
Não necessariamente. A página pode ler o cache do seu aplicativo ou os dados de rastreamento armazenados pelo provedor. A atualização do navegador, uma consulta à API e uma atualização upstream da transportadora são operações distintas. Só descreva uma atualização como sendo em tempo real se o comportamento documentado sustentar essa afirmação.
Os webhooks podem substituir completamente as consultas?
Eles podem substituir grande parte das consultas rotineiras quando o provedor oferece suporte às atualizações necessárias. Mantenha um processo de reconciliação limitado para falhas e estados incertos. A quantidade de verificações que continua sendo necessária depende das garantias de entrega, das opções de recuperação e das consequências de uma atualização perdida.
Quando as solicitações de rastreamento devem parar após a entrega?
Remova as remessas entregues da consulta ativa rotineira após concluir suas verificações de encerramento. Decida se um período limitado de verificação é justificado pelo seu fluxo de trabalho e pelo comportamento do provedor. Preserve a capacidade de processar correções sem deixar todas as remessas concluídas em um cronograma indefinido.
Menos solicitações HTTP sempre reduzirão as cobranças da API?
Não. A cobrança pode depender de remessas, registros de rastreamento, operações ou outra unidade contratual, e não da quantidade de solicitações HTTP. Confirme as regras de medição aplicáveis antes de atribuir economia financeira ao agrupamento, ao cache ou à adoção de webhooks.
Fontes
- Visão geral da API de rastreamento 17TRACK — ponto de entrada oficial para avaliar a integração de rastreamento.
- Documentação da API 17TRACK — referência para verificar operações compatíveis e requisitos de integração antes de configurar o agendamento no aplicativo.
- RFC 9110: Semântica HTTP — semântica de métodos HTTP, solicitações condicionais e Retry-After.
- RFC 9111: Cache HTTP — comportamento do cache e validação de respostas.
- RFC 6585: Códigos de status HTTP adicionais — definição da resposta 429 Too Many Requests.