7 способів налаштувати частоту оновлення відстеження: свіжіші дані, менше API-запитів
Налаштовуйте частоту оновлення відстеження, встановлюючи цільову свіжість даних, змінюючи частоту опитування залежно від статусу відправлення, використовуючи вебхуки там, де вони підтримуються, узгоджуючи пропущені оновлення, кешуючи спільні результати, об’єднуючи заплановані завдання та застосовуючи відкладені повторні спроби під час помилок або обмежень частоти. Для розробників і операційних команд мета полягає не в найкоротшому можливому інтервалі, а в тому, щоб передавати корисні зміни щодо відправлень у ваші системи без повторного запитування незмінених даних.
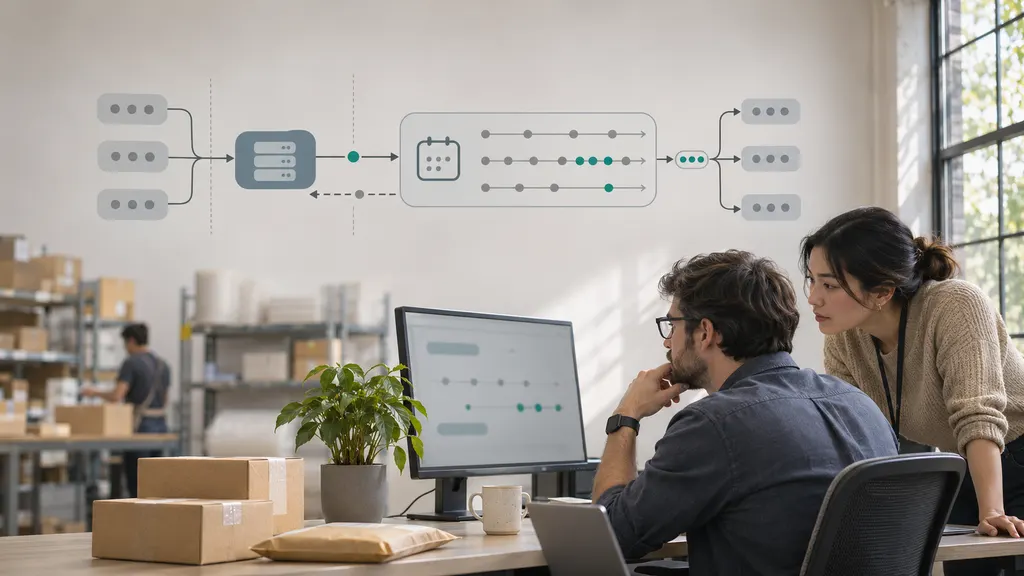
Зазвичай ці елементи керування належать застосунку, який підключає вашого постачальника відстеження до системи керування замовленнями, платформи підтримки або сторінки відстеження для клієнтів. Деякі постачальники також пропонують власні елементи керування оновленням. Тримайте ці два рівні окремо: зміна розкладу запитів вашого застосунку не обов’язково змінює частоту, з якою постачальник перевіряє перевізника.
Спочатку визначте, якою частотою оновлення ви можете керувати
Оновлення відправлення проходить кілька етапів, перш ніж його побачить клієнт. Перевізник записує подію, сервіс відстеження отримує її, ваш застосунок отримує або витягує її, а інтерфейс відображає її. Затримки на будь-якому етапі можуть створити враження, що дані відстеження застаріли.
- Доступність події у перевізника: коли перевізник записує та публікує сканування або зміну статусу.
- Частота оновлення постачальника: коли сервіс відстеження перевіряє або отримує інформацію від перевізника.
- Частота отримання даних застосунком: коли ваша система запитує інформацію або обробляє вхідні сповіщення.
- Частота оновлення відображення: коли ваш вебсайт, застосунок або інструмент підтримки оновлює локальне представлення.
Частіше опитування постачальника може зменшити третю затримку. Воно не гарантує новішого сканування перевізника й не може примусово запустити оновлення на стороні джерела, якщо документований endpoint явно не виконує таку дію. Перед зміною розкладу визначте, чи API-запит читає збережені дані відстеження, ініціює оновлення або виконує іншу дію.
Для інтеграції з 17TRACK почніть з огляду Tracking API та офіційної документації API. Перевірте поведінку операцій, які плануєте використовувати, зокрема доставку оновлень, обмеження запитів і доступні елементи керування оновленням. Наведені нижче схеми планування є рекомендаціями для рівня застосунку, а не твердженням, що кожен інтервал можна налаштувати в 17TRACK.
1. Встановіть цільову свіжість даних перед вибором інтервалу
Визначте, наскільки швидко кожному бізнес-процесу потрібно дізнаватися про щойно доступну подію. Черга винятків доставки може потребувати жорсткішої цілі, ніж історична панель відправлень. Однаковий інтервал опитування для обох процесів марнує запити або залишає важливіший процес без належної підтримки.
Розділяйте два показники: час від останнього успішного отримання даних і вік останньої події відправлення. Успішний запит може повернути стару подію, оскільки нічого не змінилося. Це відрізняється від помилки інтеграції, через яку дані давно не отримувалися.
Використовуйте невелику політику конфігурації, а не вбудовуйте інтервали в різні частини коду:
- Мета свіжості: прийнятна затримка між доступністю даних у постачальника та їх надходженням у застосунок.
- Звичайний інтервал опитування: стандартний інтервал для відповідних відправлень.
- Максимальний інтервал узгодження: як довго відправлення може залишатися без успішної перевірки.
- Бюджет запитів: доступна пропускна здатність після врахування повторних спроб, узгодження та інших операцій API.
Для прикладу планування: перевірка 12 000 відправлень окремо щогодини створить 288 000 запланованих запитів на добу без урахування повторних спроб. Перевірка кожні чотири години створить 72 000 запитів. Це лише ілюстративні розрахунки, а не обмеження постачальника чи рекомендовані інтервали; пакетна обробка та push-доставка змінили б цей розрахунок.
Оберіть найдовший інтервал, який відповідає цілі свіжості процесу, а потім перевірте, чи достатньо свіжі дані на стороні джерела, щоб цей інтервал був корисним.
2. Змінюйте інтервал у міру зміни стану відправлення
Єдиний розклад ігнорує особливості поведінки відправлень. Посилка, яка очікує першого сканування, посилка на тривалому етапі транспортування та посилка, що наближається до доставки, не обов’язково потребують однакової уваги.
| Стан відправлення | Рекомендований підхід до планування | Обмеження |
|---|---|---|
| Очікування початкової інформації перевізника | Виконуйте обмежені перевірки, а потім збільшуйте інтервал, якщо нічого не змінилося. | Не вважайте саму відсутність сканувань доказом проблеми з відправленням. |
| Звичайне переміщення | Використовуйте базовий інтервал для відповідної служби або маршруту. | Зберігайте максимальний інтервал узгодження. |
| Наближення доставки | Розгляньте коротші інтервали, якщо своєчасні оновлення підтримують реальну дію. | Вимірюйте, чи повертають додаткові запити нову інформацію. |
| Виняток або тривала бездіяльність | Пріоритезуйте розслідування та використовуйте обмежений розклад моніторингу. | Швидше опитування не усуває основну проблему. |
| Доставлено або іншим чином завершено | Після перевірок закриття вилучіть відправлення зі звичайного опитування. | Передбачте виправлення та законне повторне відкриття. |
Явно зіставляйте статуси постачальника з внутрішнім життєвим циклом. Не припускайте, що повернене відправлення, невдала спроба доставки та завершена доставка мають припиняти моніторинг. Вони можуть вимагати різних операційних рішень.
Зберігайте для кожного відправлення часову позначку наступної доступної перевірки та перераховуйте її, коли надходять важливі події. Це робить планування контрольованим і не дозволяє таймеру обробляти всі записи однаково.
3. Використовуйте вебхуки для змін, якщо постачальник їх підтримує
Опитування запитує, чи щось змінилося. Вебхук дозволяє постачальнику повідомити ваш застосунок, коли доступне оновлення. Якщо необхідні події та поведінка доставки підтримуються, використовуйте push-доставку як основний шлях отримання даних, а не запитуйте кожне активне відправлення знову й знову.
Вебхуки не усувають затримки на стороні джерела. Вони також створюють вимоги до обробки доставки. Перед реалізацією перевірте документований механізм автентифікації постачальника, правила підтвердження, поведінку повторних спроб та ідентифікатори подій.
- Автентифікуйте вхідні запити за допомогою документованого механізму.
- Надійно зберігайте або додавайте дійсне сповіщення до черги до підтвердження успішного отримання.
- Обробляйте сповіщення ідемпотентно, щоб повторна доставка не надсилала клієнтам дублікати повідомлень.
- Обробляйте затримані події та події не за порядком, не замінюючи новіший стан старішою інформацією.
- Відстежуйте помилки обробки та вік сповіщень у черзі.
Не припускайте, що вебхуки доставляються рівно один раз або завжди в хронологічному порядку, якщо постачальник прямо цього не гарантує. Зберігайте історію подій відправлення окремо від його поточного нормалізованого статусу, щоб пізню інформацію можна було оцінити, а не застосувати без перевірки.
4. Додайте цільове узгодження замість другого повного циклу опитування
Інтеграції на основі вебхуків усе одно потрібен шлях відновлення. Ваш endpoint може бути недоступним, worker може завершити роботу після отримання, або внутрішня помилка зіставлення може не дозволити оновленню потрапити до запису замовлення.
Узгодження перевіряє, чи відповідає збережений стан стану постачальника. Воно має зосереджуватися на записах, які потребують перевірки, а не відтворювати часте опитування всієї сукупності відправлень.
Корисними кандидатами для узгодження є відправлення з невдалою обробкою сповіщень, записи, що перевищили максимальний інтервал перевірки, та відправлення, на які вплинула відома аварія. Стара подія перевізника сама по собі не обов’язково свідчить про пропущене оновлення.
Після аварії додайте відповідні записи до черги та обробіть їх у межах контрольованого бюджету запитів. Усувайте дублікати перехресних завдань відновлення та скасовуйте зайву роботу, якщо успішне оновлення вже усунуло розбіжність. Не запускайте одночасний запит для кожного активного відправлення.
Відстежуйте часову позначку останньої успішної перевірки окремо від часової позначки останньої події. Інакше посилка без недавнього сканування може постійно відповідати критеріям узгодження, навіть якщо ваша система щойно підтвердила, що нової інформації у постачальника немає.
5. Кешуйте дані відстеження та спільно використовуйте запити
Сторінка відстеження, панель підтримки, worker сповіщень і система замовлень можуть запитувати одне й те саме відправлення. Надайте їм спільний запис застосунку, а не дозволяйте кожному споживачу окремо запитувати постачальника відстеження.
Зберігайте локально останній відомий стан відправлення разом із часом його отримання та відповідними часовими позначками подій. Дозвольте планувальнику або обробнику вебхуків оновлювати цей запис. Оновлення сторінки клієнтом не повинно автоматично спричиняти новий запит до джерела.
Використовуйте не лише кешування, а й об’єднання запитів: якщо кілька споживачів одночасно запитують той самий застарілий запис, дозвольте одну операцію оновлення, а іншим використати її результат або дочекатися його. Правильно визначайте ключі кешу та перевірки доступу, щоб дані не перетинали межі облікових записів.
Якщо endpoint підтримує HTTP-валідатори, такі як ETag або Last-Modified, умовні запити можуть зменшити передавання тіла відповіді. Однак умовний запит усе одно є запитом і може враховуватися в квоті постачальника. Семантику HTTP-кешування визначено в RFC 9111; підтримку конкретним endpoint відстеження потрібно перевіряти окремо.
Зробіть свіжість зрозумілою в інтерфейсі. «Остання перевірка» має описувати отримання даних, тоді як «Остання подія відправлення» має описувати подію перевізника. Відображення однієї часової позначки так, ніби вона означає обидва показники, може вводити клієнтів в оману.
6. Об’єднуйте відповідні запити та розподіляйте їх у часі
Якщо відповідний endpoint підтримує кілька записів відстеження в одному запиті, пакетна обробка може зменшити кількість HTTP-запитів. Перевірте, чи підтримує потрібна операція пакетну обробку: пакетна реєстрація не означає автоматичної підтримки пакетного отримання.
Також розрізняйте транспортну ефективність і тарифікацію. Один HTTP-запит із кількома записами все одно може споживати кілька одиниць квоти або оплачуваних перевірок, залежно від правил постачальника.
Практичний планувальник має:
- Вибирати записи, для яких настав час наступної доступної перевірки.
- Виключати завершені, призупинені або вже додані до черги записи.
- Групувати відповідні записи в межах задокументованих обмежень endpoint і розміру даних.
- Передавати роботу через спільний обмежувач частоти.
- Записувати результат для кожного елемента та повторювати лише невдалі або невирішені операції, якщо це доречно.
Розподіляйте роботу протягом вікна планування, а не запускайте всі завдання на початку години. Додавайте обмежене випадкове зміщення, яке часто називають jitter, щоб зменшити синхронізовані сплески. Зміщення має бути достатньо малим, щоб відповідати цілі свіжості кожного процесу.
Пакетна обробка менш корисна, якщо очікування заповнення пакета затримує термінове оновлення. Дозвольте чутливій до часу роботі виконуватися без повного пакета, але в межах загального бюджету частоти.
7. Адаптуйтеся до обмежень частоти, помилок і перевірок із низькою цінністю
Ваш звичайний інтервал оновлення не має бути одночасно інтервалом повторної спроби після помилки. Недоступний endpoint потребує контрольованих повторних спроб, а не ще однієї повної хвилі запланованих запитів поверх помилок.
HTTP 429 означає «Too Many Requests», а відповідь може містити поле Retry-After, як описано в RFC 6585. Семантику цього поля в HTTP визначено в RFC 9110. Дотримуйтеся відповідних інструкцій постачальника та дійсного значення Retry-After, якщо його надано. В іншому разі використовуйте обмежене експоненційне збільшення інтервалу з jitter для помилок, які допускають повторну спробу.
Не повторюйте безкінечно запити з помилками автентифікації або недійсними даними відстеження. Передавайте їх на виправлення. Для операцій, що змінюють стан на сервері, перевірте безпеку повторення перед автоматичним повторним виконанням запиту після неоднозначного тайм-ауту.
Звичайне опитування адаптуйте окремо. Якщо повторні успішні перевірки не повертають нової інформації, розгляньте збільшення інтервалу в межах допустимої свіжості відправлення. Коли важлива подія переводить посилку на більш чутливий до часу етап, знову скоротіть інтервал.
Застосовуйте обмеження частоти до всіх worker, які спільно використовують відповідну квоту. Незалежні обмеження worker можуть окремо виглядати допустимими, хоча їхній сумарний трафік перевищує ліміт облікового запису.
Перевіряйте свіжість та ефективність одночасно
Перевірте політику на контрольованій групі відправлень, перш ніж застосовувати її ширше. Порівнюйте процеси зі схожими перевізниками, маршрутами та характеристиками життєвого циклу, щоб зміна складу відправлень не виглядала як покращення планування.
- Частка корисних оновлень: частка успішних перевірок, які додають важливу інформацію.
- Вік перевірки: час від останньої успішної перевірки стану постачальника.
- Затримка отримання: час від доступності даних у постачальника до їх отримання застосунком, якщо час доступності можна визначити.
- Навантаження запитами: обсяг запитів, відповіді з обмеженням частоти, повторні спроби та глибина черги.
- Якість відновлення: пропущені зміни, відновлені через узгодження, і час, необхідний для усунення помилок.
Не називайте час від події перевізника до отримання застосунком суто затримкою інтеграції. Він може містити затримки публікації та збору даних на стороні джерела, якими ваш застосунок безпосередньо не керує. Успішна політика зменшує непотрібне отримання даних, водночас утримуючи важливі для роботи зміни в межах визначених цілей свіжості.
FAQ
Який найкращий інтервал опитування для відстеження відправлень?
Універсального інтервалу не існує. Вибирайте його на основі цілі свіжості процесу, поведінки оновлень на стороні джерела, обмежень API та бюджету запитів. Почніть із задокументованої базової величини, вимірюйте цінність успішних перевірок і змінюйте інтервал відповідно до стану життєвого циклу, а не прискорюйте опитування всіх відправлень.
Чи примусове оновлення сторінки відстеження запускає нову перевірку перевізника?
Не обов’язково. Сторінка може читати кеш вашого застосунку або збережені дані відстеження постачальника. Оновлення браузера, пошук через API та оновлення даних у перевізника — це різні операції. Називайте оновлення актуальним лише тоді, коли це підтверджується документованою поведінкою.
Чи можуть вебхуки повністю замінити опитування?
Вони можуть замінити значну частину звичайного опитування, якщо постачальник підтримує необхідні оновлення. Зберігайте обмежений процес узгодження для помилок і невизначеного стану. Обсяг перевірок, що залишаються необхідними, залежить від гарантій доставки, можливостей відновлення та наслідків пропущеного оновлення.
Коли потрібно припиняти запити щодо відстеження після доставки?
Після завершення перевірок закриття вилучіть доставлені відправлення зі звичайного активного опитування. Визначте, чи виправданий обмежений період перевірки з огляду на ваш процес і поведінку постачальника. Збережіть можливість обробляти виправлення, не залишаючи кожне завершене відправлення в безстроковому розкладі.
Чи завжди менша кількість HTTP-запитів зменшує плату за API?
Ні. Тарифікація може залежати від відправлень, записів відстеження, операцій або іншої договірної одиниці, а не від кількості HTTP-запитів. Перш ніж приписувати пакетній обробці, кешуванню або використанню вебхуків фінансову економію, підтвердьте застосовні правила обліку.
Джерела
- Огляд 17TRACK Tracking API — офіційна точка входу для оцінювання інтеграції відстеження.
- Документація 17TRACK API — довідка для перевірки підтримуваних операцій і вимог до інтеграції перед налаштуванням планування на рівні застосунку.
- RFC 9110: HTTP Semantics — семантика методів HTTP, умовні запити та Retry-After.
- RFC 9111: HTTP Caching — поведінка кешу та перевірка відповідей.
- RFC 6585: Additional HTTP Status Codes — визначення відповіді 429 Too Many Requests.