7 modi per configurare la frequenza di aggiornamento del monitoraggio: dati più aggiornati, meno richieste API
Configura la frequenza degli aggiornamenti del tracciamento impostando un obiettivo di aggiornamento, variando il polling in base allo stato della spedizione, utilizzando i webhook quando supportati, riconciliando gli aggiornamenti mancanti, memorizzando nella cache i risultati condivisi, raggruppando le attività pianificate e aumentando gradualmente gli intervalli durante errori o limiti di frequenza. Per gli sviluppatori e i team operativi, l'obiettivo non è ottenere l'intervallo più breve possibile: è trasferire nei propri sistemi informazioni utili sulle modifiche alle spedizioni senza richiedere ripetutamente dati invariati.
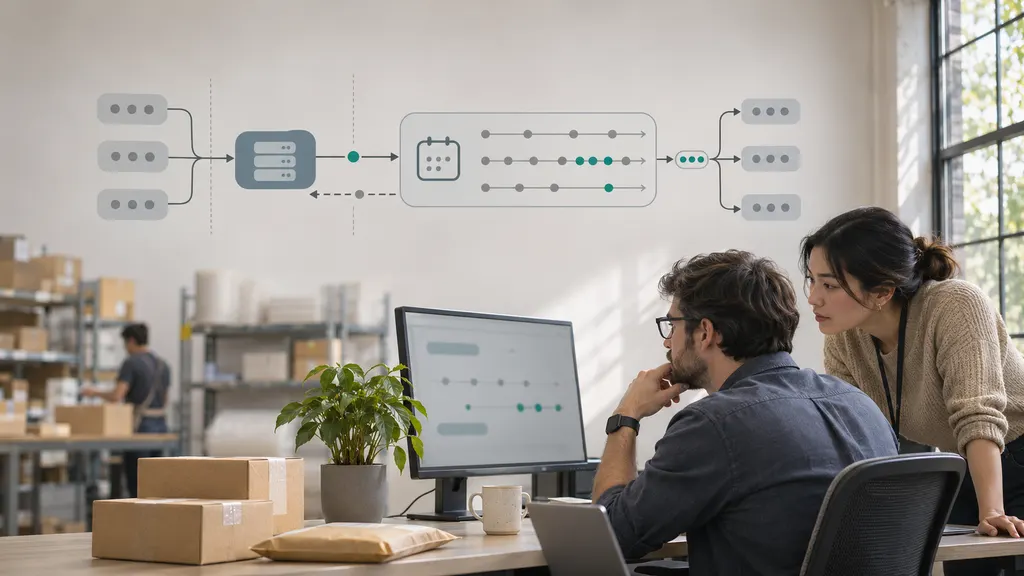
Questi controlli appartengono generalmente all'applicazione che collega il provider di tracciamento a un sistema di gestione degli ordini, a una piattaforma di assistenza o a una pagina di tracciamento destinata ai clienti. Alcuni provider offrono anche propri controlli di aggiornamento. Mantieni separati questi due livelli: modificare la pianificazione delle richieste della tua applicazione non cambia necessariamente la frequenza con cui un provider controlla il corriere.
Innanzitutto, individua quale frequenza di aggiornamento puoi controllare
Un aggiornamento della spedizione attraversa diverse fasi prima di essere visualizzato dal cliente. Il corriere registra un evento, un servizio di tracciamento lo acquisisce, la tua applicazione lo riceve o lo recupera e la tua interfaccia lo visualizza. I ritardi in qualsiasi fase possono far apparire il tracciamento non aggiornato.
- Disponibilità dell'evento del corriere: quando il corriere registra e pubblica una scansione o una modifica dello stato.
- Frequenza di aggiornamento del provider: quando un servizio di tracciamento controlla o riceve informazioni dal corriere.
- Frequenza di recupero dell'applicazione: quando il sistema richiede informazioni o elabora le notifiche in arrivo.
- Frequenza di aggiornamento della visualizzazione: quando il sito web, l'app o lo strumento di assistenza aggiorna la propria visualizzazione locale.
Interrogare un provider più frequentemente può ridurre il terzo ritardo. Non può garantire una scansione più recente del corriere né forzare un aggiornamento a monte, a meno che un endpoint documentato non esegua esplicitamente tale azione. Prima di modificare una pianificazione, stabilisci se una richiesta API legge dati di tracciamento memorizzati, avvia un aggiornamento o svolge un'altra funzione.
Per un'integrazione con 17TRACK, inizia dalla panoramica dell'API di tracciamento e dalla documentazione API ufficiale. Verifica il comportamento delle operazioni che intendi utilizzare, inclusi la consegna degli aggiornamenti, i limiti delle richieste e gli eventuali controlli di aggiornamento. I modelli di pianificazione riportati di seguito sono raccomandazioni lato applicazione e non affermano che ogni intervallo sia un'impostazione configurabile di 17TRACK.
1. Imposta un obiettivo di aggiornamento prima di scegliere un intervallo
Definisci con quale rapidità ogni flusso di lavoro aziendale deve venire a conoscenza di un evento appena disponibile. Una coda per le eccezioni di consegna può giustificare un obiettivo più stringente rispetto a una dashboard storica delle spedizioni. Assegnare a entrambi lo stesso intervallo di polling spreca richieste o lascia il flusso più urgente senza un servizio adeguato.
Separa due misurazioni: il tempo trascorso dall'ultimo recupero riuscito e l'età dell'ultimo evento della spedizione. Una richiesta riuscita può restituire un evento vecchio perché non è cambiato nulla. Questo è diverso da un'integrazione non riuscita che non ha recuperato dati di recente.
Utilizza una piccola policy di configurazione invece di incorporare gli intervalli in tutto il codice:
- Obiettivo di aggiornamento: il ritardo accettabile tra la disponibilità presso il provider e l'acquisizione da parte dell'applicazione.
- Intervallo di polling normale: l'intervallo predefinito per le spedizioni idonee.
- Intervallo massimo di riconciliazione: per quanto tempo una spedizione può rimanere senza una verifica riuscita.
- Budget delle richieste: la capacità disponibile dopo aver considerato nuovi tentativi, riconciliazione e altre operazioni API.
Come esempio di pianificazione, controllare individualmente 12.000 spedizioni ogni ora genererebbe 288.000 richieste di consultazione pianificate al giorno, prima dei nuovi tentativi. Controllarle ogni quattro ore ne genererebbe 72.000. Si tratta di calcoli illustrativi, non di limiti del provider né di intervalli consigliati; il raggruppamento e la consegna push cambierebbero il calcolo.
Scegli l'intervallo più lungo che soddisfa l'obiettivo di aggiornamento del flusso di lavoro, quindi verifica se i dati a monte sono sufficientemente aggiornati da rendere utile tale intervallo.
2. Modifica l'intervallo quando cambia lo stato della spedizione
Una pianificazione unica ignora il comportamento delle spedizioni. Un pacco in attesa della prima scansione, uno che attraversa una lunga tratta di trasporto e uno prossimo alla consegna non necessitano necessariamente della stessa attenzione.
| Condizione della spedizione | Approccio di pianificazione suggerito | Vincolo di sicurezza |
|---|---|---|
| In attesa delle informazioni iniziali del corriere | Effettua controlli limitati, poi aumenta l'intervallo se non cambia nulla. | Non considerare la sola assenza di scansioni come prova del fallimento della spedizione. |
| In normale transito | Utilizza l'intervallo di base per il servizio o la tratta pertinente. | Mantieni un intervallo massimo di riconciliazione. |
| Prossima alla consegna | Valuta intervalli più brevi quando aggiornamenti tempestivi supportano un'azione concreta. | Misura se le richieste aggiuntive restituiscono nuove informazioni. |
| Eccezione o inattività prolungata | Dai priorità all'analisi e utilizza una pianificazione di monitoraggio limitata. | Un polling più rapido non risolve l'eccezione sottostante. |
| Consegnata o altrimenti completata | Rimuovila dal polling ordinario dopo i controlli di chiusura. | Prevedi correzioni e riaperture legittime. |
Mappa esplicitamente gli stati del provider al ciclo di vita interno. Non dare per scontato che una spedizione restituita, un tentativo di consegna fallito e una consegna completata debbano interrompere tutti il monitoraggio. Potrebbero richiedere decisioni operative diverse.
Memorizza per ogni spedizione un timestamp del prossimo controllo idoneo e ricalcolalo quando arrivano eventi significativi. In questo modo la pianificazione è verificabile ed evita di affidarsi a un timer che tratta ogni record allo stesso modo.
3. Utilizza i webhook per le modifiche quando il provider li supporta
Il polling chiede se è cambiato qualcosa. Un webhook consente a un provider di notificare la tua applicazione quando è disponibile un aggiornamento. Quando gli eventi richiesti e il comportamento di consegna sono supportati, utilizza la consegna push come percorso principale di acquisizione invece di interrogare ripetutamente ogni spedizione attiva.
I webhook non eliminano i ritardi a monte. Introducono inoltre requisiti per la gestione della consegna. Prima dell'implementazione, verifica il meccanismo di autenticazione documentato dal provider, le regole di conferma, il comportamento dei nuovi tentativi e gli identificativi degli eventi.
- Autentica le richieste in ingresso utilizzando il meccanismo documentato.
- Memorizza in modo durevole o accoda una notifica valida prima di confermarne la ricezione.
- Elabora le notifiche in modo idempotente affinché una consegna ripetuta non generi messaggi duplicati ai clienti.
- Gestisci gli eventi ritardati e fuori ordine senza sovrascrivere uno stato più recente con informazioni più vecchie.
- Monitora gli errori di elaborazione e l'età delle notifiche in coda.
Non presumere che la consegna dei webhook avvenga esattamente una volta o sempre in ordine cronologico, salvo garanzia esplicita del provider. Mantieni la cronologia degli eventi della spedizione separata dal suo stato normalizzato corrente, così le informazioni tardive possono essere valutate invece di essere applicate ciecamente.
4. Aggiungi una riconciliazione mirata invece di un secondo ciclo completo di polling
Un'integrazione basata sui webhook necessita comunque di un percorso di recupero. Il tuo endpoint potrebbe non essere disponibile, un worker potrebbe non riuscire dopo la ricezione oppure un errore di mappatura interno potrebbe impedire a un aggiornamento di raggiungere il record dell'ordine.
La riconciliazione verifica se lo stato memorizzato corrisponde a quello del provider. Deve concentrarsi sui record che richiedono una verifica, non ricreare un polling frequente sull'intera popolazione delle spedizioni.
Tra i candidati utili alla riconciliazione rientrano le spedizioni con elaborazione delle notifiche non riuscita, i record che hanno superato l'intervallo massimo di verifica e le spedizioni interessate da un'interruzione nota. Un vecchio evento del corriere da solo non costituisce necessariamente una prova di un aggiornamento mancante.
Dopo un'interruzione, accoda i record interessati ed elaborali entro un budget controllato di richieste. Elimina i duplicati tra i processi di recupero sovrapposti e annulla il lavoro ridondante quando un aggiornamento riuscito ha già risolto la discrepanza. Evita di avviare una richiesta simultanea per ogni spedizione attiva.
Registra separatamente il timestamp dell'ultima verifica riuscita e quello dell'ultimo evento. In caso contrario, un pacco senza scansioni recenti potrebbe qualificarsi ripetutamente per la riconciliazione anche se il sistema ha appena confermato che il provider non dispone di nuove informazioni.
5. Memorizza nella cache i dati di tracciamento e condividi le richieste tra i consumer
Una pagina di tracciamento, una dashboard di assistenza, un worker per le notifiche e il sistema degli ordini potrebbero richiedere tutti la stessa spedizione. Fornisci loro un record applicativo condiviso invece di consentire a ogni consumer di interrogare autonomamente il provider di tracciamento.
Memorizza localmente lo stato della spedizione noto più recente, insieme all'ora del recupero e ai timestamp degli eventi pertinenti. Lascia che lo scheduler o il gestore dei webhook aggiorni il record. Un cliente che aggiorna una pagina non dovrebbe forzare automaticamente un'altra richiesta a monte.
Utilizza il request coalescing oltre alla cache: se diversi consumer richiedono contemporaneamente lo stesso record obsoleto, consenti una sola operazione di aggiornamento e lascia che gli altri utilizzino o attendano il risultato. Definisci correttamente le chiavi della cache e i controlli di accesso, affinché i dati non attraversino i confini degli account.
Se un endpoint supporta validator HTTP come ETag o Last-Modified, le richieste condizionali possono ridurre il trasferimento del corpo della risposta. Tuttavia, una richiesta condizionale è comunque una richiesta e può ancora essere conteggiata nella quota del provider. La semantica della cache HTTP è definita in RFC 9111; il supporto per uno specifico endpoint di tracciamento deve essere verificato separatamente.
Rendi comprensibile l'aggiornamento nell'interfaccia. “Ultimo controllo” dovrebbe descrivere il recupero, mentre “Ultimo evento della spedizione” dovrebbe descrivere l'evento del corriere. Mostrare un solo timestamp come se rappresentasse entrambi può trarre in inganno i clienti.
6. Raggruppa le consultazioni idonee e distribuisci le richieste nel tempo
Quando l'endpoint di consultazione pertinente supporta più record di tracciamento per richiesta, il raggruppamento può ridurre il numero di richieste HTTP. Verifica che l'operazione necessaria supporti il raggruppamento: la registrazione in batch non implica automaticamente il recupero in batch.
Distingui inoltre l'efficienza del trasporto dalla fatturazione. Una richiesta HTTP contenente diversi record può comunque consumare più unità di quota o consultazioni fatturabili, a seconda delle regole del provider.
Uno scheduler pratico dovrebbe:
- Selezionare i record il cui orario del prossimo controllo idoneo è arrivato.
- Escludere i record completati, sospesi o già accodati.
- Raggruppare i record idonei entro i limiti documentati dell'endpoint e del payload.
- Distribuire il lavoro tramite un rate limiter condiviso.
- Registrare l'esito di ogni elemento e riprovare solo quelli non riusciti o non risolti, quando appropriato.
Distribuisci il lavoro nell'intera finestra di pianificazione invece di eseguire tutti i processi allo scoccare dell'ora. Aggiungi un offset casuale limitato, spesso chiamato jitter, per ridurre i picchi sincronizzati. Mantieni tale offset sufficientemente piccolo da rispettare l'obiettivo di aggiornamento di ogni flusso.
Il raggruppamento è meno utile quando attendere il completamento di un batch ritarderebbe un aggiornamento urgente. Consenti al lavoro sensibile al tempo di procedere senza un batch completo, mantenendolo però entro lo stesso budget complessivo di frequenza.
7. Adattati ai limiti di frequenza, agli errori e ai controlli di scarso valore
Il normale intervallo di aggiornamento non dovrebbe essere anche l'intervallo per i nuovi tentativi in caso di errore. Un endpoint non disponibile richiede nuovi tentativi controllati, non un'altra ondata completa di richieste pianificate sovrapposta agli errori.
HTTP 429 significa “Troppe richieste” e la risposta può includere un campo Retry-After, come descritto in RFC 6585. La semantica HTTP del campo è definita in RFC 9110. Segui le istruzioni applicabili del provider e un valore Retry-After valido quando fornito. Altrimenti, utilizza un backoff esponenziale limitato con jitter per gli errori ripetibili.
Non ripetere indefinitamente i tentativi per errori di autenticazione o input di tracciamento non validi. Instradali alla correzione. Per le operazioni che modificano lo stato lato server, conferma la sicurezza dei nuovi tentativi prima di ripetere automaticamente una richiesta dopo un timeout ambiguo.
Adatta separatamente il polling normale. Se controlli riusciti ripetuti non restituiscono nuove informazioni, valuta di aumentare l'intervallo entro i limiti di aggiornamento della spedizione. Quando un evento significativo sposta il pacco in una fase più sensibile al tempo, riducilo nuovamente.
Applica il rate limiting a tutti i worker che condividono la quota pertinente. Limiti indipendenti per i worker possono sembrare conformi singolarmente mentre il traffico combinato supera l'assegnazione a livello di account.
Valida insieme aggiornamento ed efficienza
Testa la policy su un gruppo controllato di spedizioni prima di applicarla su larga scala. Confronta flussi con corriere, tratta e caratteristiche del ciclo di vita simili, affinché un cambiamento nel mix delle spedizioni non venga scambiato per un miglioramento della pianificazione.
- Rendimento degli aggiornamenti utili: la proporzione di controlli riusciti che aggiungono informazioni significative.
- Età della verifica: il tempo trascorso dall'ultimo controllo riuscito dello stato presso il provider.
- Ritardo di acquisizione: il tempo dalla disponibilità presso il provider alla ricezione da parte dell'applicazione, quando l'ora di disponibilità è osservabile.
- Pressione sulle richieste: volume delle richieste, risposte di limite di frequenza, nuovi tentativi e profondità della coda.
- Qualità del recupero: modifiche mancanti recuperate tramite riconciliazione e tempo necessario per risolvere gli errori.
Non definire il tempo dall'evento del corriere all'acquisizione come puro ritardo di integrazione. Può includere ritardi di pubblicazione e raccolta a monte che l'applicazione non può controllare direttamente. Una policy efficace riduce i recuperi non necessari mantenendo le modifiche operative importanti entro gli obiettivi di aggiornamento definiti.
Domande frequenti
Qual è il miglior intervallo di polling per il tracciamento delle spedizioni?
Non esiste un intervallo universale. Sceglilo in base all'obiettivo di aggiornamento del flusso di lavoro, al comportamento degli aggiornamenti a monte, ai limiti API e al budget delle richieste. Inizia con una base documentata, misura il valore dei controlli riusciti e adatta l'intervallo in base allo stato del ciclo di vita invece di rendere più rapido il polling di ogni spedizione.
L'aggiornamento di una pagina di tracciamento forza un nuovo controllo del corriere?
Non necessariamente. La pagina potrebbe leggere la cache della tua applicazione o i dati di tracciamento memorizzati dal provider. L'aggiornamento del browser, una consultazione API e un aggiornamento del corriere a monte sono operazioni distinte. Descrivi un aggiornamento come in tempo reale solo se il comportamento documentato supporta tale affermazione.
I webhook possono sostituire completamente il polling?
Possono sostituire gran parte del polling ordinario quando il provider supporta gli aggiornamenti necessari. Mantieni un processo di riconciliazione limitato per gli errori e gli stati incerti. La quantità di controlli ancora necessaria dipende dalle garanzie di consegna, dalle opzioni di recupero e dalle conseguenze di un aggiornamento mancante.
Quando dovrebbero interrompersi le richieste di tracciamento dopo la consegna?
Rimuovi le spedizioni consegnate dal polling attivo ordinario dopo aver completato i controlli di chiusura. Decidi se un periodo limitato di verifica è giustificato dal flusso di lavoro e dal comportamento del provider. Mantieni la possibilità di elaborare correzioni senza lasciare ogni spedizione completata in una pianificazione indefinita.
Meno richieste HTTP ridurranno sempre i costi API?
No. La fatturazione può dipendere dalle spedizioni, dai record di tracciamento, dalle operazioni o da un'altra unità contrattuale, anziché dal numero di richieste HTTP. Conferma le regole di contabilizzazione applicabili prima di attribuire risparmi economici al raggruppamento, alla memorizzazione nella cache o all'adozione dei webhook.
Fonti
- Panoramica dell'API di tracciamento 17TRACK — punto di accesso ufficiale per valutare l'integrazione di tracciamento.
- Documentazione API 17TRACK — riferimento per verificare le operazioni supportate e i requisiti di integrazione prima di configurare la pianificazione lato applicazione.
- RFC 9110: HTTP Semantics — semantica dei metodi HTTP, richieste condizionali e Retry-After.
- RFC 9111: HTTP Caching — comportamento della cache e convalida delle risposte.
- RFC 6585: Additional HTTP Status Codes — definizione della risposta 429 Too Many Requests.