追跡更新頻度を設定する7つの方法:より新鮮なデータ、より少ないAPIリクエスト
鮮度の目標を設定し、配送状況に応じてポーリング頻度を変え、対応している場合は Webhook を使用し、取得漏れの更新を照合し、共有結果をキャッシュし、スケジュールされた処理をバッチ化し、エラーやレート制限中はバックオフすることで、追跡情報の更新頻度を設定できます。開発者や運用チームにとっての目標は、可能な限り短い間隔ではありません。変更されていないデータを繰り返しリクエストすることなく、有用な配送状況の変化をシステムに取り込むことです。
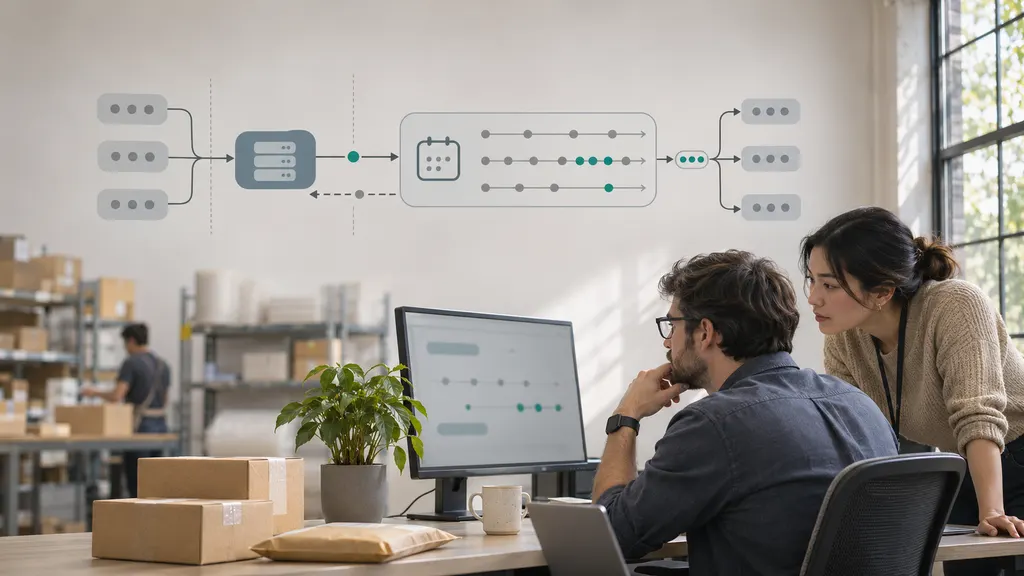
これらの制御は通常、追跡プロバイダーと注文管理システム、サポートプラットフォーム、または顧客向け追跡ページを接続するアプリケーション側に実装します。プロバイダー自身が更新制御機能を提供している場合もあります。この2つのレイヤーは分けて考えてください。アプリケーションのリクエストスケジュールを変更しても、プロバイダーが配送業者を確認する頻度が変わるとは限りません。
まず、制御できる更新頻度を特定する
顧客が配送状況を確認するまでに、配送情報の更新はいくつかの段階を通過します。配送業者がイベントを記録し、追跡サービスがそれを取得し、アプリケーションが受信または取得し、インターフェースが表示します。どの段階で遅延しても、追跡情報が古く見える可能性があります。
- 配送業者のイベント提供状況:配送業者がスキャンやステータス変更を記録して公開するタイミング。
- プロバイダーの更新頻度:追跡サービスが配送業者の情報を確認または受信するタイミング。
- アプリケーションの取得頻度:システムが情報をリクエストする、または受信した通知を処理するタイミング。
- 表示の更新頻度:Webサイト、アプリ、またはサポートツールがローカル表示を更新するタイミング。
プロバイダーへのポーリング頻度を高めると、3つ目の遅延を短縮できます。ただし、配送業者の新しいスキャンを保証したり、上流の更新を強制したりすることはできません。文書化されたエンドポイントが明示的にその処理を行う場合を除きます。スケジュールを変更する前に、APIリクエストが保存済みの追跡データを読み取るのか、更新を開始するのか、それとも別の処理を行うのかを確認してください。
17TRACKとの連携では、まずTracking APIの概要と公式APIドキュメントを確認してください。更新の配信、リクエスト制限、更新制御機能など、使用する操作の動作を確認します。以下のスケジューリングパターンはアプリケーション側の推奨事項であり、すべての間隔が設定可能な17TRACKの設定であることを示すものではありません。
1. 間隔を選ぶ前に鮮度の目標を設定する
新たに利用可能になったイベントを各業務フローがどれほど早く把握する必要があるかを定義します。配達例外のキューでは、過去の配送状況ダッシュボードより短い目標間隔が必要になる場合があります。両者に同じポーリング間隔を設定すると、リクエストを無駄にするか、より緊急性の高いワークフローに十分な対応ができなくなります。
2つの測定値を分けてください。最後に正常取得してからの経過時間と、最新の配送イベントの経過時間です。変更がないため、成功したリクエストでも古いイベントが返されることがあります。これは、連携の失敗によって最近データを取得できていない状態とは異なります。
コード全体に間隔を埋め込むのではなく、小さな設定ポリシーを使用します。
- 鮮度目標:プロバイダーで利用可能になってからアプリケーションに取り込まれるまでに許容される遅延。
- 通常のポーリング間隔:対象となる配送に適用するデフォルトの間隔。
- 最大照合間隔:配送情報を正常に検証しないまま許容できる時間。
- リクエスト予算:リトライ、照合、その他のAPI操作を考慮した後に利用できる容量。
計画例として、12,000件の配送を1時間ごとに個別確認すると、リトライ前でも1日あたり288,000件のスケジュール済み照会リクエストが発生します。4時間ごとなら72,000件です。これは説明用の計算であり、プロバイダーの制限や推奨間隔ではありません。バッチ処理やプッシュ配信によって計算は変わります。
ワークフローの鮮度目標を満たす最も長い間隔を選び、その後、上流データがその間隔を有効に活用できるほど新鮮かどうかをテストします。
2. 配送状況の変化に応じて間隔を変更する
単一のスケジュールでは、配送ごとの動作の違いを無視してしまいます。初回スキャンを待っている荷物、長い輸送区間を移動中の荷物、配達に近づいている荷物に、同じ頻度で対応する必要があるとは限りません。
| 配送状況 | 推奨されるスケジュール方法 | 注意点 |
|---|---|---|
| 配送業者からの初回情報待ち | 一定回数確認し、変更がなければ間隔を延長する。 | スキャンがないことだけを配送失敗の証拠と見なさない。 |
| 正常に輸送中 | 対象サービスまたは経路に適した基準間隔を使用する。 | 最大照合間隔を維持する。 |
| 配達間近 | 迅速な更新が実際の対応に役立つ場合は、短い間隔を検討する。 | 追加リクエストが新しい情報を返すか測定する。 |
| 例外または長時間の停止 | 調査を優先し、上限を設けた監視スケジュールを使用する。 | ポーリングを速くしても根本的な例外は解決しない。 |
| 配達済みまたはその他の完了状態 | 終了確認後、通常のポーリングから除外する。 | 訂正や正当な再開に対応できるようにする。 |
プロバイダーのステータスを社内のライフサイクルに明示的に対応付けます。返送、配達試行の失敗、配達完了をすべて監視停止の対象と考えないでください。それぞれ異なる運用上の判断が必要になる場合があります。
各配送について次回確認可能時刻を保存し、意味のあるイベントが到着したときに再計算します。これによりスケジュールを監査可能にし、すべてのレコードを同じように扱うタイマーへの依存を避けられます。
3. プロバイダーが対応している場合は変更にWebhookを使用する
ポーリングは変更があったかどうかを尋ねます。Webhookを使用すると、更新が利用可能になったときにプロバイダーからアプリケーションへ通知できます。必要なイベントと配信動作がサポートされている場合は、アクティブな配送を繰り返し問い合わせるのではなく、プッシュ配信を主要な取り込み経路として使用します。
Webhookによって上流の遅延がなくなるわけではありません。また、配信処理に関する要件も追加されます。実装前に、プロバイダーが文書化している認証方式、確認応答のルール、リトライ動作、イベント識別子を確認してください。
- 文書化された方式で受信リクエストを認証する。
- 正常な受信を確認する前に、有効な通知を永続的に保存またはキューに追加する。
- 通知をべき等に処理し、同じ通知が再配信されても顧客メッセージを重複送信しないようにする。
- 遅延イベントや順不同のイベントを処理し、古い情報で新しい状態を上書きしない。
- 処理失敗とキュー内通知の経過時間を監視する。
プロバイダーが明示的に保証していない限り、Webhookが必ず1回だけ、または常に時系列で配信されると想定しないでください。遅れて届いた情報を盲目的に適用せず評価できるよう、配送のイベント履歴と現在の正規化済みステータスを分けて保持します。
4. 2つ目の全面ポーリングループではなく、対象を絞った照合を追加する
Webhookベースの連携にも復旧経路が必要です。エンドポイントが利用できない、受信後にワーカーが失敗する、社内のマッピングエラーによって更新が注文レコードに届かない、といった可能性があります。
照合とは、保存されている状態がプロバイダーの状態と一致しているかを確認することです。配送全体に対して頻繁なポーリングを再現するのではなく、検証が必要なレコードに集中させます。
照合対象としては、通知処理に失敗した配送、最大検証間隔を超えたレコード、既知の障害の影響を受けた配送などが考えられます。古い配送業者イベントだけでは、更新漏れの証拠とは限りません。
障害後は影響を受けたレコードをキューに入れ、制御されたリクエスト予算内で処理します。重複する復旧ジョブを排除し、成功した更新によって不一致が解消された場合は不要な処理をキャンセルします。アクティブな配送すべてに同時にリクエストを送ることは避けてください。
最後に正常検証した時刻を、最新イベントの時刻とは別に記録します。そうしないと、最近のスキャンがない荷物が、プロバイダーに新しい情報がないことをシステムで確認した直後であっても、繰り返し照合対象になる可能性があります。
5. 追跡データをキャッシュし、利用者間でリクエストを共有する
追跡ページ、サポートダッシュボード、通知ワーカー、注文システムが同じ配送を要求することがあります。各利用者が個別に追跡プロバイダーへ問い合わせるのではなく、共有のアプリケーションレコードを使用します。
最新の既知の配送状態を、取得時刻と関連するイベント時刻とともにローカルに保存します。スケジューラーまたはWebhookハンドラーにそのレコードを更新させます。顧客がページを更新しただけで、上流への新しいリクエストを自動的に発生させないでください。
キャッシュだけでなくリクエストの統合も使用します。複数の利用者が同時に同じ古いレコードを要求した場合、1つの更新処理だけを実行し、他の利用者にはその結果を使用または待機させます。データがアカウント境界を越えないよう、キャッシュキーとアクセスチェックを正しく設定します。
エンドポイントがETagやLast-ModifiedなどのHTTPバリデーターに対応している場合、条件付きリクエストによってレスポンス本文の転送量を削減できる可能性があります。ただし、条件付きリクエストもリクエストであり、プロバイダーの割り当てに加算される場合があります。HTTPキャッシュのセマンティクスはRFC 9111で定義されています。特定の追跡エンドポイントへの対応状況は別途確認してください。
インターフェース上で鮮度を分かりやすくします。「最終確認時刻」は取得を示し、「最新の配送イベント」は配送業者のイベントを示すべきです。1つの時刻が両方を表すように表示すると、顧客を誤解させる可能性があります。
6. 対象となる照会をバッチ化し、時間を分散してリクエストする
対象の照会エンドポイントが1回のリクエストで複数の追跡レコードに対応している場合、バッチ処理によってHTTPリクエスト数を削減できます。必要な操作がバッチ処理に対応していることを確認してください。登録のバッチ対応は、取得のバッチ対応を自動的に意味するものではありません。
また、通信効率と課金を区別してください。複数のレコードを含む1回のHTTPリクエストでも、プロバイダーのルールによっては複数の割り当て単位や課金対象の照会を消費する可能性があります。
実用的なスケジューラーは次の処理を行うべきです。
- 次回確認可能時刻に達したレコードを選択する。
- 完了、一時停止、またはすでにキューに入っているレコードを除外する。
- 文書化されたエンドポイントおよびペイロードの制限内で対象レコードをグループ化する。
- 共有レートリミッターを通じて処理を実行する。
- 各項目の結果を記録し、必要に応じて失敗または未解決の項目だけをリトライする。
すべてのジョブを毎時ちょうど同じ時刻に実行するのではなく、スケジュール期間全体に処理を分散させます。同期したバーストを減らすため、通常ジッターと呼ばれる上限付きのランダムなずれを追加します。そのずれは各ワークフローの鮮度目標を守れるほど小さくしてください。
バッチを埋めるために待つことで緊急の更新が遅れる場合、バッチ処理の効果は低くなります。時間に敏感な処理は完全なバッチを待たずに実行できるようにしつつ、全体のレート予算内に収めます。
7. レート制限、失敗、価値の低い確認に適応する
通常の更新間隔を、そのままエラー時のリトライ間隔にしてはいけません。利用できないエンドポイントには、失敗に重ねて予定済みリクエストの波を追加するのではなく、制御されたリトライが必要です。
HTTP 429は「Too Many Requests」を意味し、そのレスポンスにはRFC 6585で説明されているRetry-Afterフィールドが含まれる場合があります。このフィールドのHTTPセマンティクスはRFC 9110で定義されています。適用されるプロバイダーの指示と、有効なRetry-After値が提供されている場合はそれに従ってください。それ以外の場合は、リトライ可能な失敗に対してジッター付きの上限付き指数バックオフを使用します。
認証失敗や無効な追跡入力を無期限にリトライしないでください。修正処理へ振り分けます。サーバー側の状態を変更する操作では、タイムアウトが不明確な場合にリクエストを自動的に繰り返して安全かどうかを確認してください。
通常のポーリングには別途適応させます。成功した確認を繰り返しても新しい情報が返らない場合、配送の鮮度上限内で間隔を延長することを検討します。意味のあるイベントによって荷物がより時間に敏感な段階へ移った場合は、再び短くします。
関連する割り当てを共有するすべてのワーカーに対してレート制限を適用します。ワーカーごとの独立した制限はそれぞれ遵守しているように見えても、合計トラフィックがアカウントレベルの許容量を超える可能性があります。
鮮度と効率を同時に検証する
ポリシーを広く適用する前に、管理された配送グループでテストします。配送業者、経路、ライフサイクル特性が似たワークフローを比較し、配送構成の変化をスケジューリングの改善と取り違えないようにします。
- 有用な更新の割合:意味のある情報を追加した成功確認の割合。
- 検証経過時間:最後にプロバイダーの状態を正常に確認してからの時間。
- 取り込み遅延:プロバイダーで利用可能になってからアプリケーションが受信するまでの時間。
- リクエスト負荷:リクエスト量、レート制限レスポンス、リトライ、キューの深さ。
- 復旧品質:照合によって復旧した更新漏れと、失敗の解消にかかった時間。
配送業者イベントから取り込みまでの時間を、純粋な連携遅延と表現しないでください。これには、アプリケーションが直接制御できない上流での公開や収集の遅延が含まれる可能性があります。適切なポリシーは、不要な取得を減らしながら、運用上重要な変更を定義された鮮度目標内に維持します。
FAQ
配送追跡に最適なポーリング間隔はどれくらいですか?
全体に適用できる間隔はありません。ワークフローの鮮度目標、上流の更新動作、API制限、リクエスト予算から決めてください。文書化された基準から始め、成功した確認の価値を測定し、すべての配送を速くポーリングするのではなく、ライフサイクルの状態に応じて調整します。
追跡ページを更新すると、新しい配送業者の確認が強制されますか?
必ずしもそうではありません。ページはアプリケーションのキャッシュやプロバイダーに保存された追跡データを読み取る場合があります。ブラウザーの更新、API照会、上流の配送業者更新は別々の操作です。文書化された動作がその主張を裏付ける場合に限り、更新をリアルタイムと表現してください。
Webhookでポーリングを完全に置き換えられますか?
プロバイダーが必要な更新に対応していれば、通常のポーリングの大部分を置き換えられます。失敗や不確実な状態に備え、上限を設けた照合処理は残してください。どの程度の確認が必要かは、配信保証、復旧手段、更新漏れによる影響によって異なります。
配達後、いつ追跡リクエストを停止すべきですか?
終了確認を完了したら、配達済みの配送を通常のアクティブポーリングから除外します。ワークフローとプロバイダーの動作に基づき、限定的な検証期間が必要か判断してください。完了した配送すべてを無期限のスケジュールに残すことなく、訂正を処理できるようにします。
HTTPリクエストを減らせば、API料金も必ず下がりますか?
いいえ。課金はHTTPリクエスト数ではなく、配送、追跡レコード、操作、その他の契約上の単位に基づく場合があります。バッチ処理、キャッシュ、Webhookの導入による金銭的な節約を見積もる前に、適用される計測ルールを確認してください。
参考資料
- 17TRACK Tracking APIの概要 — 追跡連携を評価するための公式エントリーポイント。
- 17TRACK APIドキュメント — アプリケーション側のスケジューリングを設定する前に、対応操作と連携要件を確認するためのリファレンス。
- RFC 9110: HTTP Semantics — HTTPメソッドのセマンティクス、条件付きリクエスト、Retry-After。
- RFC 9111: HTTP Caching — キャッシュ動作とレスポンス検証。
- RFC 6585: Additional HTTP Status Codes — 429 Too Many Requestsレスポンスの定義。