Comment intégrer les données de suivi des expéditions dans les systèmes de BI pour le commerce électronique transfrontalier
Pour intégrer les données de suivi des expéditions dans les systèmes de BI pour le commerce électronique transfrontalier, collectez les mises à jour de suivi via une API ou un flux d’événements pris en charge, stockez les enregistrements d’origine, normalisez les événements des transporteurs et reliez chaque expédition à vos données de commande. Construisez ensuite des modèles dans l’entrepôt de données qui calculent les performances de livraison, les exceptions et l’actualité des données avant d’exposer ces modèles aux tableaux de bord. Le choix de conception le plus important consiste à séparer ce qui est arrivé à un colis du moment où vos systèmes l’ont appris.
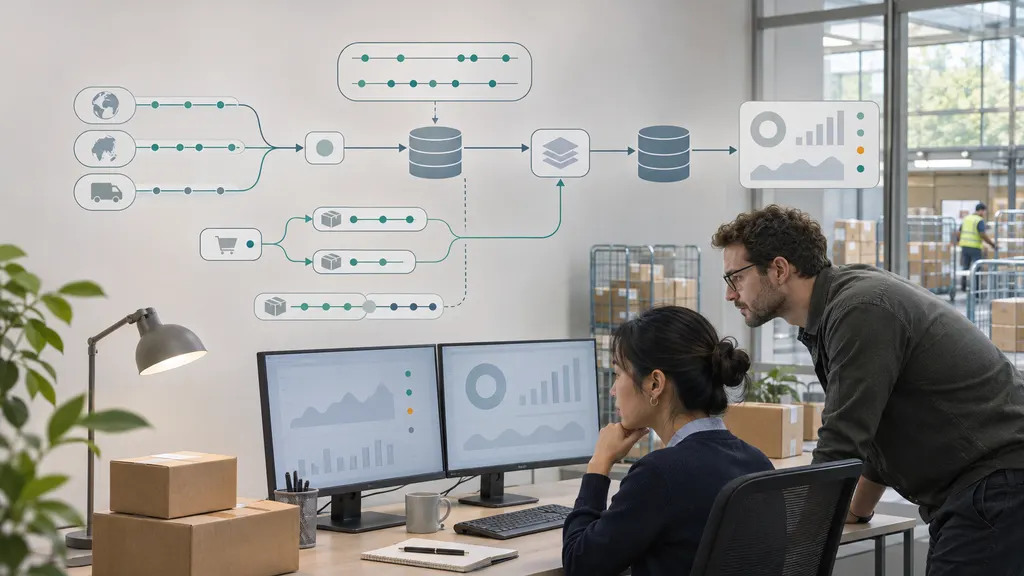
Ce guide s’adresse aux ingénieurs data, aux équipes d’analytique et aux responsables des opérations logistiques qui construisent ce pipeline. L’ingénierie doit être responsable de l’ingestion et de la fiabilité ; les opérations doivent définir les jalons d’expédition et les règles d’exception ; l’analytique doit être responsable des définitions des indicateurs. Sans ces définitions partagées, une intégration techniquement réussie peut tout de même produire des rapports trompeurs.
Construire un pipeline de données, pas une connexion entre un tableau de bord et une API
Une architecture de référence utile est la suivante :
Source de suivi → service d’ingestion → stockage brut durable → transformation et validation → entrepôt analytique → modèle sémantique de BI → tableaux de bord et alertes
Conservez les données de commande, d’exécution et de service client aux côtés du pipeline de suivi, avec des jointures contrôlées entre elles. Les événements de suivi expliquent le déplacement du colis. À eux seuls, ils n’établissent pas la date de livraison promise au client, la valeur de la commande, l’issue d’un remboursement ou l’historique du support.
Connecter directement un tableau de bord à une API de suivi peut fonctionner pour un petit prototype, mais cela rend plus difficiles à contrôler la reconstitution historique, les nouvelles tentatives et les définitions partagées des indicateurs. Pour les rapports opérationnels récurrents, faites persister les données avant de les présenter.
Où s’intègre 17TRACK
17TRACK Tracking API est une option de source pertinente pour une intégration de données de suivi. Utilisez sa documentation officielle de l’API pour confirmer le contrat d’intégration de votre implémentation. Validez l’authentification, l’enregistrement des expéditions, les champs d’événement disponibles, les méthodes de transmission des mises à jour, les limites d’utilisation et la gestion des erreurs avant de concevoir votre intégration sur cette base.
Traitez la source de suivi et le pipeline de BI comme des couches distinctes. Ne supposez pas que l’accès aux données de suivi inclut un connecteur natif vers votre entrepôt ou votre outil de BI. Testez les transporteurs, les services d’expédition, les marchés de destination et la configuration du compte que vous prévoyez réellement d’utiliser.
1. Définir les questions opérationnelles et le niveau de granularité des rapports
Commencez par les décisions que le tableau de bord doit permettre de prendre. Un responsable logistique qui enquête sur des colis retardés a besoin d’exceptions au niveau de l’expédition. Un analyste commercial qui compare des services d’expédition a besoin de cohortes de livraison et de dénominateurs cohérents. Ces vues sont liées, mais elles ne doivent pas être construites à partir d’un ensemble indéfini de statuts de suivi.
- Performance de livraison : Quelles voies d’expédition ne respectent pas la promesse faite au client ?
- Gestion des exceptions : Quelles expéditions actives nécessitent une enquête ?
- Transferts entre transporteurs : Où la visibilité disparaît-elle entre les étapes de transport ?
- Impact client : Quels modèles de livraison sont associés à des contacts avec le support ou à des remboursements ?
- État de santé de l’intégration : Quelles sources fournissent des données incomplètes ou obsolètes ?
Choisissez un niveau de granularité principal pour les rapports : généralement un colis physique ou une expédition, et non une commande. Une commande peut contenir plusieurs colis, et une expédition de remplacement peut exister à côté de l’expédition originale. Préservez ces relations au lieu de forcer chaque commande à utiliser un seul numéro de suivi.
Définissez séparément l’achèvement au niveau de la commande. Par exemple, une commande peut être considérée comme livrée uniquement lorsque tous les colis sortants requis sont livrés. Les retours, les colis annulés et les remplacements nécessitent un traitement explicite afin de ne pas fausser le dénominateur.
2. Créer l’identité de l’expédition avant d’importer les événements
N’utilisez pas un numéro de suivi comme seule clé de base de données. Son interprétation peut dépendre du transporteur et du contexte de l’expédition. Créez un identifiant interne d’expédition et conservez les références externes nécessaires pour rapprocher les enregistrements.
| Champ | Objectif | Considération de conception |
|---|---|---|
| shipment_id | Identité interne stable | Conservez-le indépendamment des modifications apportées aux références externes. |
| order_id et fulfillment_id | Relier l’expédition aux enregistrements commerciaux | Prendre en charge les commandes fractionnées et les expéditions de remplacement. |
| tracking_number et carrier_reference | Identifier le déplacement suivi | Conservez les valeurs brutes ainsi que les identifiants standardisés éventuels. |
| shipment_leg_id | Représenter une étape du transport | À utiliser lorsque des références internationales et de dernier kilomètre distinctes existent. |
| source_system | Expliquer la provenance de l’enregistrement | Distinguez les valeurs du système de commande de celles de la source de suivi. |
| promised_delivery_at | Mesurer la performance par rapport à un engagement | Conservez la promesse applicable ainsi que son historique de révision. |
Créez une table de correspondance lorsqu’une expédition possède plusieurs références ou étapes de suivi. Cela permet aux analystes de suivre un colis transfrontalier lors d’un transfert sans le compter comme deux expéditions livrées.
3. Ingérer les mises à jour en tenant compte de la relecture et du rapprochement
Utilisez le mécanisme de mise à jour pris en charge par votre source. Si la livraison d’événements est disponible, recevez les mises à jour via un service qui valide les requêtes et écrit les charges utiles acceptées dans un stockage durable. Si l’interrogation périodique est nécessaire, planifiez les requêtes en fonction des limites documentées et des exigences de fraîcheur métier.
Pour une ingestion pilotée par les événements, accusez réception uniquement après que la charge utile a été sauvegardée en toute sécurité ou placée dans une file durable. Gardez le point de réception léger ; effectuez les transformations coûteuses en aval. Suivez les mécanismes documentés d’authentification et de vérification des requêtes de la source au lieu d’inventer un format de signature supposé.
Pour l’interrogation périodique, stockez les points de contrôle de récupération et utilisez des fenêtres de récupération chevauchantes lorsque l’API l’autorise. Un chevauchement peut aider à capturer les mises à jour retardées, mais il nécessite également une déduplication. Ne supposez pas qu’un curseur de pagination représente un point de contrôle historique permanent, sauf si la documentation l’indique.
- Conservez la charge utile originale, l’horodatage de réception, l’identifiant de la source et l’identifiant de l’exécution d’ingestion.
- Réessayez les échecs transitoires avec un délai d’attente progressif contrôlé et respectez les limites de débit documentées.
- Dirigez les enregistrements qui échouent de manière répétée vers une file de révision au lieu de les supprimer silencieusement.
- Rapprochez les expéditions suivies avec le système d’exécution afin d’identifier les enregistrements manquants.
- Effectuez régulièrement des contrôles sur les expéditions actives dont les données de suivi ne sont plus mises à jour.
Rendez les écritures idempotentes : le traitement répété d’une même mise à jour ne doit pas créer un événement logique supplémentaire. Préférez un identifiant d’événement stable et documenté. S’il n’en existe pas, définissez et testez une empreinte composite à partir de l’identité de l’expédition, de l’heure de l’événement, du code d’événement, du lieu et des autres champs pertinents. Préservez les enregistrements bruts afin de pouvoir enquêter sur les collisions ou les corrections.
4. Normaliser les événements sans perdre leur signification
Les descriptions des transporteurs ne doivent pas devenir directement des catégories de tableau de bord. Créez une couche de correspondance documentée qui traduit les événements sources en un ensemble plus restreint de jalons métier tout en conservant la description et le code d’origine.
Une taxonomie de départ peut inclure : informations reçues, accepté par le transporteur, en transit, en cours de livraison, livré, tentative de livraison, exception et retour. Il s’agit de catégories internes proposées, et non de l’affirmation que toutes les sources de suivi utilisent les mêmes statuts.
Séparez le statut du jalon des attributs d’exception. Une expédition peut rester en transit tout en comportant une exception liée aux douanes. Forcer les deux concepts dans un seul champ rend difficile la distinction entre la progression physique et le risque opérationnel.
Gérer explicitement l’ambiguïté transfrontalière
- Événements douaniers : Conservez la signification rapportée de l’événement. N’interprétez pas chaque référence douanière comme un retard ou comme un dédouanement terminé.
- Transferts entre transporteurs : Associez les références liées à la même expédition lorsque la relation est vérifiée. Une nouvelle référence ne signifie pas nécessairement un nouveau colis.
- Événements inconnus : Gardez-les visibles comme des enregistrements non mappés. Ne forcez pas les codes inconnus dans une catégorie pratique.
- Corrections : Permettez aux informations ultérieures de réviser l’état interprété sans supprimer les preuves antérieures.
Versionnez les règles de correspondance. Lorsqu’une interprétation change, vous devez pouvoir expliquer si un graphique historique a changé parce que la performance de livraison a changé ou parce que la logique de transformation a changé.
5. Modéliser séparément l’heure de l’événement, l’heure d’ingestion et les dates locales
Stockez au minimum l’horodatage de l’événement rapporté et l’horodatage de réception de l’enregistrement par votre plateforme. Un horodatage de chargement dans l’entrepôt est également utile pour diagnostiquer les retards de traitement internes. Ces horodatages répondent à des questions différentes.
Utilisez, lorsque cela est possible, un format d’échange prenant en charge les décalages horaires. RFC 3339 définit un format d’horodatage qui inclut UTC ou un décalage numérique. Préservez la valeur d’origine, normalisez les instants non ambigus en UTC pour les calculs de durée et dérivez les dates locales des rapports à l’aide d’une règle de fuseau horaire explicite.
Si une source fournit un horodatage local sans décalage ni fuseau horaire fiable, indiquez cette incertitude. Ne le traitez pas silencieusement comme UTC. Les hypothèses au niveau du pays peuvent être insuffisantes lorsque plusieurs fuseaux horaires s’appliquent.
Les événements reçus tardivement nécessitent également une attention particulière. Un événement ancien reçu aujourd’hui ne doit pas automatiquement remplacer l’état plus récent d’une expédition. Déduisez l’état actuel à partir de la sémantique documentée des événements, des horodatages et des règles de correction, et non simplement de la ligne de base de données insérée le plus récemment.
6. Construire des modèles d’entrepôt avec des contrats d’indicateurs clairs
Un modèle pratique sépare l’historique des événements des récapitulatifs d’expédition :
- Table de faits des événements : Une ligne par événement de suivi logique, avec sa provenance et ses attributs normalisés.
- Table de faits des expéditions : Une ligne par expédition, contenant les jalons dérivés et l’état actuel.
- Tables de relations : Liens entre commandes, colis, étapes de transport et références externes.
- Dimensions : Transporteur, service, origine, destination, canal et autres attributs de reporting approuvés.
Évitez de joindre directement le chiffre d’affaires de la commande à chaque événement de suivi avant de faire la somme. Cela répète la valeur de la commande sur les lignes d’événements. Agrégez au niveau de granularité approprié ou utilisez des relations explicitement contrôlées dans le modèle sémantique.
| Indicateur | Définition recommandée | Protection d’interprétation |
|---|---|---|
| Durée du transit | Horodatage de livraison moins le premier horodatage admissible d’acceptation par le transporteur | Signaler les scans d’acceptation manquants ; ne pas remplacer par la création de l’étiquette sans le préciser. |
| Taux de livraison à temps | Expéditions éligibles livrées dans le délai promis applicable, divisé par les expéditions éligibles de la cohorte arrivant à échéance | Définir l’heure limite, le fuseau horaire, les exclusions et le traitement des colis en retard non livrés. |
| Incidence des exceptions | Expéditions distinctes présentant une exception admissible, divisé par la cohorte d’expéditions éligibles | Compter les expéditions, et non les messages d’exception répétés. |
| Inactivité du suivi | Heure du rapport moins l’heure du dernier événement de suivi admissible | L’inactivité est un signal à examiner, pas la preuve qu’un colis est perdu. |
| Retard de mise à jour observé | Heure de réception moins l’heure de l’événement rapporté | Séparer la latence de la source de l’incertitude de l’horodatage et du retard de l’entrepôt. |
Utilisez les cohortes livrées pour comprendre les durées de transit terminées, mais ne les considérez pas comme l’ensemble du tableau de performance. Les expéditions lentes encore en transit sont absentes de ce calcul. Associez les statistiques de livraison terminée à une vue du vieillissement des expéditions ouvertes et à une cohorte arrivant à échéance.
Pour les comparaisons entre voies d’expédition, affichez la taille de l’échantillon, le niveau de service, la destination et la période de reporting. Les différences dans la composition des expéditions peuvent expliquer un écart apparent de performance entre transporteurs. Un tableau de bord doit aider à enquêter sur cet écart plutôt qu’à présenter une conclusion causale non étayée.
7. Valider le pipeline avant de publier les tableaux de bord opérationnels
Testez des scénarios, et pas seulement les réponses réussies de l’API. Incluez une livraison normale, une commande fractionnée, une expédition de remplacement, un transfert entre transporteurs, une mise à jour en double, un événement dans le désordre, un fuseau horaire manquant, un événement lié aux douanes, un retour et une correction tardive.
Pour chaque scénario, suivez la charge utile brute à travers les événements normalisés, les récapitulatifs d’expédition et le tableau de bord final. Les opérations doivent confirmer que le statut affiché et l’action recommandée correspondent aux éléments sous-jacents.
- Couverture : Comparer les expéditions exécutées éligibles aux expéditions présentes dans le pipeline de suivi.
- Complétude : Mesurer les identifiants d’expédition, heures d’événement, références de transporteur et promesses de livraison manquants.
- Cohérence : Signaler pour révision les séquences de jalons impossibles ou suspectes au lieu de les réécrire automatiquement.
- Fraîcheur : Surveiller séparément la réception de la source, le traitement dans l’entrepôt et l’actualisation du tableau de bord.
- Reproductibilité : Reconstruire une période de reporting à partir des entrées conservées et confirmer le résultat attendu.
Affichez un indicateur de fraîcheur des données sur les tableaux de bord opérationnels. Une exception de colis et une panne d’ingestion peuvent sembler similaires lorsque les deux apparaissent comme une « absence de mise à jour récente ». Les utilisateurs doivent disposer de suffisamment de contexte pour les distinguer.
8. Déployer avec une responsabilité claire, des contrôles d’accès et des alertes utiles
Testez l’intégration sur un ensemble limité de voies d’expédition comprenant une complexité transfrontalière représentative. Élargissez-la après que la mise en correspondance des expéditions, l’interprétation des statuts et le rapprochement des indicateurs ont satisfait aux critères d’acceptation convenus. Un pilote composé uniquement de livraisons faciles ne testera pas les parties difficiles du modèle.
Limitez l’ingestion analytique aux champs nécessaires à l’objectif de reporting. Restreignez l’accès aux références de suivi et à toute information personnelle, conservez les identifiants d’accès en dehors des rapports de BI et établissez des procédures de conservation et de suppression conformes aux obligations applicables.
Désignez un responsable pour chaque alerte. Un flux d’ingestion obsolète relève de l’ingénierie ; un événement non mappé relève de l’équipe data et des spécialistes de la logistique ; un colis en retard relève du processus opérationnel concerné. Commencez par un petit nombre d’alertes exploitables plutôt que de générer une notification pour chaque scan inhabituel.
L’intégration est prête pour une utilisation plus large lorsqu’un utilisateur métier peut retracer un résultat du tableau de bord jusqu’à une expédition, un événement normalisé et son enregistrement source, et comprendre quelles hypothèses ont façonné le résultat.
FAQ
Ai-je besoin de données de suivi en temps réel pour les rapports de BI ?
Pas nécessairement. Les rapports de performance historiques peuvent fonctionner avec des mises à jour planifiées, tandis que la gestion active des exceptions peut nécessiter des données plus récentes. Définissez d’abord le délai de réponse requis, puis tenez compte des retards de mise à jour de la source, de la latence d’ingestion, du traitement dans l’entrepôt et de l’actualisation du tableau de bord. Une actualisation plus rapide du tableau de bord ne peut pas créer des événements de transporteur qui n’ont pas été signalés.
Les données de suivi peuvent-elles mesurer le temps de dédouanement ?
Uniquement lorsque la source fournit des événements qui représentent de manière fiable le début et la fin de l’étape douanière que vous souhaitez mesurer. Un intervalle entre deux scans ne constitue pas une preuve suffisante de la durée du traitement douanier. Lorsque les limites ne sont pas claires, présentez la mesure comme un intervalle observé plutôt que comme une durée de dédouanement confirmée.
Comment gérer plusieurs numéros de suivi pour une même commande ?
Modélisez séparément la relation commande-expédition et les relations expédition-référence de suivi. Plusieurs colis peuvent appartenir à une commande, tandis que plusieurs références peuvent décrire différentes étapes du parcours d’un même colis. La séparation de ces relations évite les doubles comptages d’expéditions et les rapports incorrects sur l’achèvement des commandes.
Dois-je utiliser des interrogations périodiques ou des mises à jour pilotées par les événements ?
Utilisez les mécanismes pris en charge par la source et sélectionnez-les en fonction des exigences de fraîcheur et de fiabilité. La livraison pilotée par les événements peut réduire les requêtes répétées, tandis que l’interrogation périodique peut permettre la récupération ou le rapprochement lorsqu’elle est disponible. Aucune approche ne supprime la nécessité de dédupliquer, de réessayer, de surveiller et de récupérer les mises à jour manquées.
Les données de suivi peuvent-elles expliquer pourquoi les remboursements ont augmenté ?
Elles peuvent soutenir une enquête lorsqu’elles sont jointes aux enregistrements de remboursement et de support au moyen d’identifiants et de fenêtres temporelles appropriés. Elles ne peuvent pas établir à elles seules un lien de causalité. Vérifiez les motifs de remboursement, les problèmes liés aux produits, les segments de clientèle, les services d’expédition et les autres facteurs pertinents avant d’attribuer l’augmentation à la performance de livraison.
Sources
- 17TRACK Tracking API — point de départ officiel pour évaluer 17TRACK comme source de données de suivi.
- Documentation de l’API 17TRACK — référence pour valider le contrat d’implémentation et le comportement d’intégration pris en charge.
- RFC 3339 : Date et heure sur Internet : horodatages — représentation des horodatages, UTC et conventions de décalage numérique.


