Cómo integrar los datos de seguimiento de envíos en sistemas de BI para el comercio electrónico transfronterizo
Para integrar los datos de seguimiento de envíos en sistemas de BI para el comercio electrónico transfronterizo, recopile las actualizaciones de seguimiento mediante una API o un flujo de eventos compatible, almacene los registros originales, normalice los eventos de los transportistas y conecte cada envío con los datos de sus pedidos. Después, cree modelos en el almacén de datos que calculen el rendimiento de las entregas, las excepciones y la actualidad de los datos antes de exponer esos modelos a los paneles. La decisión de diseño más importante es separar lo que le ocurrió a un paquete de cuándo sus sistemas lo supieron.
Esta guía está dirigida a ingenieros de datos, equipos de analítica y responsables de operaciones logísticas que estén creando ese flujo. Ingeniería debe encargarse de la ingesta y la fiabilidad; operaciones debe definir los hitos de los envíos y las reglas de excepción; analítica debe ser responsable de las definiciones de las métricas. Sin esas definiciones compartidas, una integración técnicamente exitosa aún puede producir informes engañosos.
Construya un flujo de datos, no una conexión entre un panel y una API
Una arquitectura de referencia útil es:
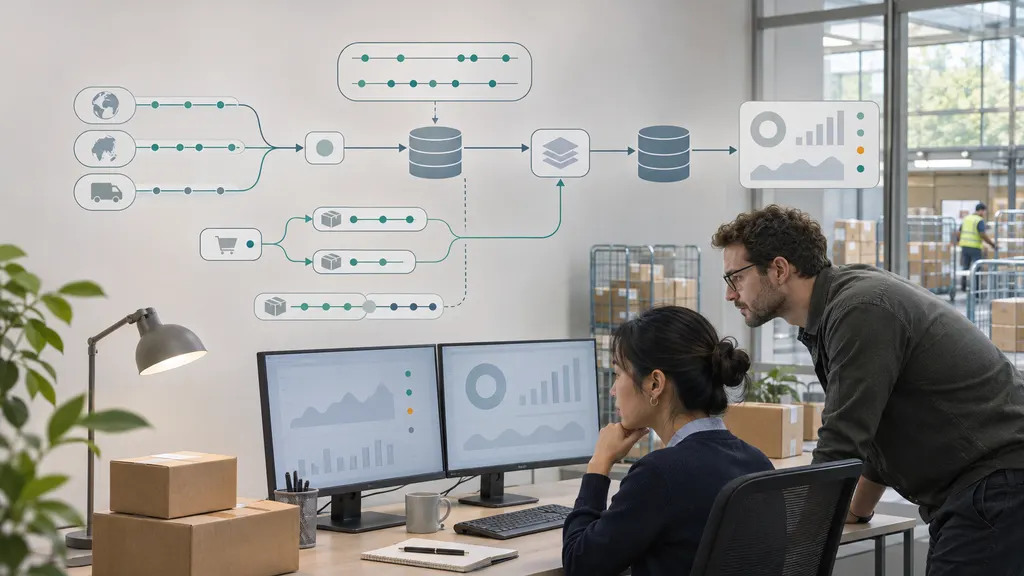
Fuente de seguimiento → servicio de ingesta → almacenamiento de datos sin procesar duradero → transformación y validación → almacén de datos analíticos → modelo semántico de BI → paneles y alertas
17TRACK API Global Shipment Tracking Solution — Conéctese a más de 3.500 transportistas de todo el mundo mediante una única API para realizar un seguimiento de paquetes fácil, preciso y fiable. Pruébelo gratis
Branded Order Tracking Solution — Ofrezca una mejor experiencia de cliente e impulse más compras repetidas con seguimiento de marca y notificaciones automatizadas. Pruébelo gratis
Mantenga los datos de pedidos, preparación y atención al cliente junto al flujo de seguimiento, con uniones controladas entre ellos. Los eventos de seguimiento explican el movimiento del paquete. Por sí solos, no establecen la fecha de entrega prometida al cliente, el valor del pedido, el resultado de un reembolso ni el historial de asistencia.
Conectar un panel directamente a una API de seguimiento puede funcionar para un pequeño prototipo, pero dificulta controlar la reconstrucción histórica, los reintentos y las definiciones compartidas de métricas. Para los informes operativos recurrentes, conserve los datos antes de presentarlos.
Dónde encaja 17TRACK
17TRACK Tracking API es una opción de fuente pertinente para una integración de datos de seguimiento. Utilice su documentación oficial de la API para confirmar el contrato de integración de su implementación. Valide la autenticación, el registro de envíos, los campos de eventos disponibles, los métodos de entrega de actualizaciones, los límites de uso y la gestión de errores antes de diseñar sobre ellos.
Trate la fuente de seguimiento y el flujo de BI como capas separadas. No dé por supuesto que el acceso a los datos de seguimiento incluye un conector nativo para su almacén de datos o herramienta de BI. Pruebe los transportistas reales, los servicios de envío, los mercados de destino y la configuración de cuenta que pretende utilizar.
1. Defina las preguntas operativas y el nivel de detalle de los informes
Comience por las decisiones que el panel debe respaldar. Un responsable logístico que investigue paquetes retrasados necesita excepciones a nivel de envío. Un analista comercial que compare servicios de envío necesita cohortes de entrega y denominadores coherentes. Son vistas relacionadas, pero no deben construirse a partir de una colección indefinida de estados de seguimiento.
- Rendimiento de las entregas: ¿Qué rutas de envío no cumplen la promesa al cliente?
- Gestión de excepciones: ¿Qué envíos activos requieren investigación?
- Traspasos entre transportistas: ¿Dónde desaparece la visibilidad entre las etapas del transporte?
- Impacto en el cliente: ¿Qué patrones de entrega se asocian con contactos de soporte o reembolsos?
- Salud de la integración: ¿Qué fuentes entregan datos incompletos o desactualizados?
Elija un nivel de detalle principal para los informes: normalmente un paquete físico o envío, no un pedido. Un pedido puede contener varios paquetes y un envío de reemplazo puede existir junto al original. Conserve estas relaciones en lugar de obligar a que cada pedido tenga un único número de seguimiento.
Defina por separado la finalización a nivel de pedido. Por ejemplo, un pedido podría considerarse entregado solo cuando todos los paquetes salientes necesarios hayan sido entregados. Las devoluciones, los paquetes cancelados y los reemplazos requieren un tratamiento explícito para que no distorsionen el denominador.
17RETURNS — Simplifique las devoluciones y los cambios para reducir la carga de trabajo del soporte DTC y la pérdida de ingresos. Más información
2. Cree la identidad del envío antes de importar eventos
No utilice un número de seguimiento como única clave de base de datos. Su interpretación puede depender del transportista y del contexto del envío. Cree un identificador interno de envío y conserve las referencias externas necesarias para conciliar los registros.
| Campo | Propósito | Consideración de diseño |
|---|---|---|
| shipment_id | Identidad interna estable | Manténgalo independiente de los cambios en las referencias externas. |
| order_id y fulfillment_id | Conectar el envío con los registros comerciales | Admite pedidos divididos y envíos de reemplazo. |
| tracking_number y carrier_reference | Identificar el movimiento seguido | Conserve tanto los valores sin procesar como los identificadores estandarizados. |
| shipment_leg_id | Representar una etapa del transporte | Úselo cuando existan referencias internacionales y de última milla separadas. |
| source_system | Explicar la procedencia del registro | Distingue los valores del sistema de pedidos de los valores de la fuente de seguimiento. |
| promised_delivery_at | Medir el rendimiento frente a un compromiso | Conserve la promesa aplicable y su historial de revisiones. |
Cree una tabla puente cuando un envío tenga varias referencias o etapas de seguimiento. Esto permite a los analistas seguir un paquete transfronterizo durante un traspaso sin contarlo como dos envíos entregados.
3. Ingrese las actualizaciones teniendo en cuenta la reproducción y la conciliación
Utilice el mecanismo de actualización compatible con su fuente. Si la entrega de eventos está disponible, reciba las actualizaciones mediante un servicio que valide las solicitudes y escriba las cargas aceptadas en un almacenamiento duradero. Si es necesario realizar consultas periódicas, prográmelas de acuerdo con los límites documentados y los requisitos empresariales de actualidad.
Para la ingesta basada en eventos, confirme la recepción correcta solo después de que la carga se haya guardado de forma segura o se haya colocado en una cola duradera. Mantenga ligero el endpoint receptor; realice las transformaciones costosas posteriormente. Siga los mecanismos documentados de autenticación y verificación de solicitudes de la fuente en lugar de inventar un formato de firma supuesto.
Para las consultas periódicas, almacene puntos de control de recuperación y utilice ventanas de recuperación solapadas cuando la API lo permita. Un solapamiento puede ayudar a capturar actualizaciones retrasadas, pero también requiere deduplicación. No suponga que un cursor de paginación representa un punto de control histórico permanente a menos que la documentación lo indique.
- Conserve la carga original, la marca de tiempo de recepción, el identificador de la fuente y el identificador de ejecución de la ingesta.
- Reintente los fallos transitorios con una espera progresiva controlada y respete los límites de frecuencia documentados.
- Envíe los registros que fallen repetidamente a una cola de revisión en lugar de descartarlos silenciosamente.
- Concilie los envíos seguidos con el sistema de preparación para identificar registros faltantes.
- Realice comprobaciones periódicas de los envíos activos cuyos datos de seguimiento hayan dejado de actualizarse.
Haga que las escrituras sean idempotentes: procesar de nuevo la misma actualización no debe crear un evento lógico adicional. Prefiera un identificador de evento estable y documentado. Si no existe, defina y pruebe una huella digital compuesta usando la identidad del envío, la hora del evento, el código del evento, la ubicación y otros campos relevantes. Conserve los registros sin procesar para poder investigar colisiones o correcciones.
4. Normalice los eventos sin perder su significado
Las descripciones de los transportistas no deben convertirse directamente en categorías de los paneles. Cree una capa de mapeo documentada que traduzca los eventos de origen a un conjunto más reducido de hitos empresariales, conservando al mismo tiempo la descripción y el código originales.
Una taxonomía inicial podría incluir información recibida, aceptado por el transportista, en tránsito, en reparto, entregado, intento de entrega, excepción y movimiento de devolución. Estas son categorías internas propuestas, no una afirmación de que todas las fuentes de seguimiento utilicen los mismos estados.
Mantenga separado el estado del hito de los atributos de excepción. Un envío puede permanecer en tránsito y, al mismo tiempo, tener una excepción relacionada con aduanas. Forzar ambos conceptos en un solo campo dificulta distinguir el progreso físico del riesgo operativo.
Gestione explícitamente la ambigüedad transfronteriza
- Eventos aduaneros: Conserve el significado informado del evento. No interprete toda referencia aduanera como un retraso o un despacho completado.
- Traspasos entre transportistas: Asocie las referencias vinculadas al mismo envío cuando la relación esté verificada. Una nueva referencia no significa necesariamente un nuevo paquete.
- Eventos desconocidos: Manténgalos visibles como registros sin mapear. No fuerce códigos desconocidos a una categoría conveniente.
- Correcciones: Permita que la información posterior revise el estado interpretado sin eliminar las pruebas anteriores.
Versione las reglas de mapeo. Cuando cambie una interpretación, debe poder explicar si un gráfico histórico cambió porque cambió el rendimiento de las entregas o porque cambió la lógica de transformación.
5. Modele por separado la hora del evento, la hora de ingesta y las fechas locales
Almacene al menos la marca de tiempo del evento informado y la marca de tiempo en la que su plataforma recibió el registro. Una marca de tiempo de carga en el almacén también resulta útil para diagnosticar retrasos internos de procesamiento. Estas marcas de tiempo responden a preguntas diferentes.
Utilice, cuando esté disponible, un formato de intercambio que tenga en cuenta el desplazamiento horario. RFC 3339 define un formato de marca de tiempo que incluye UTC o un desplazamiento numérico. Conserve el valor original, normalice a UTC los instantes inequívocos para calcular tiempos transcurridos y derive las fechas locales de los informes mediante una regla de zona horaria explícita.
Si una fuente proporciona una marca de tiempo local sin desplazamiento ni zona horaria fiable, marque esa incertidumbre. No la trate silenciosamente como UTC. Las suposiciones a nivel de país pueden ser insuficientes cuando se aplican varias zonas horarias.
Los eventos que llegan tarde también requieren cuidado. Un evento antiguo recibido hoy no debe sustituir automáticamente un estado de envío más reciente. Derive el estado actual utilizando la semántica documentada de los eventos, las marcas de tiempo y las reglas de corrección, no simplemente la fila insertada más recientemente en la base de datos.
6. Cree modelos de almacén con contratos claros para las métricas
Un modelo práctico separa el historial de eventos de los resúmenes de envíos:
- Hechos de eventos: Una fila por cada evento lógico de seguimiento, con procedencia y atributos normalizados.
- Hechos de envíos: Una fila por envío, con hitos derivados y estado actual.
- Tablas de relaciones: Enlaces entre pedidos, paquetes, etapas de transporte y referencias externas.
- Dimensiones: Transportista, servicio, origen, destino, canal y otros atributos de informes aprobados.
Evite unir los ingresos del pedido directamente a cada evento de seguimiento y después sumarlos. Eso repite el valor del pedido en las filas de eventos. Agregue en el nivel de detalle adecuado o utilice relaciones explícitamente controladas en el modelo semántico.
| Métrica | Definición recomendada | Protección de interpretación |
|---|---|---|
| Duración del tránsito | Marca de tiempo de entrega menos la primera marca de tiempo válida de aceptación por el transportista | Informe las recepciones de aceptación faltantes; no sustituya la creación de la etiqueta sin indicarlo. |
| Tasa de entregas a tiempo | Envíos elegibles entregados antes de la promesa aplicable dividido por los envíos elegibles de la cohorte cuya promesa vence | Defina el límite, la zona horaria, las exclusiones y el tratamiento de los paquetes vencidos no entregados. |
| Incidencia de excepciones | Envíos distintos con una excepción válida dividido por la cohorte de envíos elegibles | Cuente envíos, no mensajes de excepción repetidos. |
| Inactividad del seguimiento | Hora del informe menos la hora del último evento de seguimiento válido | La inactividad es una señal para investigar, no una prueba de que el paquete se haya perdido. |
| Retraso de actualización observado | Hora de recepción menos hora del evento informado | Separe la latencia de la fuente de la incertidumbre de la marca de tiempo y del retraso del almacén. |
Utilice cohortes entregadas para comprender las duraciones de tránsito completadas, pero no las trate como una imagen completa del rendimiento. Los envíos lentos que aún están en tránsito quedan fuera de ese cálculo. Combine las estadísticas de entregas completadas con una vista del envejecimiento de los envíos abiertos y una cohorte de promesas vencidas.
Para las comparaciones entre rutas de envío, muestre el tamaño de la muestra, el nivel de servicio, el destino y el periodo del informe. Las diferencias en la combinación de envíos pueden explicar una aparente brecha de rendimiento entre transportistas. Un panel debe ayudar a investigar esa brecha, no presentar una conclusión causal sin fundamento.
7. Valide el flujo antes de publicar paneles operativos
Pruebe escenarios, no solo respuestas correctas de la API. Incluya una entrega normal, un pedido dividido, un envío de reemplazo, un traspaso entre transportistas, una actualización duplicada, un evento fuera de orden, una zona horaria faltante, un evento relacionado con aduanas, un movimiento de devolución y una corrección tardía.
Para cada escenario, rastree la carga sin procesar a través de los eventos normalizados, los resúmenes de envíos y el panel final. Operaciones debe confirmar que el estado mostrado y la acción recomendada coinciden con las pruebas subyacentes.
- Cobertura: Compare los envíos preparados elegibles con los envíos presentes en el flujo de seguimiento.
- Integridad: Mida los identificadores de envío, horas de eventos, referencias de transportistas y promesas de entrega faltantes.
- Coherencia: Marque para revisión las secuencias de hitos imposibles o sospechosas en lugar de reescribirlas automáticamente.
- Actualidad: Supervise por separado la recepción de la fuente, el procesamiento del almacén y la actualización del panel.
- Reproducibilidad: Reconstruya un periodo de informes a partir de las entradas conservadas y confirme el resultado esperado.
Muestre un indicador de actualidad de los datos en los paneles operativos. Una excepción de paquete y una interrupción de la ingesta pueden parecer similares cuando ambas aparecen como «sin actualización reciente». Los usuarios necesitan suficiente contexto para diferenciarlas.
8. Implemente con responsables, controles de acceso y alertas útiles
Pruebe la integración en un conjunto limitado de rutas de envío que incluya una complejidad transfronteriza representativa. Amplíela después de que la correspondencia de envíos, la interpretación de estados y la conciliación de métricas cumplan los criterios de aceptación acordados. Un piloto compuesto únicamente por entregas fáciles no probará las partes difíciles del modelo.
Limite la ingesta analítica a los campos necesarios para el propósito de los informes. Restrinja el acceso a las referencias de seguimiento y a cualquier información personal, mantenga las credenciales fuera de los informes de BI y establezca procedimientos de conservación y eliminación coherentes con las obligaciones aplicables.
Asigne un responsable a cada alerta. Un flujo de ingesta obsoleto corresponde a ingeniería; un evento sin mapear corresponde al equipo de datos y a los especialistas logísticos; un paquete vencido corresponde al flujo operativo pertinente. Comience con un número reducido de alertas accionables en lugar de generar una notificación para cada escaneo inusual.
La integración estará lista para un uso más amplio cuando un usuario empresarial pueda rastrear un resultado del panel hasta un envío, un evento normalizado y su registro de origen, y comprender qué supuestos determinaron el resultado.
Preguntas frecuentes
¿Necesito datos de seguimiento en tiempo real para los informes de BI?
No necesariamente. Los informes históricos de rendimiento pueden funcionar con actualizaciones programadas, mientras que la gestión activa de excepciones puede necesitar datos más recientes. Defina primero el tiempo de respuesta requerido y después tenga en cuenta los retrasos de actualización de la fuente, la latencia de ingesta, el procesamiento del almacén y la actualización del panel. Una actualización más rápida del panel no puede crear eventos del transportista que aún no hayan sido informados.
¿Pueden los datos de seguimiento medir el tiempo del despacho aduanero?
Solo cuando la fuente proporciona eventos que representan de forma fiable el inicio y el final de la etapa aduanera que desea medir. El intervalo entre dos escaneos no constituye evidencia suficiente del tiempo de procesamiento aduanero. Cuando los límites no estén claros, etiquete la métrica como un intervalo observado en lugar de una duración confirmada del despacho.
¿Cómo deben gestionarse varios números de seguimiento para un pedido?
Modele por separado la relación entre pedido y envío de las relaciones entre envío y referencia de seguimiento. Varios paquetes pueden pertenecer a un pedido, mientras que varias referencias pueden describir distintas etapas del recorrido de un paquete. Mantener separadas estas relaciones evita contar envíos duplicados e informar incorrectamente de la finalización de pedidos.
¿Debo utilizar consultas periódicas o actualizaciones basadas en eventos?
Utilice los mecanismos compatibles con la fuente y selecciónelos según los requisitos de actualidad y fiabilidad. La entrega basada en eventos puede reducir las solicitudes repetidas, mientras que las consultas periódicas pueden permitir la recuperación o conciliación cuando estén disponibles. Ninguno de los dos enfoques elimina la necesidad de deduplicación, reintentos, supervisión y recuperación de actualizaciones perdidas.
¿Pueden los datos de seguimiento explicar por qué aumentaron los reembolsos?
Pueden respaldar una investigación cuando se combinan con registros de reembolsos y soporte mediante identificadores y ventanas temporales adecuados. Por sí solos, no pueden establecer causalidad. Compruebe los motivos de los reembolsos, los problemas de los productos, los segmentos de clientes, los servicios de envío y otros factores relevantes antes de atribuir el aumento al rendimiento de las entregas.
Fuentes
- 17TRACK Tracking API — punto de partida oficial para evaluar 17TRACK como fuente de datos de seguimiento.
- 17TRACK API documentation — referencia para validar el contrato de implementación y el comportamiento de integración compatible.
- RFC 3339: Date and Time on the Internet: Timestamps — representación de marcas de tiempo, UTC y convenciones de desplazamiento numérico.