Come integrare i dati di tracciamento delle spedizioni nei sistemi di BI per l'e-commerce transfrontaliero
Per integrare i dati di tracciamento delle spedizioni nei sistemi BI per l'e-commerce transfrontaliero, raccogli gli aggiornamenti di tracciamento tramite un'API o un feed di eventi supportato, conserva i record originali, normalizza gli eventi dei corrieri e collega ogni spedizione ai dati degli ordini. Quindi crea modelli nel data warehouse che calcolino le prestazioni di consegna, le eccezioni e l'aggiornamento dei dati prima di esporre tali modelli a dashboard. La scelta progettuale più importante consiste nel separare ciò che è accaduto a un pacco dal momento in cui i tuoi sistemi ne sono venuti a conoscenza.
Questa guida è destinata agli ingegneri dei dati, ai team di analisi e ai responsabili delle operazioni logistiche che stanno creando questa pipeline. L'ingegneria dovrebbe occuparsi dell'acquisizione e dell'affidabilità; le operazioni dovrebbero definire le tappe della spedizione e le regole sulle eccezioni; il team di analisi dovrebbe essere responsabile delle definizioni delle metriche. Senza queste definizioni condivise, anche un'integrazione tecnicamente riuscita può produrre report fuorvianti.
Costruisci una pipeline di dati, non una connessione tra dashboard e API
Un'architettura di riferimento utile è:
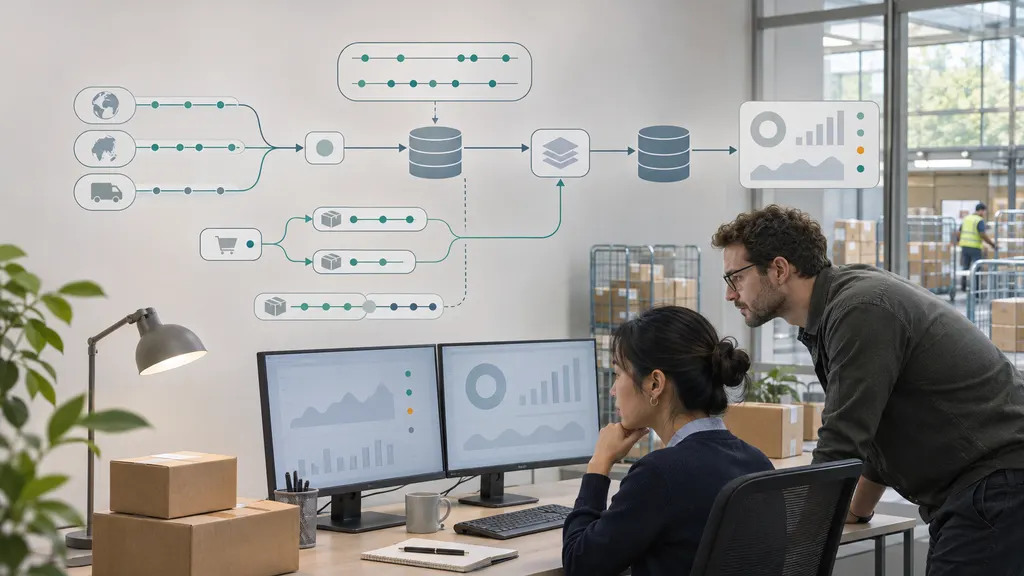
Fonte di tracciamento → servizio di acquisizione → archiviazione persistente dei dati grezzi → trasformazione e convalida → data warehouse analitico → modello semantico BI → dashboard e avvisi
Mantieni i dati relativi agli ordini, all'evasione e al servizio clienti insieme alla pipeline di tracciamento, con join controllati tra di essi. Gli eventi di tracciamento spiegano il movimento del pacco. Da soli, però, non stabiliscono la data di consegna promessa al cliente, il valore dell'ordine, l'esito di un rimborso o la cronologia dell'assistenza.
Collegare una dashboard direttamente a un'API di tracciamento può funzionare per un piccolo prototipo, ma rende più difficile controllare la ricostruzione storica, i nuovi tentativi e le definizioni condivise delle metriche. Per i report operativi ricorrenti, rendi persistenti i dati prima di presentarli.
Dove si colloca 17TRACK
17TRACK Tracking API è un'opzione di origine pertinente per un'integrazione dei dati di tracciamento. Utilizza la documentazione ufficiale dell'API per confermare il contratto di integrazione della tua implementazione. Convalida l'autenticazione, la registrazione delle spedizioni, i campi degli eventi disponibili, i metodi di consegna degli aggiornamenti, i limiti di utilizzo e la gestione degli errori prima di progettare l'integrazione.
Tratta la fonte di tracciamento e la pipeline BI come livelli separati. Non presumere che l'accesso ai dati di tracciamento includa un connettore nativo per il tuo data warehouse o strumento BI. Testa gli effettivi corrieri, servizi di spedizione, mercati di destinazione e configurazioni dell'account che intendi utilizzare.
1. Definisci le domande operative e il livello di dettaglio dei report
Inizia dalle decisioni che la dashboard deve supportare. Un responsabile della logistica che indaga sui pacchi in ritardo ha bisogno di eccezioni a livello di spedizione. Un analista commerciale che confronta i servizi di spedizione ha bisogno di coorti di consegna e denominatori coerenti. Sono viste correlate, ma non dovrebbero essere create a partire da una raccolta non definita di stati di tracciamento.
- Prestazioni di consegna: quali rotte di spedizione non rispettano la promessa al cliente?
- Gestione delle eccezioni: quali spedizioni attive richiedono un'indagine?
- Passaggi tra corrieri: dove scompare la visibilità tra le fasi del trasporto?
- Impatto sul cliente: quali modelli di consegna sono associati a contatti con l'assistenza o a rimborsi?
- Stato dell'integrazione: quali fonti forniscono dati incompleti o obsoleti?
Scegli un livello di dettaglio principale per i report: di solito un pacco fisico o una spedizione, non un ordine. Un ordine può contenere diversi pacchi e una spedizione sostitutiva può esistere insieme a quella originale. Mantieni queste relazioni invece di obbligare ogni ordine a essere associato a un solo numero di tracciamento.
Definisci separatamente il completamento a livello di ordine. Ad esempio, un ordine potrebbe essere considerato consegnato solo quando tutti i pacchi in uscita richiesti sono stati consegnati. Resi, pacchi annullati e sostituzioni richiedono una gestione esplicita affinché non distorcano il denominatore.
2. Crea l'identità della spedizione prima di importare gli eventi
Non usare il numero di tracciamento come unica chiave del database. La sua interpretazione può dipendere dal corriere e dal contesto della spedizione. Crea un identificativo interno della spedizione e conserva i riferimenti esterni necessari per riconciliare i record.
| Campo | Scopo | Considerazione progettuale |
|---|---|---|
| shipment_id | Identità interna stabile | Mantienilo indipendente dalle modifiche ai riferimenti esterni. |
| order_id e fulfillment_id | Collegare la spedizione ai record commerciali | Supporta gli ordini suddivisi e le spedizioni sostitutive. |
| tracking_number e carrier_reference | Identificare il movimento tracciato | Conserva sia i valori grezzi sia gli eventuali identificativi standardizzati. |
| shipment_leg_id | Rappresentare una fase del trasporto | Usalo quando esistono riferimenti separati per la tratta internazionale e per l'ultimo miglio. |
| source_system | Spiegare la provenienza del record | Distingui i valori del sistema degli ordini da quelli della fonte di tracciamento. |
| promised_delivery_at | Misurare le prestazioni rispetto a un impegno | Conserva la promessa applicabile e la cronologia delle revisioni. |
Crea una tabella ponte quando una spedizione ha più riferimenti o tratte di tracciamento. In questo modo gli analisti possono seguire un pacco transfrontaliero durante un passaggio senza conteggiarlo come due spedizioni consegnate.
3. Acquisisci gli aggiornamenti tenendo conto della riproduzione e della riconciliazione
Utilizza il meccanismo di aggiornamento supportato dalla tua fonte. Se è disponibile la consegna degli eventi, ricevi gli aggiornamenti tramite un servizio che convalidi le richieste e scriva i payload accettati in un'archiviazione persistente. Se è necessario il polling, pianifica le richieste in base ai limiti documentati e ai requisiti di aggiornamento dei dati aziendali.
Per l'acquisizione basata sugli eventi, conferma la ricezione riuscita solo dopo che il payload è stato salvato in modo sicuro o inserito in una coda persistente. Mantieni leggero l'endpoint di ricezione; esegui le trasformazioni costose a valle. Segui i meccanismi documentati dalla fonte per l'autenticazione e la verifica delle richieste, invece di inventare un formato di firma presunto.
Per il polling, archivia i checkpoint di recupero e usa finestre di recupero sovrapposte quando l'API lo consente. Una sovrapposizione può aiutare a catturare gli aggiornamenti ritardati, ma richiede anche la deduplicazione. Non presumere che un cursore di paginazione rappresenti un checkpoint storico permanente, a meno che la documentazione non lo dichiari.
- Conserva il payload originale, il timestamp di ricezione, l'identificativo della fonte e l'identificativo dell'esecuzione di acquisizione.
- Ripeti i tentativi in caso di errori transitori con un backoff controllato e rispetta i limiti di frequenza documentati.
- Instrada i record che falliscono ripetutamente verso una coda di revisione invece di scartarli silenziosamente.
- Riconcilia le spedizioni tracciate con il sistema di evasione per identificare le registrazioni mancanti.
- Esegui controlli periodici sulle spedizioni attive i cui dati di tracciamento hanno smesso di aggiornarsi.
Rendi le scritture idempotenti: elaborare nuovamente lo stesso aggiornamento non dovrebbe creare un ulteriore evento logico. Preferisci un identificativo stabile dell'evento, se documentato. Se non esiste, definisci e testa un'impronta composita utilizzando l'identità della spedizione, l'ora dell'evento, il codice dell'evento, la posizione e altri campi pertinenti. Conserva i record grezzi affinché collisioni o correzioni possano essere analizzate.
4. Normalizza gli eventi senza perderne il significato
Le descrizioni dei corrieri non dovrebbero diventare direttamente categorie della dashboard. Crea un livello di mappatura documentato che traduca gli eventi della fonte in un insieme più ristretto di tappe aziendali, conservando al contempo la descrizione e il codice originali.
Una tassonomia iniziale potrebbe includere informazioni ricevute, accettato dal corriere, in transito, in consegna, consegnato, tentativo di consegna, eccezione e movimento di reso. Si tratta di categorie interne proposte, non dell'affermazione che ogni fonte di tracciamento utilizzi gli stessi stati.
Mantieni separato lo stato della tappa dagli attributi dell'eccezione. Una spedizione può rimanere in transito e allo stesso tempo presentare un'eccezione relativa alla dogana. Forzare entrambi i concetti in un unico campo rende difficile distinguere il progresso fisico dal rischio operativo.
Gestisci esplicitamente l'ambiguità transfrontaliera
- Eventi doganali: conserva il significato riportato dell'evento. Non interpretare ogni riferimento doganale come un ritardo o come uno sdoganamento completato.
- Passaggi tra corrieri: associa i riferimenti collegati alla stessa spedizione quando la relazione è verificata. Un nuovo riferimento non significa necessariamente un nuovo pacco.
- Eventi sconosciuti: mantienili visibili come record non mappati. Non forzare codici non familiari in una categoria conveniente.
- Correzioni: consenti alle informazioni successive di aggiornare lo stato interpretato senza eliminare le prove precedenti.
Versiona le regole di mappatura. Quando cambia un'interpretazione, devi poter spiegare se un grafico storico è cambiato perché sono cambiate le prestazioni di consegna o perché è cambiata la logica di trasformazione.
5. Modella separatamente l'ora dell'evento, l'ora di acquisizione e le date locali
Archivia almeno il timestamp dell'evento riportato e il timestamp in cui la tua piattaforma ha ricevuto il record. Un timestamp del caricamento nel data warehouse è inoltre utile per diagnosticare i ritardi di elaborazione interni. Questi timestamp rispondono a domande diverse.
Quando disponibile, utilizza un formato di interscambio che tenga conto dell'offset. RFC 3339 definisce un formato di timestamp che include UTC o un offset numerico. Conserva il valore originale, normalizza gli istanti non ambigui in UTC per i calcoli della durata e ricava le date locali dei report utilizzando una regola esplicita sul fuso orario.
Se una fonte fornisce un timestamp locale senza offset o senza un fuso orario affidabile, indica tale incertezza. Non considerarlo silenziosamente come UTC. Le ipotesi a livello nazionale possono essere insufficienti quando si applicano più fusi orari.
Anche gli eventi ricevuti in ritardo richiedono attenzione. Un evento precedente ricevuto oggi non dovrebbe sostituire automaticamente uno stato di spedizione più recente. Ricava lo stato corrente utilizzando semantica degli eventi, timestamp e regole di correzione documentati, non semplicemente la riga del database inserita più di recente.
6. Crea modelli nel data warehouse con contratti chiari per le metriche
Un modello pratico separa la cronologia degli eventi dai riepiloghi delle spedizioni:
- Tabella dei fatti degli eventi: una riga per ogni evento logico di tracciamento, con provenienza e attributi normalizzati.
- Tabella dei fatti delle spedizioni: una riga per ogni spedizione, contenente le tappe derivate e lo stato corrente.
- Tabelle delle relazioni: collegamenti tra ordini, pacchi, tratte di trasporto e riferimenti esterni.
- Dimensioni: corriere, servizio, origine, destinazione, canale e altri attributi di report approvati.
Evita di unire direttamente i ricavi degli ordini a ogni evento di tracciamento per poi sommarli. In questo modo il valore dell'ordine viene ripetuto nelle righe degli eventi. Aggrega al livello di dettaglio appropriato oppure usa relazioni esplicitamente controllate nel modello semantico.
| Metrica | Definizione consigliata | Garanzia interpretativa |
|---|---|---|
| Durata del transito | Timestamp di consegna meno il primo timestamp qualificante di accettazione da parte del corriere | Segnala le scansioni di accettazione mancanti; non sostituirle con la creazione dell'etichetta senza dichiararlo. |
| Tasso di consegna puntuale | Spedizioni idonee consegnate entro la promessa applicabile divise per le spedizioni idonee nella coorte con scadenza della promessa | Definisci cutoff, fuso orario, esclusioni e trattamento dei pacchi scaduti non consegnati. |
| Incidenza delle eccezioni | Spedizioni distinte con un'eccezione qualificante divise per la coorte di spedizioni idonee | Conta le spedizioni, non i messaggi di eccezione ripetuti. |
| Inattività del tracciamento | Ora del report meno l'ora dell'ultimo evento di tracciamento qualificante | L'inattività è un segnale da analizzare, non la prova che un pacco sia perso. |
| Ritardo di aggiornamento osservato | Ora di ricezione meno ora dell'evento riportato | Separa la latenza della fonte dall'incertezza del timestamp e dal ritardo del data warehouse. |
Utilizza le coorti delle consegne completate per comprendere le durate di transito completate, ma non considerarle l'intero quadro delle prestazioni. Le spedizioni lente ancora in transito sono assenti da quel calcolo. Affianca alle statistiche sulle consegne completate una vista sull'anzianità delle spedizioni aperte e una coorte con scadenza della promessa.
Per i confronti tra rotte di spedizione, mostra la dimensione del campione, il livello del servizio, la destinazione e il periodo del report. Le differenze nella composizione delle spedizioni possono spiegare un apparente divario nelle prestazioni dei corrieri. Una dashboard dovrebbe aiutare a indagare tale divario, non presentare una conclusione causale priva di supporto.
7. Convalida la pipeline prima di pubblicare le dashboard operative
Testa gli scenari, non solo le risposte API riuscite. Includi una consegna normale, un ordine suddiviso, una spedizione sostitutiva, un passaggio tra corrieri, un aggiornamento duplicato, un evento fuori ordine, un fuso orario mancante, un evento relativo alla dogana, un movimento di reso e una correzione tardiva.
Per ogni scenario, segui il payload grezzo attraverso gli eventi normalizzati, i riepiloghi delle spedizioni e la dashboard finale. Le operazioni devono confermare che lo stato visualizzato e l'azione consigliata corrispondano alle prove sottostanti.
- Copertura: confronta le spedizioni evase idonee con quelle presenti nella pipeline di tracciamento.
- Completezza: misura gli identificativi delle spedizioni, gli orari degli eventi, i riferimenti dei corrieri e le promesse di consegna mancanti.
- Coerenza: segnala per la revisione le sequenze di tappe impossibili o sospette invece di riscriverle automaticamente.
- Freschezza: monitora separatamente la ricezione dalla fonte, l'elaborazione nel data warehouse e l'aggiornamento della dashboard.
- Riproducibilità: ricostruisci un periodo di report dagli input conservati e conferma il risultato atteso.
Mostra un indicatore di aggiornamento dei dati nelle dashboard operative. Un'eccezione di un pacco e un'interruzione del feed di acquisizione possono sembrare simili quando entrambi appaiono come “nessun aggiornamento recente”. Gli utenti hanno bisogno di un contesto sufficiente per distinguerli.
8. Implementa con responsabilità, controlli di accesso e avvisi utili
Sperimenta l'integrazione su un insieme limitato di rotte di spedizione che includa una complessità transfrontaliera rappresentativa. Espandi l'ambito dopo che la corrispondenza delle spedizioni, l'interpretazione degli stati e la riconciliazione delle metriche avranno raggiunto i criteri di accettazione concordati. Un progetto pilota composto solo da consegne semplici non testerà le parti più difficili del modello.
Limita l'acquisizione analitica ai campi necessari per lo scopo del report. Limita l'accesso ai riferimenti di tracciamento e alle eventuali informazioni personali, mantieni le credenziali fuori dai report BI e stabilisci procedure di conservazione ed eliminazione coerenti con gli obblighi applicabili.
Assegna un responsabile a ogni avviso. Un feed di acquisizione obsoleto è di competenza dell'ingegneria; un evento non mappato appartiene al team dei dati e agli specialisti della logistica; un pacco in ritardo appartiene al relativo flusso di lavoro operativo. Inizia con un numero ridotto di avvisi attuabili invece di generare una notifica per ogni scansione insolita.
L'integrazione è pronta per un utilizzo più ampio quando un utente aziendale può risalire dal risultato di una dashboard a una spedizione, a un evento normalizzato e al relativo record di origine, comprendendo quali ipotesi hanno influenzato il risultato.
FAQ
Ho bisogno di dati di tracciamento in tempo reale per i report BI?
Non necessariamente. I report sulle prestazioni storiche possono funzionare con aggiornamenti pianificati, mentre la gestione delle eccezioni attive può richiedere dati più aggiornati. Definisci prima il tempo di risposta necessario, quindi considera i ritardi negli aggiornamenti della fonte, la latenza di acquisizione, l'elaborazione nel data warehouse e l'aggiornamento della dashboard. Un aggiornamento più rapido della dashboard non può creare eventi del corriere che non sono stati riportati.
I dati di tracciamento possono misurare il tempo di sdoganamento?
Solo quando la fonte fornisce eventi che rappresentano in modo affidabile l'inizio e la fine della fase doganale che desideri misurare. Un intervallo tra due scansioni non costituisce una prova sufficiente del tempo di elaborazione doganale. Quando i confini non sono chiari, definisci la metrica come intervallo osservato anziché come durata di sdoganamento confermata.
Come devono essere gestiti più numeri di tracciamento per un ordine?
Modella separatamente la relazione ordine-spedizione e le relazioni spedizione-riferimento di tracciamento. Più pacchi possono appartenere a un ordine, mentre più riferimenti possono descrivere tratte diverse del viaggio di un singolo pacco. Mantenere separate queste relazioni impedisce il conteggio duplicato delle spedizioni e report errati sul completamento degli ordini.
Devo utilizzare il polling o gli aggiornamenti basati sugli eventi?
Utilizza i meccanismi supportati dalla fonte e selezionali in base ai requisiti di aggiornamento e affidabilità. La consegna basata sugli eventi può ridurre le richieste ripetute, mentre il polling può supportare il recupero o la riconciliazione quando disponibile. Nessuno dei due approcci elimina la necessità di deduplicazione, nuovi tentativi, monitoraggio e ripristino dagli aggiornamenti persi.
I dati di tracciamento possono spiegare perché sono aumentati i rimborsi?
Possono supportare un'indagine quando vengono collegati ai record dei rimborsi e dell'assistenza mediante identificativi e finestre temporali appropriati. Da soli non possono stabilire un rapporto causale. Controlla i motivi dei rimborsi, i problemi relativi ai prodotti, i segmenti dei clienti, i servizi di spedizione e altri fattori pertinenti prima di attribuire l'aumento alle prestazioni di consegna.
Fonti
- 17TRACK Tracking API — punto di partenza ufficiale per valutare 17TRACK come fonte di dati di tracciamento.
- Documentazione dell'API 17TRACK — riferimento per convalidare il contratto di implementazione e il comportamento di integrazione supportato.
- RFC 3339: Date e ore su Internet: timestamp — rappresentazione dei timestamp, UTC e convenzioni sugli offset numerici.


