Simulation du système logistique
Qu’est-ce que la simulation d’un système logistique ?
La simulation d’un système logistique consiste à utiliser un modèle informatique pour représenter la manière dont les marchandises, les commandes, les informations et les ressources opérationnelles se déplacent et interagissent au sein d’un système logistique au fil du temps. Elle permet aux analystes de tester des règles de fonctionnement, des changements de capacité et des perturbations sans apporter d’abord ces changements à l’exploitation physique. Ses applications comprennent la planification des entrepôts, le réapprovisionnement des stocks, les réseaux de transport, l’exécution des commandes de commerce électronique et le traitement des retours.
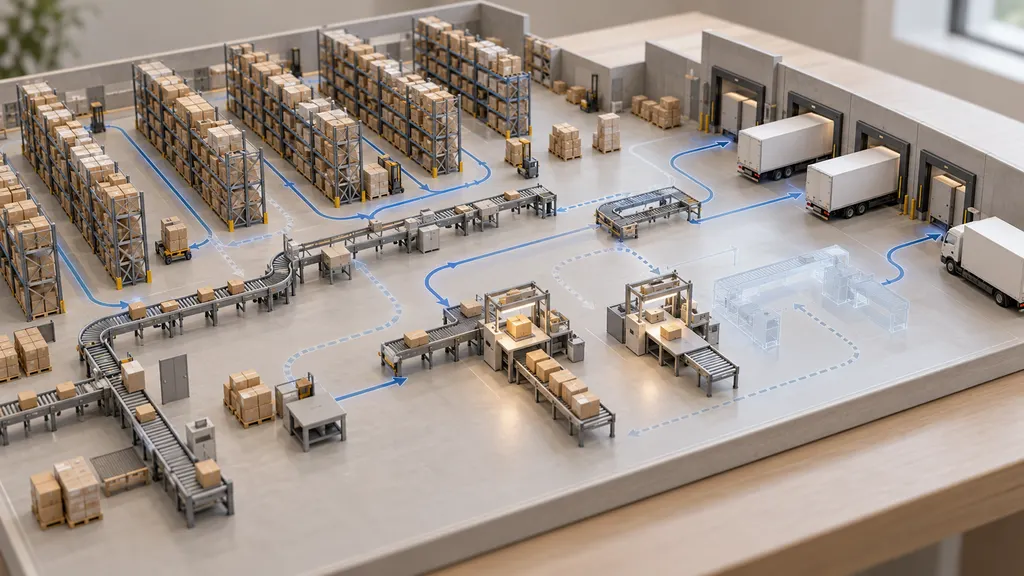
Une simulation représente certains aspects d’un système réel ou envisagé, plutôt que d’en reproduire chaque détail. Par exemple, un modèle d’entrepôt peut représenter les arrivées de commandes, les files d’attente de préparation, les postes d’emballage et les heures de collecte des transporteurs, tout en excluant les activités qui n’ont pas d’incidence sur la question étudiée. Ses résultats décrivent ce qui se produit dans le cadre d’hypothèses définies ; ils ne constituent pas des prévisions garanties des performances futures.
Portée dans la logistique et le commerce électronique
Le système modélisé peut être une seule activité, comme le tri des colis, ou un réseau connecté de fournisseurs, d’entrepôts, de services de transport et de destinations de livraison. Le choix des limites est important, car une amélioration apportée à une activité peut créer une contrainte ailleurs. Augmenter la capacité de préparation, par exemple, peut simplement déplacer la file d’attente vers l’emballage si la capacité d’emballage reste inchangée.
Dans le commerce électronique, la simulation peut relier la demande des clients à la disponibilité des stocks, au lancement des commandes, à la capacité d’exécution, aux calendriers d’expédition et aux engagements de livraison. Une commande et une expédition ne sont pas nécessairement équivalentes : une commande peut être divisée en plusieurs expéditions. Un modèle utile conserve cette distinction chaque fois que l’exécution fractionnée influe sur la charge de travail, les coûts de transport ou la qualité de service.
Dans la logistique transfrontalière, le processus modélisé peut inclure la préparation à l’exportation, le transport international, le traitement douanier, la manutention à destination et la livraison finale. Le traitement douanier doit être représenté à l’aide d’éléments justificatifs pertinents et d’hypothèses explicites. Un modèle ne peut pas établir si les marchandises remplissent légalement les conditions de mainlevée ni remplacer les exigences douanières applicables.
Les utilisateurs peuvent rencontrer ce terme dans les études de conception d’entrepôts, les rapports d’ingénierie logistique, les propositions de réseaux de distribution, les projets de planification des capacités et les évaluations d’amélioration opérationnelle. Dans ces contextes, la question essentielle n’est pas de savoir si le modèle semble réaliste, mais s’il est suffisamment crédible pour la décision qu’il doit soutenir.
Principales approches de modélisation
Plusieurs approches de simulation établies peuvent être appliquées à la logistique. Elles décrivent différentes perspectives de modélisation et ne s’excluent pas nécessairement mutuellement.
| Approche | Représentation du système | Exemple d’utilisation logistique |
|---|---|---|
| Simulation à événements discrets | L’état du système change lorsque des événements se produisent, tels que des arrivées, des fins de service ou des départs. | Examiner les files d’attente au niveau des ressources de préparation, d’emballage, de chargement ou de tri. |
| Simulation à base d’agents | Des entités individuelles suivent des règles comportementales et interagissent avec d’autres entités ou leur environnement. | Étudier les interactions entre les véhicules, les employés ou les installations gérées indépendamment. |
| Dynamique des systèmes | Les stocks agrégés, les flux, les boucles de rétroaction et les délais décrivent l’évolution au fil du temps. | Étudier les réactions des stocks et des arriérés aux politiques de réapprovisionnement ou aux variations de la demande. |
| Simulation de Monte-Carlo | Des échantillonnages répétés à partir de distributions de probabilité permettent d’explorer l’incertitude des résultats calculés. | Estimer l’intervalle des délais totaux ou des coûts dans des conditions d’entrée incertaines. |
Ces approches se recoupent en pratique. Un modèle à événements discrets peut utiliser un échantillonnage aléatoire pour générer les durées de manutention, tandis qu’un modèle de réseau plus vaste peut combiner des flux de stocks agrégés avec des processus détaillés d’installation. L’échantillonnage aléatoire seul ne permet pas nécessairement de représenter les files d’attente, la concurrence entre les ressources ou la séquence des événements opérationnels.
Contenu d’une simulation logistique
Un modèle traduit une question opérationnelle en un ensemble défini d’entités, de ressources, de règles et de mesures. Les principaux composants comprennent :
- Entités : les éléments qui se déplacent dans le modèle, tels que les commandes, les expéditions, les palettes, les conteneurs, les véhicules ou les retours.
- Ressources : la capacité nécessaire à l’exécution du travail, notamment les employés, les équipements, les quais de chargement, les emplacements de stockage et la capacité de transport.
- Activités et événements : la préparation, l’inspection, l’emballage, le chargement, le départ, l’arrivée ou l’achèvement d’une étape de traitement.
- Files d’attente et tampons : les endroits où le travail ou les marchandises attendent parce que l’activité suivante ne peut pas commencer.
- Règles de fonctionnement : les priorités des commandes, l’allocation des stocks, les déclencheurs de réapprovisionnement, les horaires des équipes, les décisions d’acheminement et les heures limites d’expédition.
- Données d’entrée et incertitude : les profils de demande, les durées de traitement, les temps de transit, la disponibilité des équipements et les autres conditions pertinentes pour l’étude.
- Résultats : les mesures utilisées pour comparer les scénarios, telles que le débit, le temps d’attente, l’arriéré, l’utilisation des ressources et le coût dans le cadre des hypothèses énoncées.
Le niveau de détail requis dépend de la décision. Une étude des effectifs quotidiens d’un entrepôt peut nécessiter les profils d’équipes et les arrivées de commandes heure par heure. Une étude de la capacité de distribution à long terme peut plutôt utiliser des hypothèses agrégées concernant la demande et le transport. Les détails supplémentaires ne sont utiles que s’ils améliorent sensiblement la capacité du modèle à répondre à la question.
Fonctionnement d’une étude de simulation
- Définir la décision et les mesures de performance. Préciser ce qui est comparé et la manière dont les solutions seront évaluées. Par exemple, une étude peut comparer si la modification des règles de lancement des commandes ou l’ajout d’une capacité d’emballage réduit les expéditions manquées avant l’heure limite.
- Définir les limites du système. Identifier les installations, les processus, l’horizon temporel et les conditions externes inclus. Consigner les exclusions, en particulier lorsqu’elles peuvent influencer l’interprétation.
- Élaborer un modèle conceptuel. Décrire les flux de processus, les contraintes de ressources, les règles de file d’attente et les hypothèses avant de mettre en œuvre le modèle informatique. Le personnel opérationnel peut aider à identifier les étapes manquantes et les règles irréalistes.
- Préparer les données d’entrée. Vérifier les horodatages, les unités, les données manquantes, les événements en double et les différences entre les activités planifiées et réelles. Distinguer les opérations normales des perturbations lorsque cette distinction est importante.
- Construire et vérifier le modèle. Vérifier que l’implémentation suit la conception conceptuelle. Suivre des entités individuelles, tester des cas simplifiés et confirmer que les quantités de stocks et d’expéditions restent cohérentes.
- Valider pour l’utilisation prévue. Comparer le comportement du modèle aux observations pertinentes et aux connaissances opérationnelles. Évaluer si le modèle est suffisamment précis pour la décision concernée, plutôt que de considérer la validation comme une preuve d’exactitude universelle.
- Concevoir et exécuter les expériences. Comparer une référence à des solutions définies. Maintenir constantes les hypothèses sans rapport, prévoir une durée d’exécution suffisante et effectuer des exécutions répétées lorsque la variation aléatoire influe sur les résultats.
- Interpréter et documenter les résultats. Présenter les hypothèses, l’incertitude, les compromis et les limites avec les résultats. Conserver suffisamment de détails pour qu’un autre analyste puisse comprendre comment les conclusions ont été obtenues.
Ce processus est itératif. Des résultats inattendus peuvent révéler une erreur de programmation, une hypothèse incorrecte, un problème de données ou une interaction opérationnelle réelle. Chaque possibilité doit faire l’objet d’une investigation plutôt que d’une acceptation ou d’un rejet automatique des résultats.
Données et conception expérimentale
La qualité des données d’entrée ne se résume pas à la sélection d’une durée moyenne de traitement. Deux opérations ayant la même durée moyenne peuvent produire des files d’attente différentes si leur variabilité diffère. Une demande concentrée avant une heure limite d’expédition peut également générer une charge de travail différente de la même demande totale répartie uniformément sur la journée.
Les dépendances sont également importantes. Un volume de commandes plus élevé peut coïncider avec une composition différente des produits, des commandes plus importantes ou des retards de manutention liés à la congestion. Échantillonner chaque entrée indépendamment peut produire des combinaisons irréalistes lorsque ces relations sont importantes. Les analystes doivent préserver les relations significatives lorsque les éléments disponibles le justifient et expliciter les hypothèses dans le cas contraire.
Les conditions initiales doivent être traitées explicitement. Un modèle qui commence avec une file d’attente d’entrepôt vide peut sous-estimer l’attente pendant une exploitation établie. Selon l’étude, les analystes peuvent initialiser le modèle à partir d’un état observé ou utiliser une période de montée en régime avant de recueillir les mesures de performance. Une opération courte et limitée dans le temps, telle qu’une fenêtre d’expédition précise, peut au contraire nécessiter un arriéré initial défini délibérément.
Pour les modèles stochastiques, les exécutions répétées aident à distinguer les effets d’un changement proposé de la variation aléatoire. Les résultats doivent préciser la période de mesure et résumer l’incertitude pertinente, plutôt que de présenter une seule exécution comme une réponse définitive. L’analyse de sensibilité examine ensuite si les conclusions changent lorsque les entrées ou les hypothèses incertaines varient.
Interprétation des mesures de performance
| Mesure | Ce qu’elle montre | Point de contrôle pour l’interprétation |
|---|---|---|
| Débit | Travail réalisé pendant une période définie. | Préciser si l’unité correspond à des commandes, des expéditions, des colis, des palettes ou une autre entité. |
| Temps de cycle | Temps écoulé entre des événements de début et de fin définis. | Indiquer les limites et préciser si le temps d’attente est inclus. |
| Utilisation des ressources | Proportion modélisée de la capacité disponible occupée. | Une utilisation élevée ne suffit pas à établir que la performance de service est acceptable. |
| Longueur de file ou arriéré | Travail en attente de traitement. | Examiner les pics et le travail restant en fin de période, et pas seulement les moyennes. |
| Respect de l’heure limite | Proportion du travail admissible terminé avant une échéance définie. | Définir l’admissibilité et l’événement exact marquant l’achèvement. |
| Coût modélisé | Coût calculé à partir des activités et des tarifs inclus. | Identifier les coûts exclus et distinguer les estimations des dépenses réelles. |
Les mesures doivent être interprétées ensemble. Un débit plus élevé peut aller de pair avec des temps d’attente plus longs, et une baisse des coûts de personnel peut coïncider avec davantage d’heures limites manquées. La simulation rend ces compromis visibles ; elle ne décide pas quel compromis une organisation doit accepter.
Applications illustratives
Planification des expéditions en entrepôt
Un détaillant peut modéliser les commandes arrivant tout au long d’une journée de travail, les équipes de préparation alimentant des postes d’emballage partagés. Le modèle peut comparer une capacité de préparation supplémentaire, une capacité d’emballage supplémentaire et des priorités révisées de lancement des commandes. Si l’emballage constitue la contrainte déterminante, augmenter uniquement la préparation peut accroître la file d’attente d’emballage sans augmenter le nombre d’expéditions prêtes à être collectées. Il s’agit d’un exemple hypothétique et non d’un résultat commercial rapporté.
Exécution transfrontalière
Un vendeur de commerce électronique peut comparer des itinéraires d’exécution avec différents calendriers de transport et différentes hypothèses de durée de traitement. Un modèle utile peut distinguer le temps d’attente avant le départ, le temps de transit et le temps d’attente du traitement à destination. Il peut tester la manière dont les retards se répercutent sur les estimations de livraison, mais ses résultats restent conditionnés par l’itinéraire, les caractéristiques de l’expédition et les hypothèses de traitement représentés.
Traitement des retours
Une opération de retours peut modéliser la réception, l’inspection, la décision d’affectation et la remise en stock comme des activités distinctes. Les résultats de l’inspection peuvent orienter les articles vers différents parcours de traitement. Le modèle peut examiner la charge de travail et la disponibilité des stocks, tandis que le calendrier des remboursements doit être représenté séparément s’il suit des règles commerciales différentes. La réception d’un retour n’établit pas à elle seule qu’un remboursement a été effectué ou qu’un article est prêt à être revendu.
Termes associés et limites importantes
| Terme associé | Relation avec la simulation d’un système logistique |
|---|---|
| Optimisation | Recherche une solution privilégiée selon des objectifs et des contraintes définis. La simulation évalue le comportement dans des scénarios spécifiés ; les deux peuvent être combinées. |
| Prévision | Estime les conditions futures, comme la demande. Les prévisions peuvent fournir les données d’entrée d’une simulation, mais une simulation n’est pas automatiquement une prévision. |
| Jumeau numérique | Représentation numérique connectée à un équivalent physique. La simulation peut en être un composant, mais une simulation autonome ne doit pas automatiquement être qualifiée de jumeau numérique. |
| Suivi | Enregistre ou rapporte les événements observés d’une expédition. Les données de suivi peuvent renseigner un modèle, tandis que la simulation génère un comportement dans des conditions modélisées. |
| Modèle analytique | Utilise des relations mathématiques pour calculer des résultats. La simulation exécute plutôt un comportement modélisé ou échantillonne des résultats ; l’une ou l’autre approche peut convenir à une question donnée. |
Limites et contrôles de fiabilité
Une animation visuellement détaillée ne prouve pas qu’un modèle est valide. La vérification vise à déterminer si le modèle a été correctement mis en œuvre ; la validation vise à déterminer s’il est suffisamment précis pour l’objectif prévu. Un modèle peut réussir les contrôles d’implémentation tout en omettant une contrainte opérationnelle importante pour la décision.
Avant de s’appuyer sur les résultats, vérifier si la référence est crédible, si les solutions utilisent des hypothèses comparables et si les conclusions restent pertinentes lorsque les données d’entrée plausibles varient. Vérifier également l’existence de tampons illimités irréalistes, de pauses d’équipe manquantes, d’une capacité de transport indisponible ou de flux d’expéditions dépassant la disponibilité des stocks.
Les résultats doivent rester traçables jusqu’à la version du modèle, l’ensemble de données d’entrée, les règles de fonctionnement et les paramètres de l’expérience. Lorsqu’un processus change de manière importante, la validation précédente peut ne plus soutenir la même utilisation. La simulation doit donc être comprise comme un ensemble structuré d’éléments probants pour une décision, et non comme un substitut au jugement opérationnel ou à une mesure ultérieure.
FAQ
À quoi sert la simulation d’un système logistique ?
Elle sert à examiner le comportement possible des opérations logistiques selon différents niveaux de capacité, règles de fonctionnement, profils de demande ou perturbations avant d’apporter des changements physiques.
La simulation logistique est-elle identique à l’optimisation ?
Non. La simulation évalue des scénarios modélisés, tandis que l’optimisation recherche une solution privilégiée selon des objectifs et des contraintes définis. Elles peuvent être utilisées ensemble.
La simulation peut-elle prédire des heures de livraison exactes ?
Elle peut estimer les résultats de livraison dans le cadre d’hypothèses définies, y compris l’incertitude lorsqu’elle est modélisée. Elle ne peut pas garantir l’heure de livraison d’une expédition individuelle ni prendre en compte les conditions qui sortent de son périmètre.
Quelles données sont nécessaires pour une simulation logistique ?
Les données requises dépendent de la décision. Les entrées pertinentes peuvent inclure les arrivées de commandes, les durées des processus, les stocks, la capacité des ressources, les horaires des équipes, les calendriers de transport ainsi que les règles opérationnelles d’acheminement ou de priorité.
Sources
- Manuel D. Rossetti, Simulation Modeling and Arena — Référence pédagogique pour la modélisation à événements discrets, les files d’attente, la modélisation des entrées, la conception des expériences et l’analyse des résultats.
- Robert G. Sargent, Verification and validation of simulation models, Journal of Simulation — Référence universitaire sur la vérification, la validation, la crédibilité des modèles et leur adéquation à l’objectif prévu.
- Wikipedia, Computer simulation — Référence complémentaire sur le concept général de simulation informatique et les distinctions entre les approches de modélisation.