15 questions à poser à un fournisseur d’API de suivi avant de passer en production
Avant de mettre une API de suivi en production, demandez-lui comment elle gère vos transporteurs et types d’expédition réels, ce que signifient ses événements, comment les mises à jour arrivent et ce qui se passe lorsque les données ou l’intégration échouent. Les 15 questions ci-dessous offrent aux équipes d’ingénierie et d’exploitation un moyen pratique de tester ces réponses avant que les clients, les agents du support ou les workflows automatisés ne dépendent de cette API.
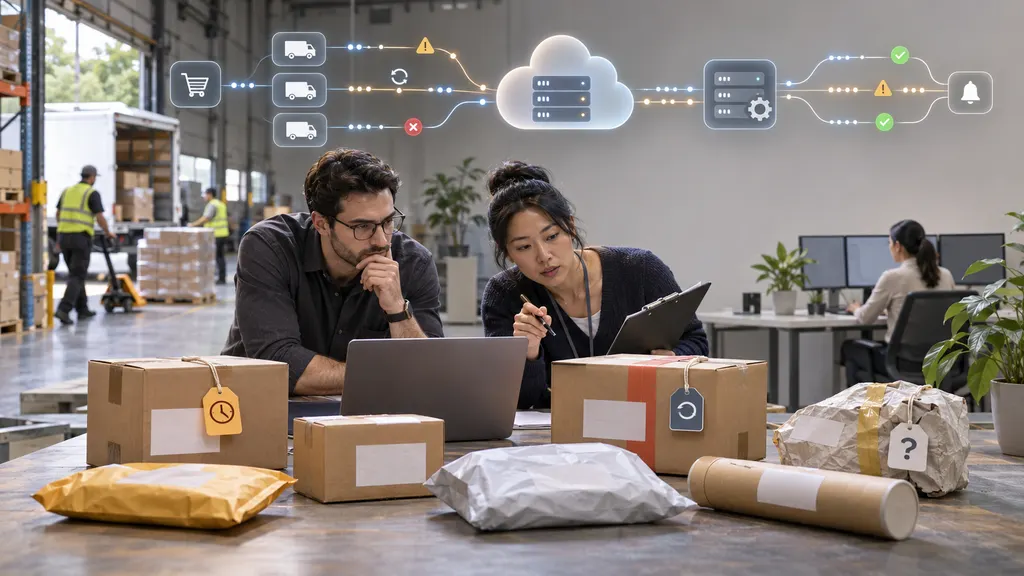
Une démonstration réussie ne constitue pas un test de production. Utilisez un échantillon représentatif d’expéditions, notamment des colis retardés, retournés et difficiles à identifier. Pour chaque réponse, demandez une documentation, un exemple de payload ou un résultat de test. Notez chaque élément non résolu en indiquant un responsable et une date de décision, plutôt que de supposer qu’il sera traité après le lancement.
Commencez par l’adéquation des expéditions et la signification des données
1. Lesquelles de nos expéditions réelles pouvez-vous suivre, et que signifie la couverture ?
Fournissez au prestataire un échantillon de vos transporteurs, services, couples origine-destination et formats de numéros de suivi. Demandez-lui d’identifier les expéditions qu’il peut accepter, les transporteurs qu’il peut identifier automatiquement et les cas où vous devez fournir un code transporteur. La présence d’un transporteur dans une liste ne garantit pas que chaque service, transfert ou type d’expédition produira les événements dont votre application a besoin.
Testez des exemples réels provenant de flux à fort volume et de cas opérationnels particuliers. Incluez une expédition qui change de transporteur pendant le transit si cela se produit dans votre activité. Notez si l’API refuse l’expédition, l’accepte sans trouver d’événements ou renvoie des événements avec un niveau de détail limité. Ces situations nécessitent une gestion différente dans un système de gestion des commandes.
2. Que faut-il pour enregistrer une expédition et comment empêchez-vous les enregistrements en double ?
Clarifiez les identifiants requis, les règles de sélection du transporteur, le moment de l’enregistrement et la réponse apportée à un numéro de suivi invalide ou pas encore actif. Demandez si un numéro de suivi suffit pour votre cas d’utilisation ou si des informations supplémentaires sont nécessaires. Confirmez ce qui se passe si la même expédition est soumise deux fois, par le même système ou par des services distincts.
Créez un flux d’enregistrement avec une responsabilité explicite : quel système soumet les expéditions, lequel stocke l’identifiant du prestataire et lequel réessaie une soumission incertaine. Si une requête expire après son traitement par le prestataire, une nouvelle tentative aveugle ne doit pas créer silencieusement un deuxième enregistrement ni des notifications en aval en double.
3. Que signifient vos statuts et pouvons-nous consulter les événements sous-jacents du transporteur ?
Demandez un dictionnaire des statuts et des événements bruts représentatifs. Des termes tels que « en transit », « en cours de livraison », « exception », « livré » et « retourné » sont des résumés utiles, mais vos règles métier peuvent nécessiter davantage de détails. Déterminez si le prestataire fournit les descriptions originales du transporteur en plus des statuts standardisés et comment il gère un événement qui ne correspond pas clairement à un statut.
Définissez votre propre modèle de statuts internes avant le lancement. Décidez notamment quel événement peut clôturer une expédition, déclencher un message de livraison ou lancer un workflow d’exception. Ne considérez pas un libellé de statut général comme la preuve d’un événement physique précis à moins que les données sous-jacentes ne justifient cette interprétation.
4. Quels horodatages et lieux sont fournis et comment devons-nous les interpréter ?
Pour chaque événement, distinguez l’heure à laquelle le transporteur indique qu’il s’est produit de l’heure à laquelle le prestataire l’a reçu ou publié. Posez des questions sur les fuseaux horaires, les décalages manquants, la précision des lieux et les mises à jour qui arrivent après des événements ultérieurs. Un événement reçu récemment peut décrire un ancien scan ; trier uniquement selon l’heure d’ingestion peut produire une chronologie trompeuse.
Testez le payload par rapport au schéma de votre base de données et à l’affichage destiné aux clients. Décidez comment afficher un événement lorsque son fuseau horaire local est incertain et évitez de présenter une heure ou un lieu de livraison précis si la source ne les fournit pas.
5. Comment les exceptions, les retours et les preuves de livraison sont-ils représentés ?
Demandez des exemples de tentatives de livraison infructueuses, de blocages douaniers, de problèmes d’adresse, de retours à l’expéditeur et d’expéditions livrées. Demandez quels détails sont standardisés, lesquels restent propres au transporteur et si la confirmation de livraison comprend des éléments justificatifs dans les cas qui vous intéressent. Ne supposez pas qu’un statut « livré » inclut le nom du destinataire, une signature, une photo ou une autre preuve.
Associez chaque exception à un responsable chargé d’agir. Certains événements justifient un examen par le support ; d’autres ne nécessitent aucun message client tant que de nouvelles informations ne sont pas disponibles. Si une preuve de livraison est nécessaire pour un workflow de litige, faites de sa disponibilité et de son format un critère d’acceptation distinct plutôt qu’une composante implicite de la couverture du suivi.
Testez la manière dont les mises à jour parviennent à vos systèmes
6. Fournissez-vous les mises à jour par webhook, par interrogation ou par les deux, et quand devons-nous utiliser chaque méthode ?
Demandez le modèle de livraison documenté, des exemples de payloads, la configuration des abonnements et les consignes pour récupérer les mises à jour manquées. Si des webhooks sont proposés, déterminez s’ils signalent une expédition modifiée, fournissent un instantané complet ou transportent un événement individuel. Si l’interrogation est requise ou utilisée comme solution de secours, clarifiez le modèle de requête approprié et la manière d’identifier les enregistrements modifiés.
Choisissez le modèle en fonction du workflow. Une chronologie destinée aux clients peut tolérer un délai différent de celui d’une file d’exceptions. Votre architecture ne doit pas promettre des alertes instantanées simplement parce qu’une intégration utilise des webhooks : le transporteur doit d’abord rendre l’événement disponible, puis chaque système suivant doit le traiter.
7. Que se passe-t-il lorsque les notifications sont dupliquées, retardées ou arrivent dans le désordre ?
Demandez si le prestataire réessaie les livraisons échouées, pendant combien de temps et quelle réponse il attend de votre endpoint. Demandez un identifiant stable d’événement ou d’expédition s’il en existe un. Testez ensuite deux fois la même notification, envoyez un événement plus ancien après un événement plus récent et renvoyez temporairement une erreur depuis votre endpoint.
Votre récepteur doit être conçu pour accuser réception uniquement de ce qu’il a accepté en toute sécurité, traiter les nouvelles tentatives sans répéter les messages destinés aux clients et reconstruire une chronologie correcte lorsque les événements arrivent dans le désordre. Si une conception proposée dépend d’une livraison exactement unique de chaque notification, remettez cette hypothèse en question avant la mise en production.
8. Comment mesurerons-nous la fraîcheur des données et quels facteurs l’influencent ?
Demandez ce que le prestataire peut mesurer à chaque étape : l’heure de l’événement du transporteur, l’heure d’ingestion par le prestataire et l’heure de livraison à votre système. Séparez ces mesures de tout engagement pris. Un long intervalle entre le déplacement physique et la mise à jour de votre application peut provenir du transporteur, du traitement du prestataire ou de votre propre file d’attente.
Pendant un pilote, mesurez ces intervalles pour des expéditions représentatives et examinez les valeurs atypiques. Définissez les seuils d’alerte en fonction des exigences réelles de votre workflow. Si un scan retardé risque de provoquer un message client préjudiciable ou une escalade manquée, définissez une solution de secours telle qu’un libellé de données obsolètes ou un examen manuel.
9. Comment les identifiants d’API et les requêtes webhook sont-ils protégés ?
Demandez la documentation relative à l’authentification et à la gestion des identifiants. Confirmez comment les identifiants sont émis, limités, renouvelés et révoqués ; si les identifiants de test et de production sont distincts ; et comment un récepteur webhook peut vérifier l’authenticité d’une requête. Demandez également quelles protections sont disponibles contre la relecture de requêtes webhook.
Faites examiner l’implémentation proposée par votre équipe de sécurité, et pas seulement la liste des fonctionnalités du prestataire. Gardez les secrets hors du code côté client et des journaux, limitez l’accès aux identifiants de production et répétez la procédure de renouvellement des identifiants. Si votre application ne peut pas vérifier une notification entrante avec le mécanisme documenté, cela constitue un obstacle au lancement d’un workflow fondé sur les webhooks.
10. Quelles données d’expédition et de client conservez-vous et où sont-elles envoyées ?
Établissez la liste de chaque champ que votre intégration enverrait, notamment les numéros de suivi, références de commande, adresses, coordonnées et métadonnées personnalisées. Demandez quels champs sont obligatoires, pendant combien de temps les données et journaux sont conservés, comment fonctionnent les demandes de suppression et quelles régions ou quels sous-traitants ultérieurs concernent les exigences de votre organisation. Obtenez la documentation contractuelle ou de sécurité requise par votre examen.
Réduisez les données transmises au minimum. Une intégration de suivi ne devrait pas recevoir les informations client simplement parce qu’il est pratique de transmettre un objet de commande complet. Vos équipes chargées de la confidentialité, du juridique et de la sécurité doivent déterminer si le traitement documenté par le prestataire est adapté aux marchés dans lesquels vous opérez.
Préparez-vous aux défaillances et aux changements opérationnels
11. Quelles sont les limites de débit et comment les clients doivent-ils répondre aux erreurs ?
Demandez les limites par endpoint, identifiant et environnement, ainsi que les règles de concurrence et le comportement de nouvelle tentative recommandé. Distinguez une requête invalide d’un problème temporaire de service et d’une requête limitée par le débit. Pour les API HTTP, la signification des codes d’état est importante : RFC 6585 définit 429 pour un nombre excessif de requêtes, tandis que RFC 9110 décrit la sémantique HTTP, notamment les erreurs serveur.
Calculez le trafic attendu les jours ordinaires et lors des pics, puis testez un client qui ralentit progressivement, met le travail en file d’attente et déclenche des alertes en cas de défaillances persistantes. Confirmez qu’une écriture incertaine peut être réessayée sans danger. Une stratégie de nouvelle tentative qui multiplie le trafic pendant une panne peut compliquer le rétablissement.
12. Comment les changements de schéma, de statut et d’intégration des transporteurs sont-ils communiqués ?
Renseignez-vous sur le versionnage de l’API, les notifications d’obsolescence, les journaux des modifications et la possibilité d’ajouter des champs d’événement sans changer de version. Les descriptions fournies par les transporteurs et le comportement du suivi peuvent également changer. Déterminez comment le prestataire communique un changement qui concerne un transporteur ou un itinéraire particulier plutôt que l’ensemble de l’API.
Écrivez des parseurs tolérants pour les champs facultatifs et les valeurs de statut inconnues, mais ne transformez pas silencieusement une valeur inconnue en « livré » ou « échoué ». Stockez suffisamment de détails de la source pour diagnostiquer une modification de mappage. Désignez une personne chargée d’examiner les avis du prestataire et de mettre à jour vos tests d’intégration avant qu’un changement n’atteigne les clients.
13. Que pouvons-nous tester avant la production et dans quelle mesure l’environnement de test correspond-il au comportement réel ?
Demandez l’accès à la documentation, à un environnement de test s’il est proposé, à des réponses d’exemple et à un moyen d’exercer les chemins d’erreur. Demandez quels scénarios sont simulés et lesquels nécessitent des expéditions réelles. Un bac à sable peut prouver que votre code gère un payload, tout en fournissant peu d’informations sur l’exhaustivité des événements transporteur, le délai des mises à jour ou l’adéquation régionale.
Réalisez deux types de tests : des tests d’intégration déterministes pour l’analyse, les nouvelles tentatives et la sécurité ; ainsi qu’un pilote limité avec des expéditions réelles pour le comportement opérationnel. Incluez des soumissions en double, une expiration du prestataire, un scan retardé, un retour et un statut inconnu. Les équipes d’ingénierie et les équipes qui traiteront les exceptions doivent toutes deux valider les résultats.
14. Quels engagements de support et d’incident s’appliquent lorsque le suivi cesse de se mettre à jour ?
Demandez quels canaux de support sont disponibles pour votre compte, comment les incidents sont signalés et quels engagements contractuels de service, le cas échéant, s’appliquent à l’API ou à la livraison des notifications. Clarifiez si un engagement de disponibilité couvre l’endpoint de l’API, la livraison des mises à jour de suivi ou les deux. Il ne s’agit pas du même résultat opérationnel.
Établissez votre propre procédure : qui détecte une défaillance, qui contacte le prestataire, quand l’interrogation ou une autre solution de secours est utilisée et ce que voient les clients pendant le retard des mises à jour. Demandez la procédure de résolution d’un problème de données propre à une expédition ainsi que celle applicable à une panne générale de la plateforme. Testez votre processus d’escalade avant d’en avoir besoin.
15. Comment l’utilisation et les coûts sont-ils calculés et que se passe-t-il si nous partons ?
Demandez quelles actions sont prises en compte dans la facturation ou les limites d’utilisation : soumissions, expéditions suivies, requêtes, notifications ou autre unité. Confirmez le traitement des enregistrements en double, des nouvelles tentatives, des expéditions inactives, des dépassements et du trafic de test dans le cadre de l’accord proposé. Obtenez les conditions applicables par écrit au lieu d’estimer les coûts à partir d’une démonstration de l’API.
Prévoyez également la résiliation. Déterminez comment exporter l’historique des expéditions, combien de temps l’accès reste disponible et ce qu’il advient des enregistrements de suivi actifs. Un plan de sortie opérationnel ne signifie pas que vous changerez de prestataire ; il permet d’éviter de perdre la visibilité sur les expéditions déjà en cours.
Transformez les réponses en décision de mise en production
Une revue utile avant la mise en production produit trois résultats :
- Un résultat d’adéquation des expéditions : un échantillon testé montrant quels enregistrements de suivi ont été acceptés et si leurs événements prennent en charge les workflows clients et opérationnels prévus.
- Un résultat d’intégration : une gestion démontrée de l’authentification, des doublons, des nouvelles tentatives, des événements retardés, des variations de schéma et de la récupération des mises à jour manquées.
- Un accord opérationnel : des limites documentées, des conditions de traitement des données, des contacts de support, des hypothèses de coûts et des responsables pour les risques non résolus.
17TRACK est un prestataire à évaluer si une API de suivi multi-transporteurs correspond à votre cas d’utilisation ; sa page consacrée à l’API de suivi et sa documentation API constituent des points de départ pour vérifier l’intégration au regard de ces questions. La même exigence doit s’appliquer à tout prestataire : la documentation établit le fonctionnement prévu d’une interface, tandis que vos propres tests avec des expéditions représentatives établissent si elle convient à votre workflow de production. Ne déployez aucune notification client ni automatisation d’exception avant d’avoir validé les événements qui les déclenchent.
FAQ
Un test en bac à sable suffit-il pour approuver une API de suivi destinée à la production ?
Non. Un bac à sable peut valider les formats de requête et certains traitements des défaillances, mais des expéditions réelles sont nécessaires pour évaluer les événements propres aux transporteurs, les délais et l’utilité des données d’exception sur vos itinéraires réels. Utilisez les deux, avec des critères d’acceptation distincts.
Devons-nous utiliser des webhooks ou interroger l’API pour obtenir les mises à jour de suivi ?
Appuyez-vous sur les options de livraison documentées par le prestataire et sur la tolérance au délai de votre workflow pour décider. Les webhooks peuvent réduire le besoin de vérifications répétées lorsqu’ils sont pris en charge, mais votre récepteur doit tout de même gérer les nouvelles tentatives et les doublons. L’interrogation peut convenir comme méthode principale ou comme voie de récupération, sous réserve des limites documentées.
Quelle est l’erreur la plus courante dans le mappage des statuts de suivi ?
Utiliser un statut général comme déclencheur d’une affirmation métier plus précise. Par exemple, le seul libellé « livré » peut ne pas fournir la preuve nécessaire pour résoudre un litige. Définissez les déclencheurs à partir des détails de l’événement sous-jacent réellement fournis par votre prestataire.
Qui doit approuver l’intégration avant le lancement ?
L’ingénierie doit approuver la fiabilité et la sécurité ; les équipes opérationnelles ou le support doivent approuver l’utilité des événements et des workflows d’exception ; les responsables compétents de la confidentialité, du juridique et des achats doivent examiner le traitement des données et les conditions commerciales. Désignez un responsable pour chaque lacune qui reste ouverte.