承运商事件时间戳:为什么时区和格式不同,以及如何进行标准化
承运商事件时间戳存在差异,是因为跟踪系统可能记录当地网点时间、UTC 或其他有文档说明的参考时间,然后以不同格式显示这些值。要可靠地对其进行标准化,请保留原始时间戳,明确其时区含义,仅将能够解析的值转换为 UTC,并将事件时间与系统接收更新的时间分开。没有偏移量或有文档说明的时区的时间戳,并不会自动被视为 UTC。
本指南适用于开发人员、物流运营团队和支持团队,用于协调不同系统中的货件历史记录。目标并不只是让日期看起来一致,而是构建一条在扫描延迟到达、货件跨境运输或夏令时发生变化时仍然经得起核查的时间线。
为什么同一件货件会显示不同的时间
跟踪时间戳包含多个层面:它所描述的事件、用于记录事件的时钟、用于传输的格式,以及用于显示的规则。任何一个层面的差异,都可能使两份跟踪历史看起来不一致,即使它们描述的是同一次运输活动。
- 不同的参考时区:数据源可能使用扫描地点的当地时间、中央运营时区或 UTC。应为每个字段明确其约定,而不是假定所有承运商都采用同一种约定。
- 不同的显示设置:网站或应用程序可能会将时间戳转换为查看者所在的时区,另一个界面则可能保留数据源的当地时间。
- 不同的事件含义:实际扫描时间、记录进入承运商系统的时间,以及集成系统接收记录的时间,是三个不同的时刻。
- 不同的精度:一个数据源可能提供秒,另一个提供分钟,还有一个只提供日期。将这三者都格式化为带秒的形式,并不会使它们具有相同的精度。
- 不同的日期约定:像
04/05/2025这样的值,可能表示 4 月 5 日,也可能表示 5 月 4 日。其含义必须来自数据源契约,而不是服务器的区域设置。
对购物者而言,实际影响很简单:显示的小时不同,并不能单独证明配送记录有误。在将其视为差异之前,应先比较事件描述、地点、日期和时区标签。
格式和时区是两个独立的问题
识别日期格式,并不能确定它所代表的具体时刻。RFC 3339 定义了一种互联网时间戳格式,其中包含日期、时间和 UTC 偏移量。末尾的 Z 表示以 UTC 为参考;像 +02:00 这样的数字偏移量,描述该时间戳相对于 UTC 的差异。
以下示例仅用于说明,并非承运商记录。
| 输入 | 解释 | 标准化决策 |
|---|---|---|
2025-06-10T14:30:00+02:00 | 带有明确 UTC 偏移量的时间 | 转换为 2025-06-10T12:30:00Z。 |
2025-06-10T12:30:00Z | UTC 时间戳 | 保留该时刻;仅在显示时进行本地化。 |
2025-06-10 14:30:00 | 不包含时区信息的日期和时间 | 根据有文档说明的数据源语义进行解析,否则保持未解析状态。 |
04/05/2025 09:10 | 日期顺序不明确且没有偏移量 | 需要特定于数据源的解析规则和时区规则。 |
2025-06-10 | 仅包含日期的值 | 保留为日期;不要臆造午夜扫描时间。 |
偏移量和命名时区也有不同用途。-05:00 可以标识某个具体时刻的偏移量,但不能标识某个地区历史上或未来的时钟规则。America/New_York 这样的 IANA 标识符指向一组规则,可以考虑夏令时和历史变化。IANA 时区数据库维护这些地区规则。
保留证据的标准化流程
1. 明确定义每个数据源字段的含义
在编写转换代码之前,应明确某个字段表示事件发生时间、发布时间、最后修改时间,还是 API 响应生成时间。检查有文档说明的日期顺序、偏移量行为、精度以及缺失值的处理方式。确认来自不同网点的事件是否遵循相同约定。
如果您将 17TRACK Tracking API documentation 作为集成参考,请在将时间戳映射到自有架构之前,执行相同的字段级检查。仅凭字段名称,无法充分证明其采用 UTC 语义或表示事件时间。
将这些规则保存在带版本的源映射中。当供应商更改格式时,您应能够确定哪些事件使用了此前的解释。
2. 在转换前保留原始记录
在保留标准化值的同时,保留原始时间戳字符串及相关数据源元数据。保留原始偏移量、地点文本、可用的数据源事件标识符,以及系统接收记录的时间。这样,在调查争议或修正解析器后重新处理记录时,就有据可查。
不要用重新格式化的字符串覆盖原始值。看似无害的转换可能会抹去证据,例如偏移量是否存在,或数据源是否只提供了分钟级精度。
3. 使用明确的数据源规则进行解析
优先使用严格且有文档说明的解析器,而不是通用的日期猜测器。对于不可能的日期和有歧义的日期顺序,应拒绝处理,而不是悄悄切换约定。对于数字纪元值,应根据契约明确纪元、单位和字段含义;不要仅依靠数字长度来区分秒和毫秒。
将不支持的格式与缺失的时间戳区分开来。这两种情况需要不同的后续行动:前者可能需要更新解析器,后者可能需要向数据源进行确认。
4. 根据证据层级解析时区
- 使用明确的偏移量:当数据源字段被定义为事件时间戳时,用偏移量解析具体时刻。
- 使用有文档说明的命名时区:当数据源提供不带偏移量的当地时间时,使用命名时区,并应用事件日期对应的规则,而不是今天的偏移量。
- 使用经过验证的网点与时区映射:仅当数据源确认该字段使用网点当地时间时,才采用这种映射。
- 否则保持未解析状态:保留当地时间读数,不要臆造 UTC 时刻。
仅凭国家名称并不足够,因为一个国家可能跨越多个时区。目的地地址、购物者浏览器所在时区以及应用服务器所在时区,也不能证明扫描所参考的时区。避免在没有数据源定义的情况下解释 CST 等缩写。
5. 转换为 UTC,同时保留上下文
确定具体时刻后,应存储规范化的 UTC 表示,以便比较和计算。同时,在可用时保留数据源当地值、偏移量和命名时区。选择一致的输出精度,但应保留实际提供精度的元数据。
修改后缀不等于转换。将 +02:00 替换为 Z,同时保持时钟读数不变,会使所表示的时刻偏移两个小时。
6. 验证并分类结果
使用明确的标准化状态,例如 resolved、missing_zone、ambiguous_local_time、invalid_local_time 和 parse_error。这些是建议使用的内部标签,并非承运商标准。
标记可疑结果,包括时间戳意外晚于接收时间,或与相邻记录不一致的情况。应将其视为需要审核的信号,而不是自动重写。延迟摄取、时钟错误以及对字段语义的误解,需要采取不同的处理方式。
明确处理夏令时缺口和重复小时
当某个地区的时钟回拨时,本地时钟读数可能出现两次;当时钟前拨时,某些本地读数则根本不会出现。因此,仅凭本地日期、时钟时间和命名时区,并不总能解析出唯一时刻。
例如,根据适用的纽约规则,2025-11-02 01:30 在秋季回拨期间会以两个不同的偏移量出现。如果没有偏移量或其他可靠的消歧信息,选择其中任意一次都是一种假设。相反,2025-03-09 02:30 位于该时区春季前拨造成的时间缺口内。
使用支持时区的库,并测试其实际行为。有些 API 会选择默认出现时间,或调整无效的本地时间,而不是拒绝它们。Python 的 zoneinfo 文档说明了使用 fold 机制区分重复时间的方法;其他平台提供的控制方式可能不同。
对于需要审计的处理流程,应保留未解析或无效的输入以供审核,而不是默默接受库的默认值。在可复现性重要的场景中,应记录转换所使用的时区数据库版本,因为地区规则可能发生变化。
将事件顺序与更新到达顺序分开
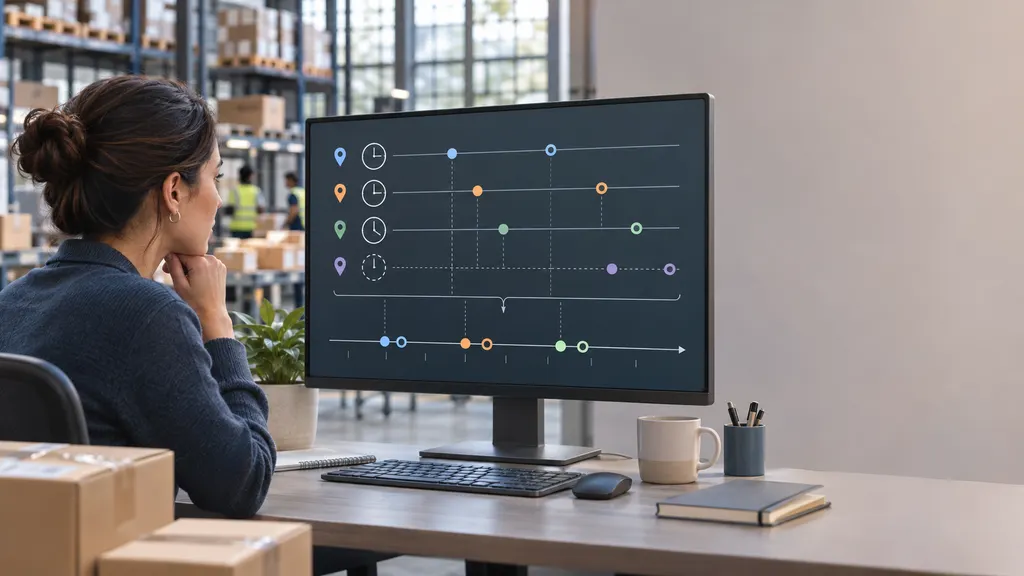
较晚收到的记录并不一定描述较晚发生的实际事件。例如,系统可能在已经收到 10:00 的出发事件后,才收到一条说明性 08:00 网点扫描记录。按接收时间排序会错误地表示货件顺序。
至少维护以下两个相互独立的概念:
- 事件时间:数据源所表示的货件事件发生时间。
- 接收时间:系统收到该记录的时间。
使用已解析的事件时刻构建时间顺序视图。保留数据源顺序或稳定的记录标识符来处理相同时间,并保留接收时间用于监控数据摄取。对于时区未解析的事件,不应在全局排序的时间线中为其臆造位置。
时间戳标准化本身也无法决定货件状态。较早发生的事件延迟到达时,不应自动取代较新的运营状态。状态选择需要针对事件含义、数据源权威性和更正记录制定独立规则。
针对不同用途设计存储和显示方式
实用的内部记录可以包含 event_time_raw、event_time_utc、source_offset、source_timezone、time_precision、received_at_utc、normalization_status 和 normalization_rule_version。这些是建议使用的应用字段,并非外部 API 架构。
当无法确定具体时刻时,应允许 event_time_utc 保持 null。确认数据库和驱动如何处理偏移量:某些类型可以保留具体时刻,但无法保留原始时区或偏移量。
对于面向购物者的显示,应选择一致的策略并明确标注。可以将所有已解析事件显示为购物者所选时区的时间,也可以保留事件发生地的当地时间并进行清晰说明。如果每次扫描都使用其自身的当地时区,应提醒读者不同地点的时钟读数可能无法直接比较。
运营仪表板适合同时提供 UTC 视图和原始数据源值。支持团队应能够解释显示的小时是经过转换的、由数据源提供的,还是保持未解析状态的。
测试普通样本容易遗漏的情况
- 等效时刻:表示同一时刻的不同偏移量必须标准化为相同结果。
- 日期边界:转换必须正确跨越午夜、月末和年末。
- 非整小时偏移量:应包含半小时和十五分钟偏移量的情况。
- 夏令时转换:同时测试重复的本地读数和不存在的本地读数。
- 信息缺失:覆盖缺少偏移量、有歧义的缩写、仅日期记录和空值。
- 精度和数字单位:检查小数秒和有文档说明的纪元单位,不要臆造精度。
- 延迟更新和更正:确认到达顺序不会破坏事件时间顺序或状态选择。
- 运行环境独立性:相同输入在不同地区时区的服务器上处理时,含义不得发生变化。
按数据源和解析器版本跟踪未解析及被拒绝的记录。数量突然增加可能揭示格式或映射问题。应将解析失败、缺少时区证据和摄取延迟分开记录,以便负责团队采取正确行动。
常见问题
为什么跟踪页面显示的小时与承运商页面不同?
两个页面可能使用了不同的显示时区或不同的时间戳字段,也可能在不同时间收到更新。在认定某个页面错误之前,应比较确切事件及其时区标签。
没有偏移量的时间戳可以假定为 UTC 吗?
不可以。只有当数据源契约明确规定其含义为 UTC 时,才能将其解释为 UTC。否则,在确认参考时区之前,应将其保留为未解析的当地时间值。
是否应该只存储 UTC?
对于已解析的时刻,应使用 UTC,但同时保留原始时间戳和解释元数据。仅有 UTC 无法说明数据源提供了什么,也无法解释后续更正。
可以根据两个当地时间戳计算运输时间吗?
只有在两者都能解析为具体时刻,且其事件含义适合该测量时才可以。跨时区或跨夏令时变化直接相减当地时钟读数,可能产生误导性的持续时间。仅日期记录无法支持精确的经过小时数计算。
对时间戳字符串排序能得到正确顺序吗?
对于任意格式和偏移量,不能。应将已解析值标准化为一致的 UTC 表示,或比较类型化的时刻。即使是有效的 RFC 3339 字符串,也需要格式和偏移量条件一致,才能直接进行字典序排序。
来源
- RFC 3339:互联网日期和时间——时间戳 — 时间戳语法、UTC 偏移量以及字符串排序条件。
- IANA 时区数据库 — 地区时区数据,以及反映偏移量和夏令时规则变化的更新。
- Python 文档:zoneinfo — IANA 时区支持、夏令时转换和重复时间消歧。
- Python 文档:datetime — 有时区和无时区的日期时间对象、偏移量及转换行为。