Begäran om realtidsspårning överskred tidsgränsen? Regler för återförsök, fallback och status att följa
När en realtidsförfrågan om spårning överskrider tidsgränsen ska försändelsens senaste status behandlas som okänd – inte som försenad, förlorad eller oförändrad. Försök endast igen inom en begränsad tidsbudget och visa sedan en tydligt märkt senast känd uppdatering eller be användaren att försöka igen senare. Håll hela tiden isär förfrågningens resultat, informationens aktualitet och paketets faktiska status.
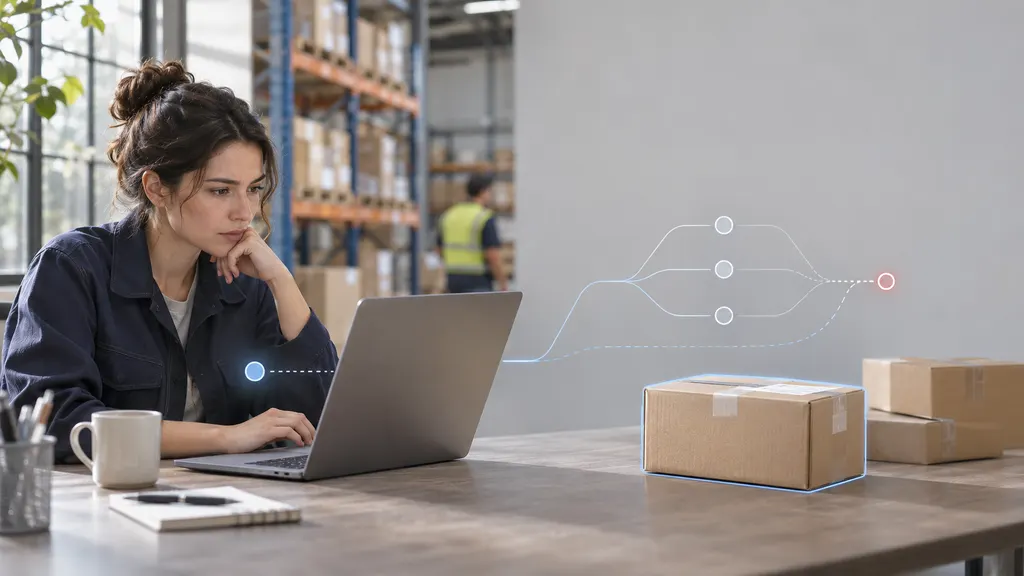
Denna åtskillnad är viktig både för kundinriktade spårningssidor och för system som använder spårningsdata för att utlösa aviseringar eller supportarbetsflöden. En timeout innebär att ett svar inte kom fram i tid. Den säger inte om transportören har en ny händelse, om en överordnad tjänst behandlade förfrågan eller om paketet har flyttats.
Identifiera först vad som överskred tidsgränsen
En spårningsförfrågan kan misslyckas på flera punkter: webbläsaren kan sluta vänta på din applikation, din applikation kan sluta vänta på ett spårnings-API eller API:et kan få timeout när det kontaktar en annan tjänst. Användaren kan se samma generiska fel i varje fall, men lämplig nästa åtgärd skiljer sig åt.
- Timeout på klientsidan: Appen slutade vänta. Förfrågan på serversidan kan fortfarande ha slutförts. Kontrollera dina egna förfrågningsloggar eller resultatlagring innan du skickar en ny förfrågan som kan duplicera arbetet.
- Nätverks- eller anslutningsfel: Ditt system tog inte emot ett användbart svar. Du kanske inte vet om fjärrtjänsten behandlade förfrågan.
- HTTP 504: En gateway eller proxy tog inte emot ett svar i tid från en överordnad server. Detta beskriver förfrågningsvägen, inte försändelsen.
- HTTP 408: Servern tog inte emot ett komplett förfrågningsmeddelande inom den tid den var beredd att vänta. Det är inte en spårningsstatus från transportören.
- HTTP 200 med en gammal händelse: Förfrågan lyckades, men den returnerade spårningsinformationen kan fortfarande vara inaktuell. Ett lyckat HTTP-svar är ingen garanti för att informationen är aktuell.
Registrera dessa resultat som diagnostik för förfrågningar. Översätt inte något av dem till försändelseetiketter som ”under transport”, ”undantag” eller ”levererad”. Dessa etiketter ska komma från spårningshändelser eller ett dokumenterat statusfält, inte från transportlagret.
Använd en begränsad omförsökspolicy, inte en oändlig loop
För en skrivskyddad spårningsuppslagning är ett nytt försök efter en timeout ofta rimligt. Det bör ändå begränsas. Upprepade förfrågningar kan öka belastningen på en tjänst med problem, förlänga användarens väntetid och skapa duplicerat arbete när flera applikationslager försöker igen oberoende av varandra.
- Ange en total tidsgräns. Bestäm hur länge den användarinriktade åtgärden får ta, inklusive det första försöket och eventuella nya försök. Ge inte varje försök en ny fullständig tidsgräns som överskrider den tid anroparen kan vänta.
- Kontrollera om åtgärden är säker att upprepa. En uppslagning skiljer sig normalt från en förfrågan som registrerar en försändelse, ändrar inställningar eller skapar en resurs. Spela inte automatiskt upp en förfrågan som ändrar tillstånd om inte leverantörens avtal eller dina idempotenskontroller gör det säkert.
- Försök sparsamt igen vid tillfälliga fel. Använd en liten, uttrycklig omförsöksbudget och en fördröjning med jitter i stället för att skicka samtidiga omedelbara försök från många klienter.
- Följ tillämpliga serverinstruktioner. Om ett svar innehåller en giltig
Retry-After-header ska du inte schemalägga ett tidigare nytt försök. Respektera även eventuella striktare begränsningar i applikationen eller hos leverantören. - Sluta när tidsgränsen eller budgeten är slut. Växla till ett reservsvar och schemalägg separat en senare avstämning om arbetsflödet kräver det.
En praktisk utformning kan tillåta ett användarinriktat nytt försök om det finns tillräckligt med tid kvar, medan ytterligare försök flyttas till en bakgrundsuppdatering. Det är ett exempel på en policy, inte en universell API-regel. Välj gränser utifrån dina mål för servicenivå, observerad latens och leverantörens dokumentation. Räkna också med omförsök som görs av HTTP-bibliotek, gateways och jobbprocesser; annars kan en till synes måttlig applikationspolicy skapa många anrop uppströms.
För HTTP 429 ska svaret behandlas som en signal om hastighetsbegränsning, inte som en anledning att försöka igen omedelbart. HTTP 503 kan indikera en tillfällig oförmåga att hantera förfrågan, och en server kan tillhandahålla Retry-After. En 504 kan vara tillfällig, men garanterar inte att nästa försök fungerar. Autentiseringsfel kräver i allmänhet kontroll av autentiseringsuppgifter eller behörigheter, medan felaktigt utformade förfrågningar kräver korrigering av indata. Ett spårnings-ID som ger resultatet ”hittades inte” kräver större försiktighet: beroende på leverantörens dokumenterade beteende och försändelsens skede kan det vara för tidigt att hitta en post, eller så kan identifieraren vara felaktig. Omvandla inte ett sådant resultat till det definitiva påståendet att paketet inte existerar.
Välj en reservlösning som bevarar det du vet
Den säkraste reservlösningen är vanligtvis det senast verifierade spårningsresultatet, tillsammans med dess egen händelsetid och en ärlig etikett för aktualitet. Håll detta resultat åtskilt från det aktuella förfrågningsfelet. En sida kan exempelvis säga: ”Senast tillgängliga uppdatering: Lämnade anläggningen. Senast kontrollerad: [tid]. En nyare uppdatering är tillfälligt otillgänglig.” Inkludera endast ”Senast kontrollerad” om systemet faktiskt registrerar det; det ersätter inte transportörens händelsetid.
Använd den mest specifika tid du kan stödja. En händelsetid från transportören beskriver när en händelse uppges ha inträffat. En tid då ditt system tog emot händelsen beskriver mottagningen. En tid då en användare öppnade sidan beskriver inget av detta. Om källan inte tillhandahåller en tillförlitlig händelsetid eller tidszon ska du undvika att hitta på en. Om det cachelagrade resultatet saknar registrerad hämtningstid ska du på samma sätt kalla det en ”senast tillgänglig uppdatering” i stället för att påstå att det nyligen uppdaterades.
En reservlösning bör följa tre gränser:
- Visa cachelagrade data som cachelagrade data. Presentera inte en äldre händelse som resultatet av den förfrågan som fick timeout.
- Dra inte slutsatser om framsteg utifrån förfluten tid. Ett paket är inte ”ute för leverans” enbart för att det har varit under transport i flera dagar.
- Dölj inte väsentlig osäkerhet. Om det inte finns något tidigare resultat ska du säga att spårning tillfälligt inte är tillgänglig i stället för att visa en påhittad standardstatus.
Andra reservvägar kan omfatta ett tidigare synkroniserat spårningslager, en auktoriserad uppslagning hos transportören eller en senare bakgrundsuppdatering. Använd dem endast om de passar försändelsen, dina behörigheter och datakällans villkor. En andra källa kan ha andra händelsenamn eller rapporteringsfördröjningar, så bevara ursprunget och undvik att slå samman motstridiga poster utan en regel för hur det ska göras. Om en kund kan agera utifrån resultatet ska du erbjuda ett sätt att försöka igen eller kontakta supporten i stället för att lämna en laddningsindikator aktiv på obestämd tid.
Håll förfrågningsstatus, dataaktualitet och försändelsestatus åtskilda
Detta är tre olika fält, även om ett användargränssnitt visar dem tillsammans. Förfrågningsstatus anger om uppslagningen lyckades, fick timeout eller resulterade i ett fel. Dataaktualitet anger när den returnerade eller lagrade informationen observerades. Försändelsestatus anger vad spårningskällan rapporterar om paketet. Genom att skilja dem åt förhindrar du att ett tillfälligt API-fel skriver över en giltig leveranshändelse eller omvandlar en inaktuell händelse om transport till ett aktuellt påstående.
Ett system kan till exempel ha en verifierad händelse ”Levererad” från en tidigare uppslagning medan den aktuella uppdateringen får timeout. Leveranshändelsen försvinner inte. Det korrekta kombinerade tillståndet är att den senast tillgängliga försändelsestatusen är levererad och att den senaste uppdateringen misslyckades. Om den senaste händelsen däremot är ”Under transport” bekräftar en timeout inte att paketet fortfarande är under transport just nu; den bekräftar endast att inget nyare svar erhölls.
Tillämpa en definierad regel när händelser anländer i fel ordning. Jämför händelseidentifierare, tidsstämplar, källa och leverantörens dokumenterade statussemantik där sådan information finns. Anta inte att den ordning i vilken systemet tog emot uppdateringar är den ordning i vilken försändelsehändelserna inträffade. En äldre händelse som anländer sent ska inte heller automatiskt ersätta en nyare verifierad status. Korrigeringar och undantag kan dock vara legitima, så undvik en generell regel som behandlar statusändringar efter leverans som omöjliga. Bevara de underliggande händelserna och undersök motsägelser i stället för att tyst skriva om historiken.
Om en leverantör returnerar HTTP 202 ska svaret tolkas enligt endpointens avtal: att en förfrågan har accepterats innebär inte i sig att spårningsuppslagningen är slutförd. På samma sätt fastställer HTTP 200 att en HTTP-förfrågan lyckades enligt endpointens semantik; det bevisar inte att varje spårningsfält finns eller är aktuellt. Mappa leverantörsspecifika svarsdata först efter att ha kontrollerat leverantörens dokumentation.
Gör felet synligt för operatörer utan att oroa kunder
En användbar operativ post innehåller förfrågnings-ID, endpoint eller åtgärd, antal försök, förfluten tid, timeoutlager, HTTP-status om en sådan mottogs samt om svaret kom från en aktiv uppslagning eller en reservlösning. För spårningsdata ska du registrera källa och relevanta händelse- eller hämtningstidsstämplar. Hantera spårningsnummer och kundinformation enligt organisationens regler för åtkomst och lagring; diagnostisk användbarhet är inte ett skäl att exponera fullständiga identifierare i obegränsade loggar.
Var uppmärksam på mönster i stället för att förlita dig på en enskild timeout. En ökande timeout-frekvens på en transportörsrutt, upprepade 429-svar eller ett växande gap mellan transportörens händelsetid och hämtningstid kan peka på olika problem. Det första kan kräva en undersökning hos leverantören, det andra kan kräva hastighetskontroll och det tredje kan kräva kontroll av synkronisering eller händelseleverans. Om en applikation erbjuder spårning genom en leverantör som 17TRACK Tracking API ska du använda leverantörens dokumentation för att verifiera endpoint-specifika svarsdata, förfrågningsgränser och felhantering innan du implementerar dessa allmänna regler.
Var exakt och återhållsam i kundmeddelandet: ”Vi kunde inte uppdatera spårningen just nu. Här är den senast tillgängliga uppdateringen.” Ange ett nästa steg när det hjälper, till exempel att försöka igen senare eller kontakta supporten om försändelsen har överskridit ett förväntat leveransfönster som säljaren eller transportören angett. Undvik att lova en uppdateringstid som systemet inte kan garantera.
Checklista inför lansering av ett timeout-säkert spårningsflöde
- Bekräfta vilket lager som tillämpar varje timeout och vilket lager som ansvarar för omförsök.
- Ange en total tidsgräns för förfrågan och en separat, begränsad omförsöksbudget.
- Verifiera att åtgärder som automatiskt försöks igen är säkra att upprepa.
- Respektera hastighetsbegränsningar och giltiga
Retry-After-instruktioner. - Lagra förfrågningens resultat separat från försändelsestatus och händelsehistorik.
- Märk reservdata och behåll dess källa och tidsstämplar när de finns tillgängliga.
- Testa scenarier utan cache, med inaktuell cache, 429, 503, 504 och sena svar.
- Kontrollera att en timeout inte kan utlösa en felaktig leveransavisering eller radera en verifierad händelse.
Grundregeln är enkel: försök endast igen när det är säkert och användbart; använd som reserv endast information som du kan identifiera; och gör aldrig ett påstående om försändelsestatus utifrån en HTTP-timeout.
Vanliga frågor
Bör jag omedelbart försöka igen efter en timeout för en spårningsförfrågan?
Inte automatiskt. Kontrollera att åtgärden är säker att upprepa, att den övergripande tidsgränsen lämnar tid för ytterligare ett försök och att ingen instruktion om hastighetsbegränsning säger att du ska vänta. Ett kort, begränsat nytt försök med jitter kan vara lämpligt för en skrivskyddad uppslagning; upprepade omedelbara försök är en dålig standard.
Betyder HTTP 504 att transportörens spårningssystem ligger nere?
Nej. Det betyder att en gateway eller proxy inte tog emot ett svar i tid från uppströms. Problemet kan finnas var som helst längs den förfrågningsvägen. Det fastställer varken transportörens övergripande tillgänglighet eller paketets tillstånd.
Kan jag visa den senast kända statusen efter en timeout?
Ja, om du märker den som den senast tillgängliga informationen i stället för som en lyckad aktiv uppdatering. Visa händelsetid och hämtningstid när de är kända och tydliggör att en nyare uppdatering inte kunde bekräftas.
Ska en timeout ändra en försändelse från ”under transport” till ”undantag”?
Nej. En timeout är ett förfrågningsfel, inte en försändelsehändelse. Ändra försändelsestatus endast när en tillförlitlig spårningskälla tillhandahåller en händelse eller status som stöder ändringen.
Vad händer om timeout-förfrågan skapade eller registrerade en spårningspost?
Anta inte att den misslyckades. Fjärrsystemet kan ha behandlat den innan svaret försvann. Kontrollera om det finns ett befintligt resultat och använd en dokumenterad idempotensmekanism eller ett återställningsförfarande som leverantören godkänt innan du skickar den igen.
Källor
- RFC 9110, HTTP Semantics — definitioner av HTTP-statusar,
Retry-Afteroch överväganden för att försöka skicka förfrågningar igen. - RFC 6585, Additional HTTP Status Codes — definition av HTTP 429 och dess användning tillsammans med
Retry-After. - Amazon Builders’ Library, ”Timeouts, retries, and backoff with jitter” — teknisk vägledning om förstärkning av omförsök, backoff och jitter.
- 17TRACK Tracking API documentation — referens för att verifiera leverantörsspecifikt API-beteende före implementering.