Jak dostawcy usług magazynowania i realizacji zamówień mogą korzystać z interfejsów API do śledzenia przesyłek
Magazyny i dostawcy usług fulfillment mogą korzystać z interfejsów API do śledzenia przesyłek, aby łączyć zdarzenia przewoźników z procesami magazynowymi, zarządzaniem zamówieniami i obsługą klienta. Praktyczna wartość nie polega wyłącznie na wyświetlaniu numeru przesyłki. Dobrze zaprojektowana integracja przekształca aktualizacje przewoźników w użyteczne sygnały operacyjne: zamówienie można monitorować po wysyłce, wyjątki mogą być kierowane do właściwego zespołu, klienci mogą otrzymywać bardziej przejrzyste informacje o dostawie, a wydajność fulfillment można analizować na podstawie spójnych danych o przesyłkach.
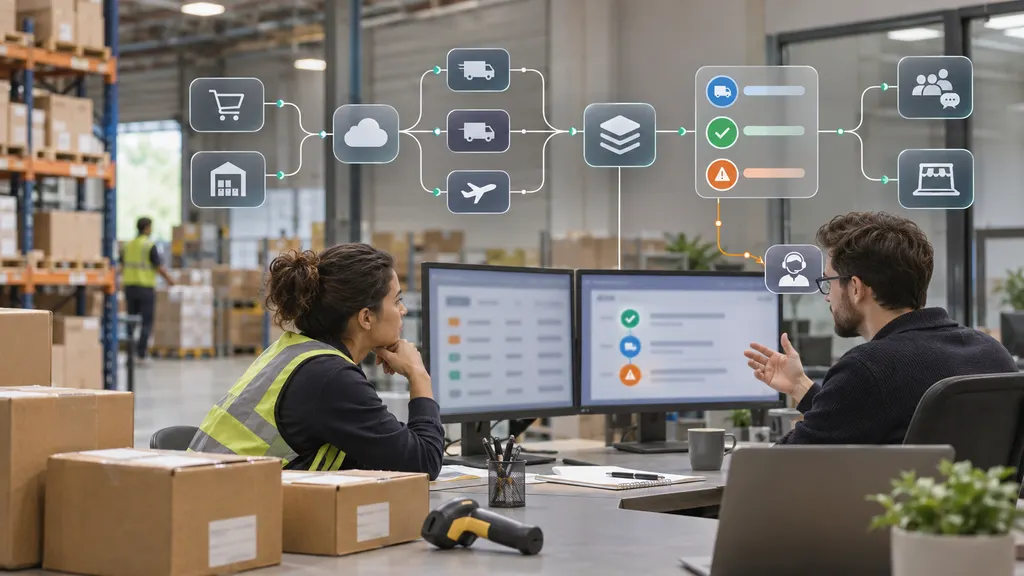
W przypadku magazynu lub operatora logistycznego 3PL najlepszym podejściem jest traktowanie śledzenia jako współdzielonej usługi danych, a nie samodzielnej strony skierowanej do klientów. API powinno gromadzić zdarzenia dotyczące przesyłek, normalizować informacje od wielu przewoźników, zachowywać oryginalne dane przewoźnika i udostępniać właściwy status pracownikom magazynu, sprzedawcom, zespołom wsparcia oraz odbiorcom.
Dlaczego dane śledzenia mają znaczenie po wysłaniu zamówienia
Proces magazynowy nie kończy się, gdy paczka opuszcza budynek. Po przekazaniu przesyłki dostawca może nadal potrzebować odpowiedzi na pytania operacyjne:
- Czy przewoźnik przyjął przesyłkę?
- Czy przesyłka przeszła poza pierwszy skan?
- Czy jest opóźniona, zatrzymana, zwrócona lub oczekuje na działanie?
- Wymaga uwagi działu obsługi klienta?
- Czy określeni przewoźnicy, usługi, miejsca docelowe lub lokalizacje fulfillment generują powtarzające się wyjątki?
Bez połączonego procesu śledzenia zespoły mogą polegać na portalach przewoźników, arkuszach kalkulacyjnych, ręcznym wyszukiwaniu lub niespójnych komunikatach o statusie. Utrudnia to odróżnienie normalnej przerwy między skanami od przesyłki, która rzeczywiście wymaga interwencji. API nie eliminuje potrzeby podejmowania decyzji operacyjnych, ale może udostępnić istotne informacje w systemach, w których podejmowane są decyzje.
Typowe zastosowania API do śledzenia w fulfillment
1. Automatyczna widoczność po wysyłce
Dostawca usług fulfillment może przesłać numery przesyłek i dane przewoźnika do API śledzenia, gdy zamówienie zostanie oznaczone jako wysłane. Zwrócone informacje o przesyłce można następnie powiązać z zamówieniem, paczką, klientem i lokalizacją fulfillment w wewnętrznych systemach dostawcy. Tworzy to spójny zapis po wysyłce bez konieczności ręcznego sprawdzania każdej witryny przewoźnika.
Integracja powinna uwzględniać zamówienia z wieloma paczkami. Jedno zamówienie klienta może generować kilka numerów przesyłek, a każda paczka może przemieszczać się z inną prędkością. Model danych powinien zatem obsługiwać relację zamówienie–przesyłka, zamiast zakładać, że jedno zamówienie zawsze obejmuje jedną paczkę.
2. Zarządzanie wyjątkami
Zdarzenia związane z normalnym przemieszczaniem są przydatne, ale to zdarzenia wyjątkowe zazwyczaj tworzą największą wartość operacyjną. Mogą obejmować próby doręczenia, problemy związane z adresem, zatrzymania celne, zwroty do nadawcy lub długie okresy bez nowego skanu. Dokładne etykiety i znaczenia zależą od przewoźnika i usługi, dlatego zespoły fulfillment powinny starannie mapować statusy, zamiast traktować każde nieznane zdarzenie jako błąd.
Praktyczny proces może przypisywać kategorie wyjątków różnym właścicielom. Obsługa klienta może zajmować się problemem z dostawą dotyczącym odbiorcy. Magazyn może badać nieprawidłowy adres lub rozbieżność przy wysyłce. Zespół transportowy lub opiekun klienta może analizować powtarzający się problem z przewoźnikiem. API śledzenia dostarcza zdarzenie, ale dostawca fulfillment nadal potrzebuje zasad dotyczących odpowiedzialności, eskalacji i rozwiązania problemu.
3. Powiadomienia dla klientów i sprzedawców
Dane śledzenia mogą zasilać powiadomienia e-mail, SMS, portalowe lub markowe powiadomienia o statusie zamówienia. Komunikat powinien opierać się na znaczącej zmianie statusu, a nie na każdym surowym skanie. Wysyłanie powiadomienia dla każdego zdarzenia niskiego poziomu może generować szum, szczególnie gdy przewoźnicy tworzą wiele aktualizacji w krótkich odstępach.
Dostawca obsługujący sprzedawców e-commerce powinien również rozdzielać język wewnętrzny i zewnętrzny. Wewnętrzne zdarzenie, takie jak kod wyjątku przewoźnika, może być przydatne specjaliście ds. operacji, ale niezrozumiałe dla kupującego. System może zachować oryginalne zdarzenie na potrzeby audytu, jednocześnie przedstawiając klientowi prostsze wyjaśnienie.
4. Proaktywne procesy wsparcia
Zespoły wsparcia często potrzebują informacji o przesyłce przed udzieleniem odpowiedzi klientowi. Integracja śledzenia może umieszczać najnowsze zdarzenie, czas zdarzenia, przewoźnika, usługę i link do śledzenia obok rekordu zamówienia. Ogranicza to konieczność wyszukiwania informacji w wielu systemach i pomaga konsultantom unikać nieaktualnych lub zbyt kategorycznych wyjaśnień dotyczących dostawy.
Proces powinien uwzględniać granicę dowodową. Dane śledzenia mogą pokazywać, co zgłosił przewoźnik; nie zawsze mogą potwierdzić fizyczną lokalizację paczki między skanami ani zagwarantować przyszłego terminu dostawy. Język kierowany do klienta powinien odzwierciedlać to rozróżnienie.
5. Raportowanie operacyjne
Z czasem znormalizowane zdarzenia śledzenia mogą wspierać raporty dotyczące pierwszych skanów, odstępów między przemieszczeniami, wyjątków doręczeń, zwrotów i nierozwiązanych przesyłek. Raporty te są bardziej użyteczne, gdy dostawca zachowuje odpowiednie wymiary, takie jak przewoźnik, usługa, region docelowy, magazyn, sprzedawca i data wysyłki.
Raportowanie nie powinno przekształcać niekompletnych danych śledzenia w fałszywą precyzję. Niektóre przesyłki mogą mieć opóźnione skany, ograniczone szczegóły zdarzeń lub charakterystyczne dla przewoźnika zachowanie statusów. Dobry pulpit wskazuje zakres i aktualność danych oraz pozwala użytkownikom sprawdzić podstawowy rekord przesyłki.
Praktyczna architektura śledzenia dla fulfillment
Integracja z API śledzenia zwykle znajduje się pomiędzy systemami operacyjnymi dostawcy fulfillment a warstwą danych przewoźników. Dokładna architektura zależy od istniejącej technologii dostawcy, ale poniższe elementy warto zaplanować wprost:
- Przyjęcie przesyłki: podczas utworzenia paczki lub przekazania jej przewoźnikowi zapisz numer przesyłki, przewoźnika, usługę, identyfikator zamówienia, identyfikator sprzedawcy, miejsce docelowe i znacznik czasu wysyłki.
- Identyfikacja przewoźnika: używaj wiarygodnego kodu przewoźnika lub procesu mapowania. Nie zakładaj, że wzorzec numeru przesyłki zawsze wystarcza, szczególnie gdy sprzedawcy korzystają z usług regionalnych, konsolidatorów lub międzynarodowych przekazań.
- Zarządzanie żądaniami API: weryfikuj dane wejściowe, chroń dane uwierzytelniające, obsługuj przekroczenia czasu, zapisuj identyfikatory żądań i określ zachowanie ponowień. Ponowienia nie powinny tworzyć zduplikowanych rekordów ani niepotrzebnego ruchu.
- Normalizacja zdarzeń: mapuj zdarzenia właściwe dla przewoźnika na kontrolowany wewnętrzny słownik, zachowując oryginalny status, opis, znacznik czasu i źródło.
- Zarządzanie stanem: przechowuj bieżący stan przesyłki i historię zdarzeń oddzielnie. Bieżący stan obsługuje szybkie widoki operacyjne, a historia wspiera audyty i analizy.
- Kanały dostarczania: określ, które systemy otrzymują aktualizacje, na przykład system zarządzania magazynem, system zarządzania zamówieniami, portal sprzedawcy, help desk, platforma analityczna lub usługa powiadomień.
- Monitorowanie: mierz błędy API, opóźnione aktualizacje, nierozpoznanych przewoźników, zduplikowane zdarzenia, nieaktualne przesyłki i opóźnienia przetwarzania.
Dostawcy powinni potwierdzić w aktualnej dokumentacji wybranego API zachowanie odpowiednich endpointów, obsługiwanych przewoźników, metodę uwierzytelniania, limity, definicje statusów i opcje powiadomień. Oficjalna strona 17TRACK Tracking API oraz dokumentacja dla deweloperów są odpowiednimi punktami wyjścia do oceny, jak usługa śledzenia wielu przewoźników może pasować do tej architektury.
Polling, webhooki czy model łączony?
Metoda integracji wpływa zarówno na aktualność danych, jak i na projekt systemu. W przypadku pollingu dostawca prosi API o aktualizację w zaplanowanych odstępach. Polling jest łatwy do zrozumienia, ale harmonogram musi uwzględniać liczbę przesyłek, oczekiwaną aktywność przewoźników, limity API i znaczenie biznesowe przesyłki.
W przypadku powiadomień o zdarzeniach lub webhooków dostawca otrzymuje aktualizację, gdy usługa śledzenia zgłosi zmianę. Może to ograniczyć niepotrzebne żądania, ale system odbierający musi być przygotowany na wielokrotne dostarczenie, zdarzenia w niewłaściwej kolejności, tymczasowe awarie oraz procedury ponownego odtworzenia lub odzyskiwania. Webhooka nie należy traktować jako dowodu trwałego przetworzenia zdarzenia przez bazę dostawcy, dopóki wiadomość nie zostanie zweryfikowana i zapisana.
Wiele środowisk fulfillment korzysta z modelu łączonego. Zdarzenia mogą zapewniać terminowe aktualizacje, a zaplanowane uzgadnianie może wykrywać pominięte wiadomości lub przesyłki, które nie zmieniły się w oczekiwanym czasie. Właściwy wybór zależy od udokumentowanych możliwości API oraz tolerancji dostawcy na opóźnienia i złożoność operacyjną.
Jak bezpiecznie normalizować statusy przewoźników
Normalizacja statusów jest jedną z najważniejszych decyzji projektowych. Prosta wewnętrzna taksonomia może obejmować informacje otrzymane, w transporcie, w doręczeniu, doręczono, wyjątek oraz statusy związane ze zwrotem. Taksonomia powinna być wystarczająco szeroka, aby działać u różnych przewoźników, ale na tyle szczegółowa, by uruchamiać użyteczne działania.
Unikaj usuwania szczegółów właściwych dla przewoźnika podczas normalizacji. Ogólna etykieta „wyjątek” może pomóc w przekierowaniu sprawy, ale oryginalny opis i kod zdarzenia mogą być potrzebne do wsparcia, roszczeń, kontroli celnej lub eskalacji do przewoźnika. Przechowuj zarówno znormalizowany status, jak i zdarzenie źródłowe.
Znaczenie ma również obsługa czasu. Zachowuj znacznik czasu zdarzenia, strefę czasową lub przesunięcie, jeśli są dostępne, oraz czas, w którym platforma fulfillment otrzymała aktualizację. Są to różne wartości. Ich pomieszanie może prowadzić do mylących raportów dotyczących szybkości dostawy lub opóźnienia aktualizacji.
Lista kontrolna monitorowania API dla operatorów magazynów
Monitorowanie powinno obejmować coś więcej niż sprawdzenie, czy endpoint API jest dostępny. Dostawca fulfillment może stosować następujące kontrole:
- Uwierzytelnianie: generuj alerty dotyczące wygasłych, unieważnionych lub błędnie skonfigurowanych danych uwierzytelniających.
- Powodzenie żądań: śledź wskaźniki błędów według endpointu, przewoźnika, konta i okresu.
- Aktualność danych: identyfikuj przesyłki, których ostatnia aktualizacja jest starsza niż próg operacyjny dla danej usługi.
- Pokrycie: wykrywaj numery przesyłek, których nie można powiązać z przewoźnikiem lub zamówieniem.
- Przetwarzanie: monitoruj głębokość kolejki, zduplikowane zdarzenia, nieudane transformacje i błędy zapisu do bazy danych.
- Wpływ biznesowy: łącz incydenty techniczne z opóźnionymi powiadomieniami, nierozwiązanymi wyjątkami lub obciążeniem zespołu wsparcia.
Progi alertów powinny być powiązane ze zobowiązaniami usługowymi dostawcy i typami przesyłek. Krótkie opóźnienie może być akceptowalne dla przesyłki krajowej o niskim priorytecie, ale niedopuszczalne dla pilnego zamówienia międzynarodowego. Uniwersalne progi zapisane na stałe mogą powodować zbyt wiele alertów lub przeoczenie problemów.
Bezpieczeństwo, prywatność i zarządzanie danymi
Integracje śledzenia mogą ujawniać identyfikatory zamówień, informacje o odbiorcach, adresy i dane operacyjne. Dostęp powinien być ograniczony do systemów i pracowników, którzy go potrzebują. Dane uwierzytelniające należy przechowywać bezpiecznie, rotować zgodnie z polityką bezpieczeństwa dostawcy oraz usuwać z logów i kodu źródłowego.
Dostawca powinien również określić zasady przechowywania danych. Historia zdarzeń może być cenna dla wsparcia i uzgadniania, ale bezterminowe przechowywanie każdego pola może powodować niepotrzebne ryzyko związane z prywatnością i zarządzaniem danymi. Udokumentuj, jakie dane są przechowywane, gdzie są przechowywane, kto może uzyskać do nich dostęp oraz jak rekordy są usuwane lub anonimizowane, gdy jest to właściwe.
Etapowy plan wdrożenia
Etapowe wdrożenie zwykle daje lepsze rezultaty niż jednoczesne podłączanie każdego przewoźnika, magazynu i kanału powiadomień.
- Określ cel biznesowy: zacznij od konkretnego problemu, takiego jak ograniczenie ręcznego wyszukiwania przesyłek lub kierowanie wyjątków dotyczących dostawy.
- Wybierz reprezentatywny zestaw przesyłek: uwzględnij kluczowych przewoźników i usługi dostawcy, miejsca docelowe oraz scenariusze z wieloma paczkami.
- Zbuduj model danych: przed utworzeniem pulpitów ustal identyfikatory, mapowania statusów, znaczniki czasu, historię zdarzeń i zasady odpowiedzialności.
- Przetestuj przypadki awarii: uwzględnij nieprawidłowe numery przesyłek, opóźnione skany, zduplikowane zdarzenia, zmiany przewoźnika, przekroczenia czasu API i częściowe rekordy przesyłek.
- Zweryfikuj rozwiązanie z zespołami operacyjnymi: zapytaj zespoły magazynowe, wsparcia, sprzedawców i technologii, czy zwracane informacje wspierają rzeczywiste decyzje.
- Rozszerzaj ostrożnie: dodawaj przewoźników i procesy dopiero po zapewnieniu niezawodnego monitorowania i uzgadniania w początkowej integracji.
W przypadku dostawców obsługujących międzynarodowych sprzedawców, operacje e-commerce z wieloma przewoźnikami lub złożone sieci fulfillment głównym kryterium wyboru powinno być dopasowanie operacyjne. API śledzenia jest użyteczne, gdy jego dane można połączyć z istniejącymi identyfikatorami, procesami i procedurą eskalacji dostawcy. Liczba dostępnych funkcji ma mniejsze znaczenie niż to, czy integracja dostarcza wiarygodnych informacji w miejscu, w którym potrzebują ich pracownicy i klienci.
FAQ
Czym jest API do śledzenia przesyłek?
API do śledzenia przesyłek to interfejs programowy, który pozwala systemowi przesyłać szczegóły przesyłki i programowo pobierać informacje o śledzeniu. Dostawca fulfillment może używać go do łączenia zdarzeń przewoźników z procesami magazynowymi, zarządzaniem zamówieniami, wsparciem, powiadomieniami i raportowaniem.
Czy jedno API może obsługiwać wielu przewoźników?
Niektóre usługi śledzenia zapewniają dostęp do wielu przewoźników, ale obsługiwani przewoźnicy, usługi, pola danych i warunki integracji muszą zostać potwierdzone w aktualnej dokumentacji dostawcy. Pokrycie należy przetestować względem przewoźników i tras, z których rzeczywiście korzysta firma fulfillment.
Czy dostawcy fulfillment powinni używać pollingu czy webhooków?
Odpowiedź zależy od udokumentowanych opcji API i wymagań dostawcy dotyczących aktualności danych. Webhooki mogą wspierać przetwarzanie sterowane zdarzeniami, a polling może zapewniać zaplanowane kontrole. Podejście łączone może być właściwe, gdy dostawca potrzebuje zarówno terminowych aktualizacji, jak i uzgadniania pominiętych zdarzeń.
Jak należy mapować statusy przewoźników?
Mapuj zdarzenia źródłowe na kontrolowany wewnętrzny słownik, ale zachowuj oryginalny status przewoźnika, opis, kod i znacznik czasu. Pozwala to zachować szczegóły na potrzeby analizy, a jednocześnie zapewnia spójne kierowanie spraw, pulpity i komunikację z klientem.
Co należy przetestować przed uruchomieniem?
Przetestuj prawidłowe i nieprawidłowe numery przesyłek, wiele paczek w jednym zamówieniu, opóźnione skany, zduplikowane aktualizacje, wyjątki, zwroty, niezgodności przewoźników, błędy uwierzytelniania, przekroczenia czasu i odzyskiwanie po awarii systemu. Potwierdź również, że komunikaty kierowane do klientów nie obiecują więcej, niż wynika z danych śledzenia.