Come i fornitori di magazzinaggio e gestione degli ordini possono utilizzare le API di tracciamento delle spedizioni
I fornitori di servizi di magazzinaggio e fulfillment possono utilizzare le API di tracciamento delle spedizioni per collegare gli eventi dei vettori ai flussi di lavoro del magazzino, della gestione degli ordini e del servizio clienti. Il valore pratico non consiste semplicemente nel visualizzare un numero di tracking. Un'integrazione ben progettata trasforma gli aggiornamenti dei vettori in segnali operativi utilizzabili: un ordine può essere monitorato dopo la spedizione, le eccezioni possono essere indirizzate al team corretto, i clienti possono ricevere informazioni più chiare sulla consegna e le prestazioni del fulfillment possono essere analizzate utilizzando dati di spedizione coerenti.
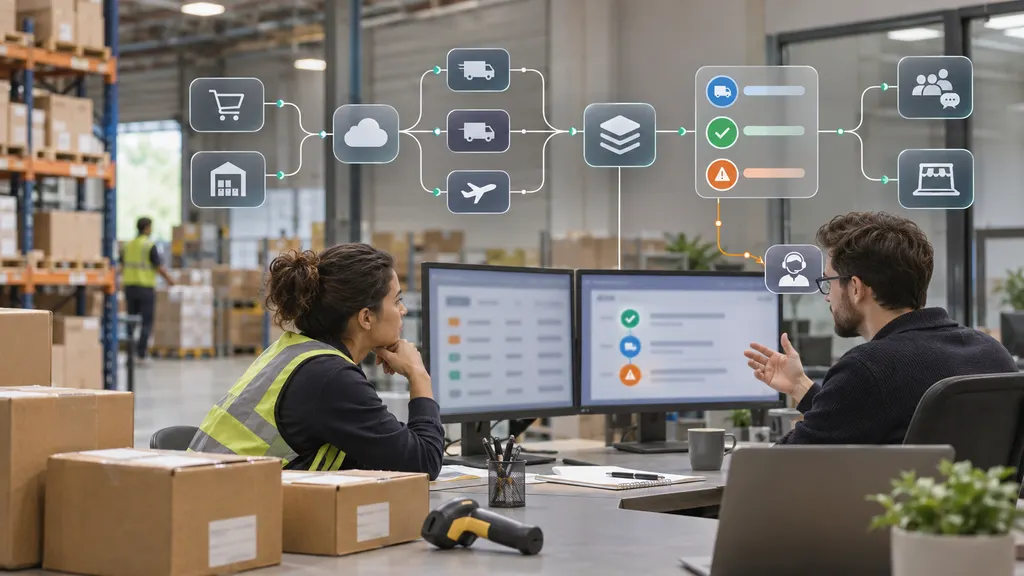
Per un magazzino o un fornitore di logistica conto terzi, l'approccio migliore consiste nel considerare il tracking come un servizio dati condiviso, anziché come una pagina autonoma rivolta ai clienti. L'API dovrebbe raccogliere gli eventi delle spedizioni, normalizzare le informazioni provenienti da più vettori, conservare i dati originali del vettore e rendere disponibile lo stato corretto al personale di magazzino, ai merchant, ai team di assistenza e ai destinatari.
Perché i dati di tracking sono importanti dopo la spedizione dell'ordine
Il processo di magazzino non termina quando un pacco lascia l'edificio. Dopo la consegna al vettore, il fornitore potrebbe dover rispondere a domande operative come:
- La spedizione è stata accettata dal vettore?
- Ha superato la prima scansione?
- È in ritardo, trattenuta, restituita o in attesa di un'azione?
- Quali ordini richiedono l'attenzione del servizio clienti?
- Alcuni vettori, servizi, destinazioni o sedi di fulfillment stanno generando eccezioni ricorrenti?
Senza un flusso di lavoro di tracking connesso, i team possono affidarsi ai portali dei vettori, a fogli di calcolo, ricerche manuali o messaggi di stato incoerenti. Ciò rende più difficile distinguere un normale intervallo tra scansioni da una spedizione che richiede realmente un intervento. Un'API non elimina la necessità di valutazioni operative, ma può rendere disponibili le informazioni pertinenti nei sistemi in cui vengono prese le decisioni.
Casi d'uso comuni del fulfillment per un'API di tracking
1. Visibilità automatica dopo la spedizione
Un fornitore di fulfillment può inviare i numeri di tracking e i dettagli del vettore a un'API di tracking quando un ordine viene contrassegnato come spedito. Le informazioni sulla spedizione restituite possono quindi essere associate all'ordine, al pacco, al cliente e alla sede di fulfillment nei sistemi interni del fornitore. In questo modo si crea un registro coerente post-spedizione senza richiedere al personale di controllare manualmente il sito di ogni vettore.
L'integrazione dovrebbe tenere conto degli ordini con più pacchi. Un singolo ordine cliente può generare diversi numeri di tracking e ogni pacco può avanzare a una velocità diversa. Il modello dati dovrebbe quindi supportare una relazione ordine-spedizione, anziché presumere che un ordine abbia sempre un solo pacco.
2. Gestione delle eccezioni
Gli eventi di movimentazione ordinaria sono utili, ma gli eventi di eccezione generano solitamente il maggior valore operativo. Gli esempi possono includere tentativi di consegna, problemi relativi all'indirizzo, blocchi doganali, restituzioni al mittente o periodi prolungati senza una nuova scansione. Le etichette e i significati esatti dipendono dal vettore e dal servizio, quindi i team di fulfillment dovrebbero mappare attentamente gli stati, invece di considerare ogni evento non familiare come un errore.
Un flusso di lavoro pratico può assegnare le categorie di eccezione a responsabili diversi. Il servizio clienti può gestire un problema di consegna rivolto al destinatario. Il magazzino può verificare un indirizzo errato o una discrepanza nella spedizione. Un team di trasporto o account può esaminare un problema ricorrente del vettore. L'API di tracking fornisce l'evento; il fornitore di fulfillment deve comunque definire le regole relative a responsabilità, escalation e risoluzione.
3. Notifiche a clienti e merchant
I dati di tracking possono supportare notifiche via e-mail, SMS, portale o notifiche di stato dell'ordine personalizzate con il brand. Il messaggio dovrebbe basarsi su un cambiamento di stato significativo, anziché su ogni scansione grezza. Inviare una notifica per ogni evento di basso livello può creare rumore, soprattutto quando i vettori generano diversi aggiornamenti ravvicinati.
Un fornitore che serve merchant e-commerce dovrebbe inoltre separare il linguaggio interno da quello esterno. Un evento interno, come un codice di eccezione del vettore, può essere utile a uno specialista operativo ma confondere un acquirente. Il sistema può conservare l'evento originale per garantire la tracciabilità, presentando al contempo una spiegazione più chiara rivolta al cliente.
4. Flussi di lavoro proattivi per l'assistenza
I team di assistenza spesso necessitano delle informazioni sulla spedizione prima di rispondere a un cliente. Un'integrazione di tracking può visualizzare l'ultimo evento, l'ora dell'evento, il vettore, il servizio e il link di tracking accanto al record dell'ordine. Ciò riduce la necessità di cercare tra sistemi diversi e aiuta gli operatori a evitare spiegazioni sulla consegna obsolete o eccessivamente categoriche.
Il flusso di lavoro dovrebbe includere un limite probatorio. I dati di tracking possono mostrare ciò che il vettore ha segnalato; non possono sempre dimostrare la posizione fisica di un pacco tra due scansioni né garantire un futuro orario di consegna. Il linguaggio rivolto al cliente dovrebbe riflettere questa distinzione.
5. Reporting operativo
Nel tempo, gli eventi di tracking normalizzati possono supportare report sulle prime scansioni, sugli intervalli di movimentazione, sulle eccezioni di consegna, sui resi e sulle spedizioni irrisolte. Questi report sono più utili quando il fornitore conserva le dimensioni pertinenti, come vettore, servizio, area di destinazione, magazzino, merchant e data di spedizione.
Il reporting non dovrebbe trasformare dati di tracking incompleti in una falsa precisione. Alcune spedizioni possono presentare scansioni ritardate, dettagli limitati sugli eventi o comportamenti di stato specifici del vettore. Una buona dashboard indica l'ambito e l'aggiornamento dei dati e consente agli utenti di esaminare il record della spedizione sottostante.
Un'architettura pratica per il tracking nel fulfillment
Un'integrazione con un'API di tracking si colloca normalmente tra i sistemi operativi del fornitore di fulfillment e il livello dati dei vettori. L'architettura esatta dipende dalla tecnologia esistente del fornitore, ma è utile pianificare esplicitamente i seguenti componenti:
- Acquisizione della spedizione: acquisire il numero di tracking, il vettore, il servizio, l'identificativo dell'ordine, l'identificativo del merchant, la destinazione e il timestamp della spedizione quando il pacco viene creato o consegnato.
- Identificazione del vettore: utilizzare un codice del vettore o un processo di mappatura affidabile. Non presumere che il formato del numero di tracking sia sempre sufficiente, in particolare quando i merchant utilizzano servizi regionali, consolidatori o passaggi internazionali.
- Gestione delle richieste API: convalidare gli input, proteggere le credenziali, gestire i timeout, registrare gli identificativi delle richieste e definire il comportamento dei nuovi tentativi. I retry dovrebbero evitare di creare record duplicati o traffico non necessario.
- Normalizzazione degli eventi: mappare gli eventi specifici del vettore in un vocabolario interno controllato, conservando al contempo lo stato, la descrizione, il timestamp e la fonte originali.
- Gestione dello stato: conservare separatamente lo stato attuale della spedizione e la cronologia degli eventi. Lo stato attuale supporta visualizzazioni operative rapide; la cronologia supporta audit e indagini.
- Canali di consegna: decidere quali sistemi ricevono gli aggiornamenti, come un sistema di gestione del magazzino, un sistema di gestione degli ordini, un portale merchant, un help desk, una piattaforma di analisi o un servizio di notifica.
- Monitoraggio: misurare gli errori API, gli aggiornamenti ritardati, i vettori non associati, gli eventi duplicati, le spedizioni obsolete e la latenza di elaborazione.
I fornitori dovrebbero verificare il comportamento degli endpoint pertinenti, i vettori supportati, il metodo di autenticazione, i limiti, le definizioni degli stati e le opzioni di notifica nella documentazione aggiornata dell'API selezionata. La pagina ufficiale 17TRACK Tracking API e la relativa documentazione per sviluppatori rappresentano punti di partenza adeguati per valutare come un servizio di tracking multi-vettore possa integrarsi in questa architettura.
Polling, webhook o un modello combinato?
Il metodo di integrazione influisce sia sull'aggiornamento dei dati sia sulla progettazione del sistema. Con il polling, il fornitore chiede all'API un aggiornamento a intervalli programmati. Il polling è semplice da comprendere, ma la pianificazione deve tenere conto del volume delle spedizioni, dell'attività prevista dei vettori, dei limiti dell'API e dell'importanza commerciale della spedizione.
Con le notifiche degli eventi o i webhook, il fornitore riceve un aggiornamento quando il servizio di tracking segnala un cambiamento. Ciò può ridurre le richieste non necessarie, ma il sistema ricevente deve essere progettato per gestire consegne duplicate, eventi fuori ordine, errori temporanei e procedure di riproduzione o recupero. Un webhook non dovrebbe essere considerato una prova che il database del fornitore abbia elaborato definitivamente un evento finché il messaggio non è stato convalidato e memorizzato.
Molti ambienti di fulfillment utilizzano un modello combinato. Gli eventi possono supportare aggiornamenti tempestivi, mentre controlli di riconciliazione programmati verificano la presenza di messaggi persi o di spedizioni che non sono cambiate entro un intervallo previsto. La scelta corretta dipende dalle funzionalità documentate dell'API e dalla tolleranza del fornitore rispetto alla latenza e alla complessità operativa.
Come normalizzare in sicurezza gli stati dei vettori
La normalizzazione degli stati è una delle decisioni progettuali più importanti. Una tassonomia interna semplice potrebbe includere informazioni ricevute, in transito, in consegna, consegnato, eccezione e stati relativi al reso. Tale tassonomia dovrebbe essere sufficientemente ampia da funzionare con vettori diversi, ma abbastanza specifica da attivare azioni utili.
Evitare di eliminare i dettagli specifici del vettore durante la normalizzazione. Un'etichetta generica come “eccezione” può aiutare a instradare un caso, ma la descrizione e il codice dell'evento originale possono essere necessari per l'assistenza, i reclami, le verifiche doganali o l'escalation al vettore. Conservare sia lo stato normalizzato sia l'evento di origine.
Anche la gestione dell'orario è importante. Conservare il timestamp dell'evento, il fuso orario o l'offset quando disponibili e l'ora in cui la piattaforma di fulfillment ha ricevuto l'aggiornamento. Si tratta di valori diversi. Confonderli può generare report fuorvianti sulla velocità di consegna o sulla latenza degli aggiornamenti.
Checklist di monitoraggio API per gli operatori di magazzino
Il monitoraggio dovrebbe coprire più del semplice raggiungimento dell'endpoint API. Un fornitore di fulfillment può utilizzare i seguenti controlli:
- Autenticazione: avvisare in caso di credenziali scadute, revocate o configurate in modo errato.
- Esito delle richieste: monitorare i tassi di errore per endpoint, vettore, account e periodo di tempo.
- Freschezza dei dati: individuare le spedizioni il cui ultimo aggiornamento è più vecchio della soglia operativa prevista per quel servizio.
- Copertura: rilevare i numeri di tracking che non possono essere associati a un vettore o a un ordine.
- Elaborazione: monitorare la profondità delle code, gli eventi duplicati, le trasformazioni non riuscite e gli errori di scrittura nel database.
- Impatto commerciale: collegare gli incidenti tecnici alle notifiche ritardate, alle eccezioni irrisolte o al carico di lavoro dell'assistenza.
Le soglie degli avvisi dovrebbero essere collegate agli impegni di servizio del fornitore e ai tipi di spedizione. Un breve ritardo può essere accettabile per un pacco nazionale a bassa priorità, ma inaccettabile per un ordine internazionale urgente. Soglie universali definite rigidamente nel codice possono generare troppi avvisi oppure problemi non rilevati.
Sicurezza, privacy e governance dei dati
Le integrazioni di tracking possono esporre identificativi degli ordini, informazioni sui destinatari, indirizzi e dati operativi. L'accesso dovrebbe essere limitato ai sistemi e al personale che ne hanno bisogno. Le credenziali devono essere conservate in modo sicuro, ruotate secondo la policy di sicurezza del fornitore e mantenute fuori dai log e dal codice sorgente.
Il fornitore dovrebbe inoltre definire le regole di conservazione. La cronologia degli eventi può essere utile per l'assistenza e la riconciliazione, ma conservare ogni campo indefinitamente può creare rischi inutili per la privacy e la governance. Documentare quali dati vengono conservati, dove vengono conservati, chi può accedervi e come i record vengono rimossi o anonimizzati quando opportuno.
Un piano di implementazione graduale
Un'implementazione graduale produce solitamente risultati migliori rispetto al collegamento simultaneo di ogni vettore, magazzino e canale di notifica.
- Definire il risultato aziendale: iniziare da un problema specifico, come la riduzione delle ricerche manuali di tracking o l'instradamento delle eccezioni di consegna.
- Scegliere un insieme rappresentativo di spedizioni: includere i vettori, i servizi, le destinazioni e gli scenari con più pacchi importanti per il fornitore.
- Creare il modello dati: stabilire identificativi, mappature degli stati, timestamp, cronologia degli eventi e regole di responsabilità prima di creare le dashboard.
- Testare i casi di errore: includere numeri di tracking non validi, scansioni ritardate, eventi duplicati, cambi di vettore, timeout API e record di spedizione parziali.
- Convalidare con le operations: chiedere ai team di magazzino, assistenza, merchant e tecnologia se le informazioni restituite supportano decisioni reali.
- Espandere con cautela: aggiungere vettori e flussi di lavoro dopo che l'integrazione iniziale dispone di un monitoraggio e di una riconciliazione affidabili.
Per i fornitori che servono merchant internazionali, attività e-commerce multi-vettore o reti di fulfillment complesse, il principale criterio di selezione dovrebbe essere l'idoneità operativa. Un'API di tracking è utile quando i suoi dati possono essere collegati agli identificativi, ai flussi di lavoro e al processo di escalation esistenti del fornitore. Il numero di funzionalità disponibili conta meno della capacità dell'integrazione di produrre informazioni affidabili nel punto in cui il personale e i clienti ne hanno bisogno.
FAQ
Che cos'è un'API di tracking delle spedizioni?
Un'API di tracking delle spedizioni è un'interfaccia software che consente a un sistema di inviare i dettagli della spedizione e recuperare le informazioni di tracking tramite programmazione. Un fornitore di fulfillment può utilizzarla per collegare gli eventi dei vettori ai flussi di lavoro del magazzino, degli ordini, dell'assistenza, delle notifiche e dei report.
Una singola API può supportare più vettori?
Alcuni servizi di tracking sono progettati per fornire accesso a più vettori, ma i vettori, i servizi, i campi dati e le condizioni di integrazione supportati devono essere verificati nella documentazione aggiornata del fornitore. La copertura dovrebbe essere testata rispetto ai vettori e alle rotte effettivamente utilizzati dall'attività di fulfillment.
I fornitori di fulfillment dovrebbero utilizzare il polling o i webhook?
La risposta dipende dalle opzioni documentate dell'API e dai requisiti di aggiornamento del fornitore. I webhook possono supportare un'elaborazione basata sugli eventi, mentre il polling può fornire controlli programmati. Un approccio combinato può essere appropriato quando il fornitore necessita sia di aggiornamenti tempestivi sia della riconciliazione degli eventi persi.
Come devono essere mappati gli stati dei vettori?
Mappare gli eventi di origine in un vocabolario interno controllato, conservando però lo stato, la descrizione, il codice e il timestamp originali del vettore. Ciò preserva i dettagli necessari alle indagini, consentendo al contempo un instradamento, dashboard e comunicazioni ai clienti coerenti.
Che cosa deve essere testato prima del lancio?
Testare numeri di tracking validi e non validi, più pacchi per ordine, scansioni ritardate, aggiornamenti duplicati, eccezioni, resi, discrepanze dei vettori, errori di autenticazione, timeout e recupero dopo un'interruzione del sistema. Verificare inoltre che i messaggi rivolti ai clienti non promettano più di quanto i dati di tracking possano supportare.