Comment réconcilier les mises à jour Webhook manquées avec l’interrogation périodique de l’API : un guide pratique de synchronisation hybride
Utilisez des webhooks pour les mises à jour rapides et interrogez périodiquement l’API afin de vérifier si votre enregistrement d’expédition local correspond toujours à celui du prestataire. Le modèle fiable consiste à stocker durablement les livraisons de webhooks, à effectuer une réconciliation avec l’API à l’aide d’identifiants d’expédition stables et à appliquer les deux voies via la même logique de mise à jour idempotente. L’interrogation peut réparer les changements d’état manqués, mais elle ne peut pas reconstituer les événements intermédiaires, sauf si l’API expose réellement l’historique des événements.
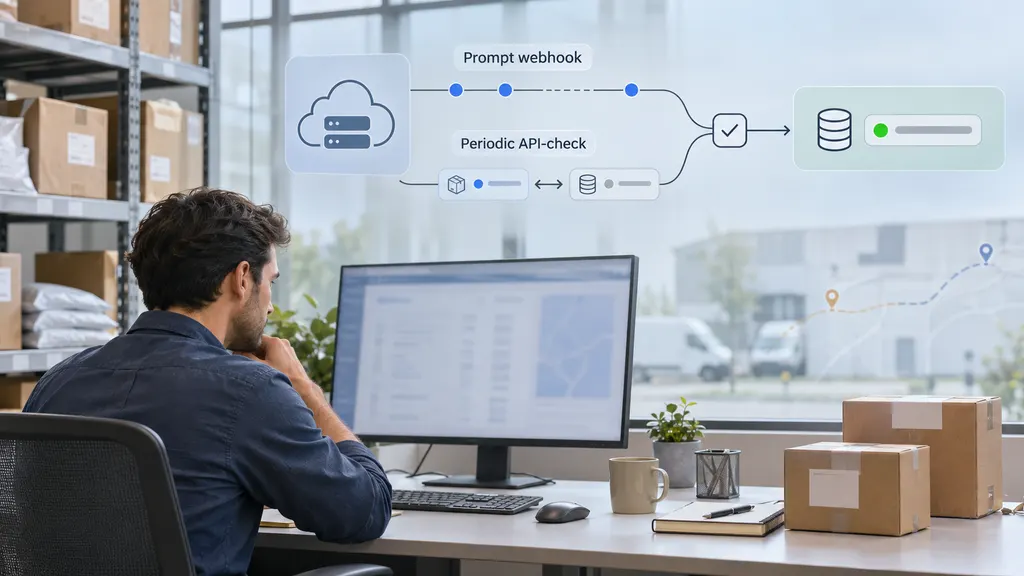
Ce guide s’adresse aux ingénieurs et aux équipes opérationnelles responsables de la synchronisation d’un système de gestion des commandes, d’une page de suivi ou d’une interface de support client avec les données d’expédition. Sa règle centrale est simple : considérez un webhook comme un signal indiquant qu’il faut examiner et traiter une modification, et non comme la preuve que toutes les modifications précédentes sont arrivées.
Définissez ce que signifie « synchronisé » avant de choisir un intervalle
Une intégration d’expédition peut devoir préserver deux éléments différents : l’état actuel, tel que « en transit » ou « livré », et l’historique des événements qui explique comment cet état a été atteint. La consultation d’une expédition auprès d’un prestataire peut renvoyer le dernier état, une liste d’événements de suivi, ou les deux. Ces formats d’API offrent des garanties de récupération différentes.
Si la consultation renvoie uniquement un instantané de l’état actuel, une interrogation de réconciliation peut corriger votre statut local après un webhook manqué. Elle ne peut pas prouver quels états intermédiaires se sont produits. Si l’API renvoie des événements historiques avec des identifiants ou des horodatages stables, l’interrogation peut également récupérer les entrées manquantes de la chronologie. Vérifiez le schéma réel de réponse du prestataire avant de promettre l’un ou l’autre résultat aux utilisateurs en aval.
Notez les champs que votre application doit réconcilier : identifiant d’expédition, transporteur ou identifiant de suivi, statut normalisé, statut du prestataire, heure de l’événement, heure de la dernière mise à jour du prestataire, détails de livraison et tout champ utilisé pour déclencher des messages aux clients. Séparez les champs faisant autorité chez le prestataire de ceux gérés localement, comme une note de dossier interne. Une tâche de réconciliation ne doit pas écraser les données propres au système local simplement parce qu’elles sont absentes d’une réponse d’API.
Créez un seul chemin de traitement pour les résultats des webhooks et des interrogations
Les gestionnaires de webhooks et les processus d’interrogation ne doivent pas appliquer des règles concurrentes pour les changements de statut. Les deux doivent produire une observation normalisée et la transmettre à une seule fonction de réconciliation. Cette fonction valide l’identité, compare l’observation avec l’expédition enregistrée, écrit une mise à jour sûre et indique pourquoi la modification a été effectuée.
- Recevoir et authentifier. Validez un webhook à l’aide du mécanisme documenté par le prestataire. Rejetez les requêtes qui échouent à la validation, mais conservez suffisamment d’informations de diagnostic non sensibles pour enquêter sur les problèmes de livraison.
- Persister avant d’accuser réception. Placez une livraison valide dans un stockage durable ou une file d’attente avant de renvoyer un succès. Une réponse HTTP réussie envoyée avant la persistance crée une lacune qu’une nouvelle tentative du prestataire pourrait ne pas réparer.
- Normaliser. Mappez la charge utile du prestataire ou la réponse d’API vers une structure interne commune tout en conservant les valeurs originales du prestataire à des fins d’analyse.
- Réconcilier. Utilisez une clé d’expédition stable et une règle d’idempotence pour empêcher les entrées en double dans la chronologie, les notifications répétées et les écritures inutiles.
- Auditer le résultat. Notez si l’observation a modifié l’expédition, était déjà connue, était antérieure à l’état enregistré ou nécessite une vérification manuelle.
Un identifiant d’événement du prestataire est utile pour la déduplication s’il existe et reste stable. Dans le cas contraire, une clé composite peut être nécessaire, mais ses composants doivent correspondre au modèle de données du prestataire. Deux scans légitimes peuvent partager un statut et un horodatage ; une clé construite uniquement à partir de ces champs pourrait donc supprimer un événement réel. Conservez la charge utile brute ou une référence vers celle-ci pendant une durée de conservation définie afin de pouvoir examiner les correspondances ambiguës.
Concevez la boucle d’interrogation en fonction du risque, et non autour d’un minuteur global unique
Interroger toutes les expéditions connues à la même fréquence gaspille des requêtes et peut exercer une pression sur les limites de l’API. Maintenez un ensemble d’expéditions pouvant faire l’objet d’une réconciliation et sélectionnez-les en fonction du risque opérationnel. Une expédition nouvellement enregistrée qui n’a reçu aucune première mise à jour, une expédition ayant récemment subi un échec de traitement de webhook et une expédition dont le statut n’a pas changé dans le délai attendu peuvent nécessiter des calendriers différents. Une expédition terminée peut ne nécessiter qu’une vérification finale limitée, selon l’importance des corrections tardives pour votre application.
Choisissez un intervalle en partant du délai maximal pendant lequel votre activité peut tolérer un statut local incorrect. Tenez compte du délai de file d’attente, du temps de requête, des nouvelles tentatives et de la capacité des processus ; l’intervalle d’interrogation n’est pas à lui seul le délai de récupération. Ajoutez une temporisation aléatoire afin que de nombreuses expéditions ne deviennent pas exigibles au même instant. Si le prestataire documente des limites de requêtes ou propose une consultation par lots, intégrez ces contraintes au lieu de supposer qu’une conception fonctionnant lors d’un petit test pourra évoluer sans modification.
Séparez le suivi administratif du planificateur de l’état du prestataire. Des champs tels que last_poll_attempt_at, last_successful_poll_at, next_poll_at et last_webhook_received_at répondent à des questions différentes. En particulier, une tentative d’interrogation qui expire ne doit pas faire avancer le marqueur de dernière interrogation réussie.
Lorsque l’API prend en charge les requêtes conditionnelles, un curseur de modification documenté ou un filtre updated-since, vérifiez si cela réduit les transferts inutiles sans masquer de données. HTTP définit le comportement des requêtes conditionnelles, notamment la réponse 304 Not Modified, mais une intégration ne doit l’utiliser que si le point de terminaison concerné la prend en charge et si sa sémantique est claire. Un curseur n’est pas interchangeable avec un horodatage : vérifiez ce qu’il ordonne, s’il est associé à un compte ou à une expédition et comment il se comporte lorsque les résultats sont paginés.
Réconciliez sans annuler une mise à jour plus récente
La course la plus courante est simple : une interrogation démarre, puis un webhook plus récent arrive, et l’interrogation renvoie un instantané plus ancien. Si le résultat de l’interrogation est écrit en dernier sans comparaison, l’expédition locale revient en arrière. Évitez cela en vérifiant l’heure de l’événement ou la version du prestataire lorsqu’elles sont fiables, et en rendant la comparaison et l’écriture atomiques pour chaque expédition.
Ne supposez pas que l’heure d’arrivée reflète l’ordre des événements. Un webhook livré en retard peut décrire un scan plus ancien, tandis qu’une réponse d’API ultérieure peut contenir une correction d’un événement précédemment signalé. Définissez des règles distinctes pour l’insertion dans la chronologie et la sélection de l’état actuel. Par exemple, un ancien scan peut appartenir à l’historique sans remplacer le statut actuel. Une correction du prestataire peut nécessiter la modification d’un événement enregistré plutôt que l’ajout d’un autre. La règle correcte dépend des identifiants, des horodatages et des signaux de révision fournis par le prestataire.
Si le prestataire ne fournit aucune version ni aucun champ d’ordre fiable, soyez prudent. Comparez l’intégralité de l’enregistrement renvoyé avec l’enregistrement local, signalez les contradictions et évitez de considérer un libellé de statut comme une règle d’ordre universelle. « Exception », « en cours de livraison » et « livré » ne forment pas toujours une séquence linéaire simple, notamment lorsqu’un transporteur corrige ultérieurement un scan. Conservez les valeurs brutes du prestataire à côté de tout statut normalisé afin qu’une personne puisse examiner les cas incertains.
Les effets secondaires nécessitent la même rigueur que le stockage. Une interrogation qui découvre le statut « livré » ne doit pas envoyer une deuxième notification de livraison si un webhook en a déjà déclenché une. Rendez les notifications et les tâches en aval idempotentes au moyen d’une clé métier durable, comme un identifiant d’expédition associé à une transition définie ou à un identifiant d’événement du prestataire. Une mise à jour de base de données et une notification externe ne peuvent généralement pas être traitées comme une seule opération automatique ; un outbox transactionnel ou un enregistrement de travail durable équivalent peut contribuer à garantir qu’une modification validée est suivie d’une seule tentative contrôlée de traitement de son effet secondaire.
Exécutez un rattrapage limité après une panne
L’interrogation régulière ne remplace pas une procédure de récupération explicite. Lorsqu’un point de terminaison webhook, une file d’attente ou un processus a été indisponible, identifiez d’abord la période et l’ensemble d’expéditions concernés. Incluez les expéditions actives pendant la panne, et pas seulement celles actuellement marquées comme actives : l’une d’elles peut avoir atteint un état terminal pendant que les mises à jour étaient manquées.
Commencez le rattrapage suffisamment avant l’échec présumé pour tenir compte des retards de livraison et de l’incertitude concernant l’heure de détection. Ce chevauchement rétraite volontairement certaines données connues ; l’idempotence rend cette approche plus sûre que le maintien d’une lacune. Traitez les résultats par lots gérables, suivez durablement la progression et conservez les éléments échoués pour une nouvelle tentative. Ne faites pas progresser un point de contrôle de rattrapage simplement parce qu’une page a été demandée. Faites-le uniquement après le traitement des enregistrements de la page ou leur enregistrement explicite comme non résolus.
Si l’API propose la pagination, vérifiez son ordre et son comportement de continuation avant d’utiliser un numéro de page ou un curseur comme point de contrôle de récupération. Si elle propose uniquement des instantanés par expédition, construisez la liste des expéditions concernées à partir de vos propres enregistrements et réconciliez-les individuellement. Documentez la limite de cette méthode : les statuts actuels obtenus peuvent être corrects même si certains scans intermédiaires restent indisponibles.
Testez les cas d’échec que vous prévoyez de réparer
Un plan de test utile va au-delà de l’envoi d’un webhook et de la vérification d’une réponse d’API. Testez les livraisons de webhooks en double, l’arrivée d’un webhook plus ancien après un webhook plus récent, l’arrivée d’une réponse d’interrogation après un webhook, les échecs partiels de l’API, les redémarrages de processus et un plantage entre l’enregistrement de l’état de l’expédition et la planification d’une notification. Vérifiez à la fois l’enregistrement d’expédition visible et le journal des effets secondaires.
Testez également un rattrapage de panne comportant plus d’enregistrements qu’un seul lot ne peut en contenir. Vérifiez que le redémarrage de la tâche répète sans risque une petite quantité de travail au lieu d’ignorer des enregistrements. Lorsque l’API renvoie des événements historiques, testez si le même scan apparaît dans les formats webhook et interrogation, et si votre règle de déduplication le reconnaît. Lorsque l’API renvoie uniquement des instantanés, vérifiez que votre interface ne présente pas un événement intermédiaire déduit comme un scan observé du transporteur.
La surveillance opérationnelle doit distinguer trois signaux : l’état de livraison des webhooks, l’état des interrogations et l’actualité des données. Les mesures utiles comprennent l’ancienneté de la dernière réconciliation réussie pour les expéditions éligibles, le nombre de divergences non résolues, l’âge de la file d’attente, les taux d’erreur de l’API et la taille du retard de récupération. Un point de terminaison webhook sain ne suffit pas à établir que l’état local des expéditions est à jour.
Appliquez ce guide à une API de suivi
Pour une intégration de suivi des expéditions, commencez par les identifiants, les charges utiles de webhook, les réponses de consultation des expéditions, les exigences d’authentification et les contraintes de requêtes documentés par le prestataire. Si vous utilisez l’API de suivi de 17TRACK, consultez sa documentation officielle de l’API avant d’implémenter le processus d’interrogation. Confirmez les mécanismes de consultation et de mise à jour disponibles pour votre intégration au lieu de supposer que chaque compte ou point de terminaison prend en charge la relecture historique, le rattrapage basé sur un curseur ou les requêtes conditionnelles.
La décision d’implémentation n’est pas « webhooks ou interrogation ». Utilisez les webhooks pour réduire la latence normale des mises à jour, l’interrogation pour détecter et corriger les divergences que l’API disponible peut révéler, et une procédure de rattrapage explicite pour les incidents. Indiquez la limite de récupération dans votre manuel d’exploitation : le système peut-il restaurer le statut actuel, l’historique des événements ou les deux ? Cette limite détermine si une mise à jour manquée entraîne une vue obsolète de courte durée ou une lacune permanente dans l’enregistrement.
FAQ
L’interrogation peut-elle garantir qu’aucun événement de suivi ne sera manqué ?
Non. Une consultation de l’état actuel peut révéler que le dernier statut a changé, mais elle ne peut pas récupérer un événement intermédiaire que l’API ne renvoie pas. La récupération d’événements historiques nécessite un historique disponible et un moyen fiable d’identifier ou de comparer ses entrées.
Un webhook doit-il déclencher une interrogation immédiate de l’API ?
Uniquement lorsque la consultation de l’API ajoute une information dont votre application a besoin ou lorsque le webhook est intentionnellement une notification de modification plutôt qu’un enregistrement complet. Interroger l’API après chaque webhook peut créer des requêtes redondantes. Si le webhook contient des données suffisamment fiables, traitez-le directement et réservez les vérifications de l’API à la réconciliation planifiée ou à une enquête ciblée.
Que faire si l’interrogation de l’API et le webhook sont en désaccord ?
Comparez les horodatages, versions, identifiants et significations des charges utiles du prestataire avant de sélectionner un état actuel. Conservez les deux observations. Si le prestataire ne fournit aucun signal d’ordre fiable et que le désaccord affecte une action importante, signalez l’expédition pour examen au lieu de choisir silencieusement la réponse arrivée en dernier.
Quand faut-il arrêter les interrogations pour une expédition livrée ?
Appliquez une politique documentée fondée sur l’importance, pour votre application, des corrections tardives du transporteur, des détails de preuve de livraison ou des processus en aval. Un statut semblant terminal ne suffit pas à établir que le prestataire ne mettra plus jamais l’enregistrement à jour.
Comment le processus d’interrogation doit-il gérer la limitation du débit ?
Réduisez la pression exercée par les requêtes, réessayez avec une temporisation progressive et respectez l’en-tête Retry-After lorsque le serveur en fournit un. Donnez la priorité aux expéditions nécessitant le plus une récupération au lieu de réessayer toutes les expéditions simultanément. La sémantique HTTP définit la réponse 429 Too Many Requests et le champ Retry-After ; les limites propres à chaque point de terminaison doivent néanmoins être vérifiées dans la documentation du prestataire.
Sources
- RFC 9110 : Sémantique HTTP — requêtes conditionnelles,
304 Not Modified,429 Too Many RequestsetRetry-After. - API de suivi 17TRACK — référence officielle du produit pour les intégrations de suivi des expéditions.
- Documentation de l’API 17TRACK — référence officielle pour vérifier le comportement des points de terminaison et les exigences d’intégration.